1 Zettabyte Corresponde A

Entendendo o zettabyte na prática
Se você trabalha com infraestrutura de dados, já se pegou olhando para uma cifra como 1 ZB e pensou "como é que eu vou dimensionar isso?". A resposta curta é que você não dimensiona na mão. A resposta longa envolve converter tudo para bytes, comparar com o que você já conhece e entender por que esse número aparece em relatórios de grandes provedores de nuvem. Em binário, alguns fornecedores ainda usam a convenção onde 1 ZiB (zebibyte) = 2^70 bytes, o que dá aproximadamente 1.18 quintilhão de bytes. A diferença é pequena na teoria, mas vai causar dor de cabeça real em orçamentos de storage se você não ficar de olho nessa distinção entre decimal (SI) e binário (IEC). O padrão moderno, aceito pela maioria dos fabricantes de disco e pelos relatórios do IDC, é a forma decimal pura: um bilhão de gigabytes, ou um milhão de terabytes. Para colocar em perspectiva, 1 ZB é mais ou menos o volume total de dados que o Google processou em um único ano por volta de 2022. Não é uma quantidade que você consegue armazenar num Data Center pequeno. São necessárias dezenas de navios porta-contêineres cheios de fitas magnéticas, se pensarmos em mídia offline.
Como converter 1 ZB para outras unidades
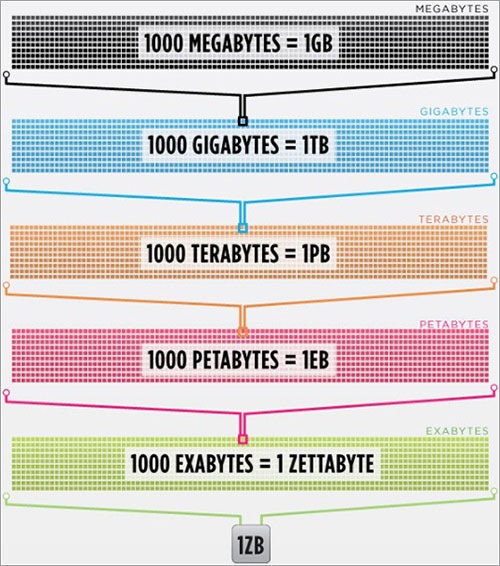
Aqui está a conta, sem enrolação: 1 ZB = 1.000 EB (exabytes) 1 ZB = 1.000.000 PB (petabytes)
1 ZB = 1.000.000.000 TB (terabytes) 1 ZB = 1.000.000.000.000 GB (gigabytes) 1 ZB = 1.000.000.000.000.000 MB (megabytes)
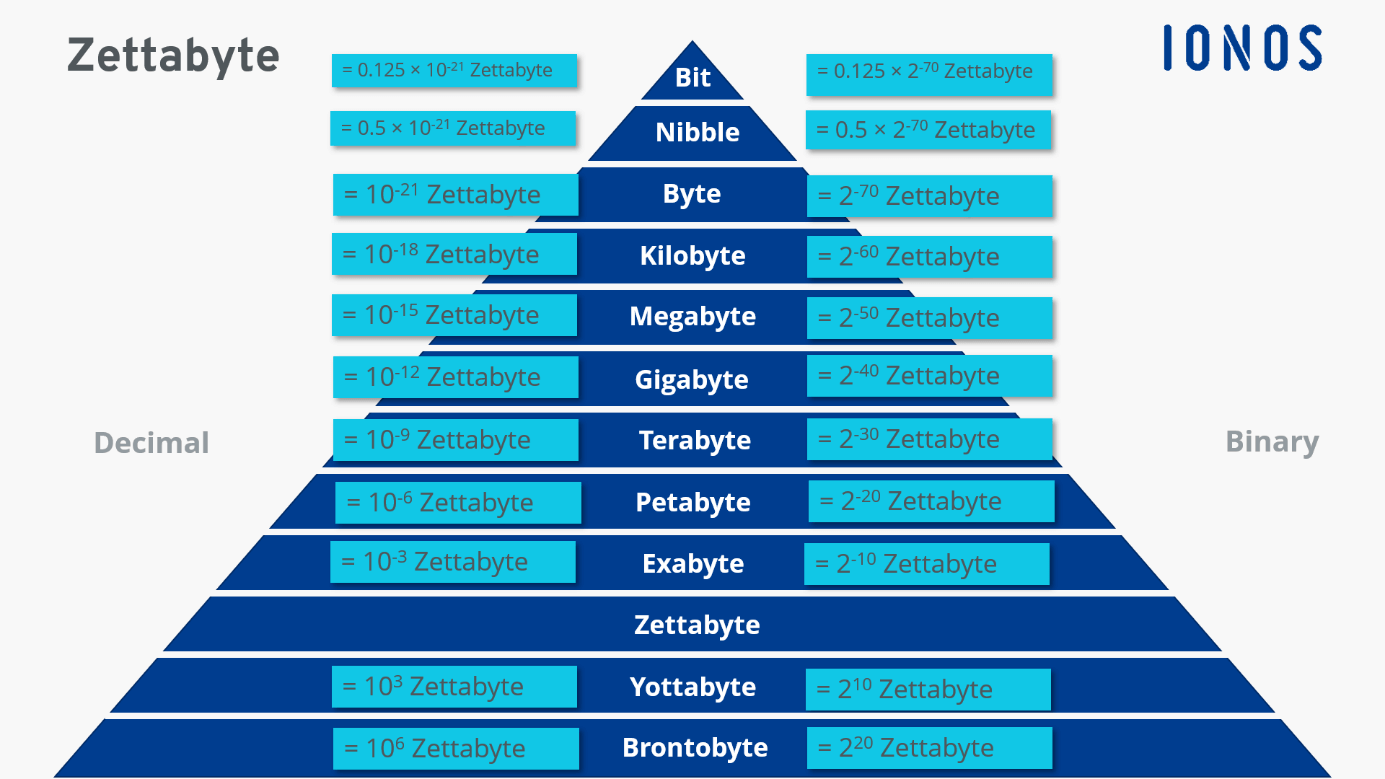
1 ZB = 1.000.000.000.000.000.000 KB (quilobytes) 1 ZB = 1.000.000.000.000.000.000.000 bytes Se quiser a versão binária (zebibyte), multiplique por 1,18 na frente de cada unidade. O resto segue a mesma lógica de potências de 2.
O problema que ninguém conta sobre escalas desse tamanho
Eu gerenciei um projeto de migração de 150 PB para um cliente de mídia. O relatório dizia que o volume total deles chegaria a 1,2 ZB em cinco anos. A parte que os vendedores de storage nunca mencionam: a taxa de escrita sustentada (SWrite) em escalas assim não é lineares. Quando você tenta escrever em alta velocidade em disco HDD, o overhead de seek time, fragmentação e metadata management transforma aquele hardware teoricamente capaz de 300 MB/s por drive em algo que, em array grande, entrega talvez 40 a 60 MB/s por drive quando o workload é aleatório. A workaround que funcionou foi simples, mas custou caro em planejamento. Paramos de tratar o armazenamento como um problema de capacidade pura e passamos a tratar como um problema de throughput. Usamos tiering automático: SSD NVMe para os dados quentes (primeiros 90 dias de vida útil), HDD para cold storage, e fita LTO-9 para arquivamento de longo prazo. O resultado foi que o custo por terabyte armazenado caiu de U$ 35/TB/ano para cerca de U$ 8/TB/ano, mas esse ganho só apareceu depois de três meses de ajuste fino nas políticas de retenção e classificação automática dos dados. Outro ponto que pega todo mundo: a contagem de "1 ZB" raramente significa 1 ZB de dados efetivos. Inclui snapshots, replicação síncrona, metadados, redundância erasure coding e, dependendo do vendor, até dados órfãos que ninguém apaga. Um cluster com 800 TB de capacidade bruta pode, após o overhead, oferecer menos de 500 TB de espaço utilizável para o aplicativo. Se seu cálculo de crescimento baseia-se no espaço utilizável e não no bruto, você compra hardware demais ou de menos.
Quando usar a convenção binária vs. decimal
Sistemas operacionais e muitas ferramentas de monitoramento (como o `lsblk`, `fdisk` e o `df` configurado em modo binário) mostram os discos no formato IEC. Um disco de 10 TB comercial vai aparecer como 9,09 TiB no Linux. Em escala de ZB, essa discrepância é de quase 18%. Se você está montando um data center e o CFO quer saber quantos ZBs vão ser consumidos, use a convenção decimal. Se você está rodando scripts de automação que precisam detectar o espaço real no cluster, use a convenção binária. Misturar as duas no mesmo documento é a causa mais comum de divergência em reuniões de planejamento de capacidade. 1. Supor que backup = armazenamento primário Um cliente meu achava que 1 ZB de dados gerados por ano caberiam em 1 ZB de storage de backup. Esqueceu que o ciclo de retenção de 7 anos, com retenção incremental e diferenciais, multiplicava o volume real em 4x. O plano precisou ser redesenhado com deduplicação em nível de bloco (ganhou ~3,2x de redução) e política de expurgo automático que deletou petabytes de logs de auditoria obsoletos.

2. Não considerar a taxa de compressão real No papel, compressão de dados estruturados pode atingir 2:1. Na prática, com tabelas de banco de dados com colunas JSON e logs de aplicação, a taxa real frequentemente cai para 1,3:1 ou até 1,1:1. Eu vi um projeto que orçou armazenamento baseado em compressão teórica de 2,5:1. A realidade foi 1,4:1. O orçamento estourou em 78%. 3. Desprezar a sobrecarga da replicação geo-distribuída
Duplos sites com replicação síncrona significam 2x de capacidade bruta. Triplos sites, 3x. Para 1 ZB efetivo, você precisa de 2 a 3 ZBs de capacidade física instalada, sem contar o espaço para DR, testing e dados de desenvolvimento. Esse é o erro mais caro que eu já vi alguém cometer. A diferença entre 1 ZB teórico e 1 ZB operacional em produção multi-site é abismal.
Resumo direto
1 ZB é 10^21 bytes. É uma unidade de medida útil para gigantes de cloud, provedores de telecomunicações e governos que gerenciam exabytes por dia. Se você é uma empresa menor, dificilmente vai lidar com essa magnitude no curto prazo, mas entender a conversão e os armadilhas por trás dela vai economizar horas de reunião e milhões em compras equivocadas de hardware.

Galeria
-

Zettabyte – Tecnología Hecha Palabra -
¿Cuánto es un zettabyte? – Un Poco Geek
