A Alguns Modos De Conceber A Linguagem Seja Como Representacao

Como funciona na prática a concepção da linguagem como representação
A maioria das pessoas que trabalha com processamento de linguagem natural acaba esbarrando em alguma versão dessa ideia, mesmo sem perceber. Conceber a linguagem seja como representação significa tratar texto, fala e significado como objetos que podem ser mapeados, transformados e recuperados dentro de um sistema. Não é uma teoria elegante de livro — é algo que você precisa resolver quando o modelo falha na hora certa. Existem abordagens diferentes e elas não são equivalentes. A mais comum em produção é a representação vetorial: você converte palavras, frases ou documentos em tensores e opera sobre eles. O que muita gente não considera na prática é que a escolha do espaço vetorial define completamente o que o sistema consegue ou não fazer. Um embedding treinado em notícias jornalísticas vai se comportar de forma radicalmente diferente de um treinado em fóruns técnicos ou medicinais. Eu aprendi isso na marra quando precisei fazer recuperação de documentos clínicos e um modelo genérico simplesmente ignorava termos técnicos porque a distribuição de frequência deles era irrelevante no corpus de treinamento. Outra abordagem é a representação simbólica, aquela que vem da lógica formal e da linguística computacional clássica. Árvores de dependência, frames semânticos, ontologias. Isso ainda é útil em contextos onde você precisa de rastreabilidade absoluta, como auditoria de decisões ou sistemas regulados. O problema é que a cobertura de linguagem natural nesses modelos é limitada — qualquer construção ambígua ou coloquial quebre a gramática formal e o sistema para de funcionar. Eu já vi projetos inteiros desmoronarem por causa disso quando o usuário começou a escrever de forma informal nos canais de suporte.
A representação estatística é o intermediário pragmático: n-gramas, modelos de linguagem tradicionais, TF-IDF com ponderação adequada. Funciona até certo ponto e é rápido de implementar. Mas a capacidade de generalização cai drasticamente fora do domínio de treino. Se você treinar em documentação técnica e depois receber perguntas de usuários comuns, o resultado será pior do que esperado porque a distribuição de tokens é completamente diferente. Os transformers introduziram representações contextuais densas que capturam múltiplas camadas de significado simultaneamente. A desvantagem não é discutida o suficiente: esses modelos exigem custos computacionais altos para inferência em tempo real e o comportamento de borda é imprevisível. Eu tive um caso específico em que um sistema de classificação de intentos funcionava bem em 97% dos casos, mas nos 3% restantes produzia classificações consistentemente erradas — não aleatoriamente, mas sistematicamente. Descobri que havia um padrão de construção sintática que o modelo associava erroneamente a uma classe porque aquele padrão era majoritário no treino. A correção envolveu adicionar exemplos adversariais ao dataset de validação e ajustando o threshold de confiança por classe. Quando você vai implantar qualquer uma dessas abordagens, o erro mais comum é subestimar a curadoria dos dados. Representação boa depende mais da qualidade do corpus do que da sofisticação do modelo. Eu recomendo começar pelo mapeamento dos casos de uso reais antes de escolher a arquitetura. Qual é a diversidade esperada de entrada? Qual é o custo de um erro falso positivo versus um falso negativo? Essas respostas determinam se vale a pena investir em representação contextual pesada ou se uma abordagem mais leve resolve.
Não existe soluzione que funcione em todos os cenários. Representações vetoriais puras falham quando a interpretabilidade é requisito. Representações simbólicas falham na flexibilidade linguística. Representações híbridas são o caminho mais viável na maioria dos casos práticos, mas exigem engineering mais sofisticado para manter a consistência entre os módulos. Se o seu problema é simples — classificação de texto, busca por similaridade básica — uma representação vetorial bem calibrada com fine-tuning no domínio específico basta. Se exige raciocínio estruturado, mantenha a camada simbólica como verificação pós-processamento.
Galeria
-

Esquema da representação de conceitos com uso de linguagem natural ... -

Figuras de Linguagem: o que são, quais são, exemplos e tipos - Significados -
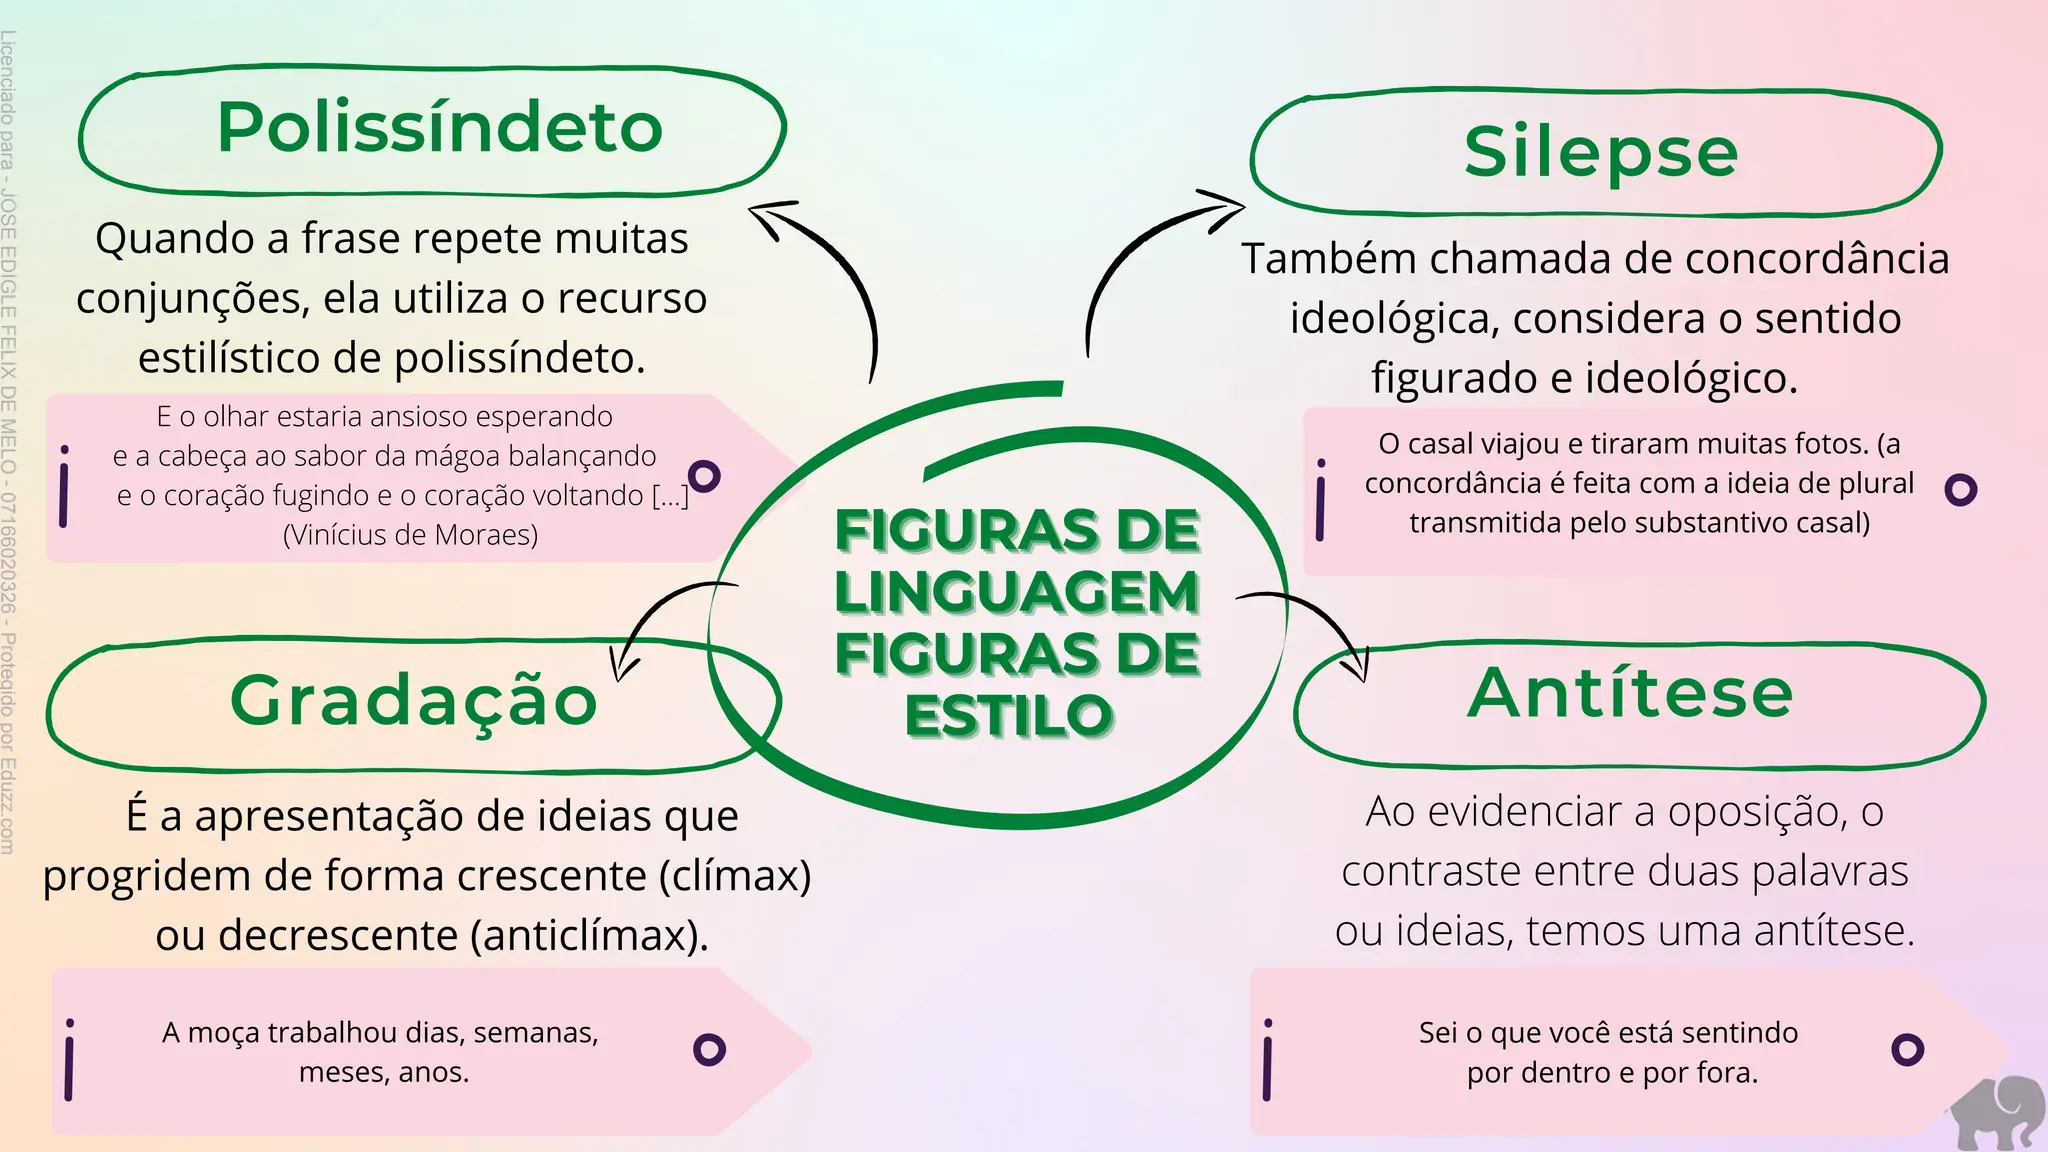
figuras-de-linguagem-figuras-de-estilo (1).pdf -
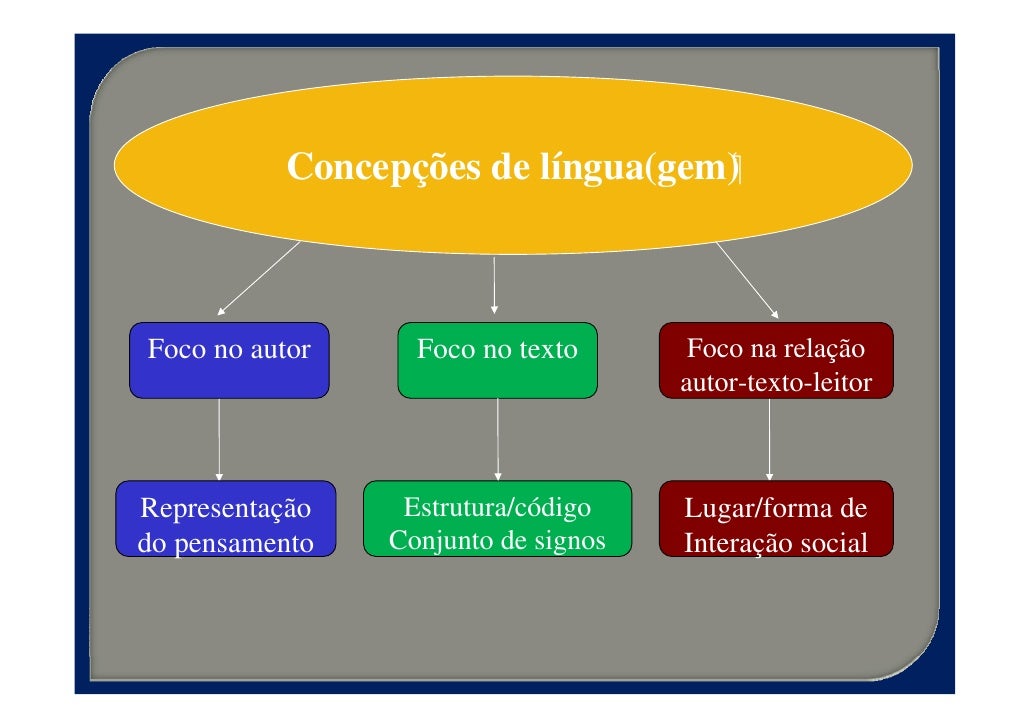
Quais São As Concepções De Linguagem? – PSVI
