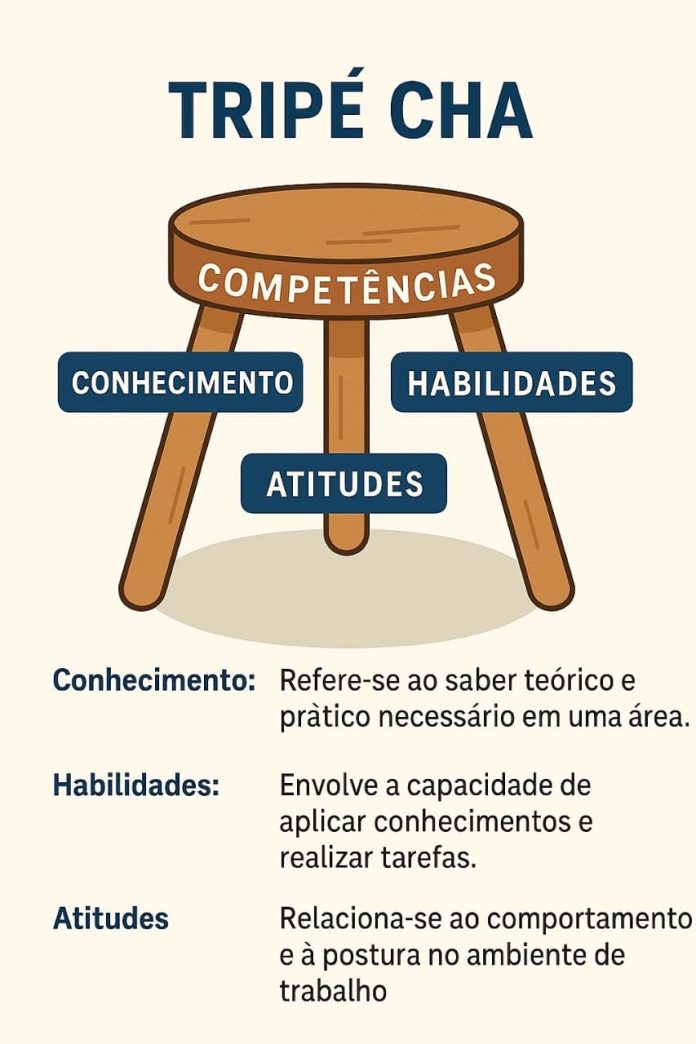
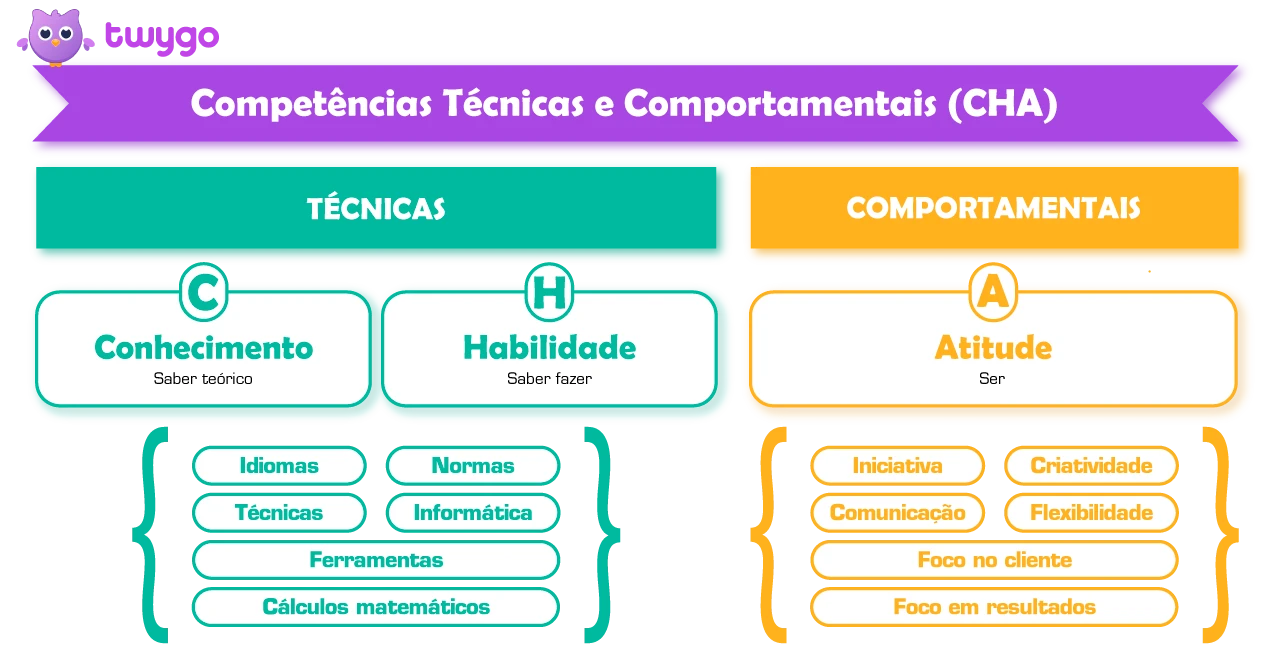
A Competência Frequentemente Descrita Pela Sigla Cha

O que é Arquitetura Harvard e por que ela existe
A arquitetura Harvard é um design de computador onde os dados e as instruções de programa vivem em memórias fisicamente separadas. Isso significa que o processador pode buscar uma instrução e acessar dados ao mesmo tempo, sem competir pela mesma estrada. A diferença prática é que você ganha throughput em ciclos de busca, e perde um pouco de flexibilidade no sistema operacional e na forma como aloca memória. Não confunda com a arquitetura von Neumann, onde instruções e dados compartilham o mesmo barramento e o mesmo espaço de endereçamento. A von Neumann é mais simples de implementar e dominar, mas sofre o chamado gargalo de von Neumann quando o processador precisa esperar dados ou instruções passarem pelo mesmo canal. A Harvard resolve isso separando os caminhos.
a competência frequentemente descrita pela sigla cha
Em muitos currículos de engenharia e concursos técnicos no Brasil, a competência frequentemente descrita pela sigla cha refere-se ao domínio prático sobre conceitos de hardware que envolve tanto a teoria da arquitetura Harvard quanto a capacidade de aplicar esses conceitos em projetos reais de microcontroladores, DSPs e sistemas embarcados. O que isso significa na prática é saber escolher entre memória unificada e memória dividida conforme o constraints do sistema, e ser capaz de explicar por que um STM32 ou um PIC funciona melhor com separação de espaços de endereço quando o processamento de sinal exige latência previsível. Eu já vi candidatos que sabiam decorar a diferença teórica, mas travavam quando perguntados sobre como o linker deveria organizar os segmentos .text e .data em um projeto embedded. A questão não é só saber que existem duas memórias; é saber como o compilador e o debugger interagem com essa separação no dia a dia.
Como a arquitetura Harvard funciona na prática
Vamos começar pelo básico operacional. Em uma implementação típica de Harvard, o processador tem dois barramentos distintos. Um leva instruções da memória de programa até o decodificador. Outro leva dados da memória de dados para registradores e periféricos. Como os caminhos são independentes, o ciclo de busca de instrução não bloqueia a leitura de variáveis, e vice-versa. O resultado imediato é que operações como multiplicação-acumulação, comuns em filtros digitais, podem acontecer sem que o pipeline seja interrompido para buscar a próxima instrução. Em arquiteturas puramente Harvard, isso permite throughput constante em loops críticos. Em versões híbridas, como as usadas em muitos microcontroladores modernos, a separação existe fisicamente, mas o software pode mapear regiões de memória de forma flexível usando tabelas de tradução ou bank switching. Um detalhe importante que poucos mencionam: a separação física não significa necessariamente que cada memória tenha o mesmo tamanho. Em muitos designs, a memória de programa é maior porque armazenam firmware, constantes e tabelas lookup. A memória de dados é menor porque só precisa suportar variáveis temporárias e pilha. Isso afeta diretamente a forma como você dimensiona projetos embutidos e como escreve código sensível a memória.

Implementação em microcontroladores reais
Se você for trabalhar com ARM Cortex-M, PIC, AVR ou DSPs TI, vai encontrar variações da arquitetura Harvard. Os ARM Cortex-M tradicionais usam uma memória unificada com barramento separado para acesso a instruções e dados, o que tecnicamente é uma Harvard modificada. Os DSPs da família TMS320, por outro lado, são Harvard puro em várias gerações, com barramentos múltiplos que permitem duas ou mais leituras simultâneas de dados e uma de instrução. O problema comum que eu encontrei em projetos reais aconteceu com um firmware de aquisição de dados rodando em um dsPIC. O código funcionava bem em simulação, mas na bancada o DMA corrompia buffers quando o controlador tentava acessar simultaneamente a região de programa e a de dados em certos momentos de clock. A solução não foi mudar a arquitetura, mas sim ajustar o mapeamento do linker para evitar sobreposição de regiões críticas e adicionar barriers de cache quando necessário. Demorou cerca de três dias para isolar o padrão de falha, porque o defeito só aparecia sob carga térmica e com variações de tensão de alimentação. Isso ilustra algo que livros costumam pular: a teoria da Harvard é limpa. A implementação exige atenção a cache, consistência de memória, e ao comportamento do hardware sob condições de borda. Se você está estudando para uma prova técnica ou preparando um projeto, trate a separação de memória como um recurso que precisa ser gerenciado, não como uma configuração que se esquece depois do primeiro boot.
Pitfalls e equívocos comuns
O erro mais frequente é assumir que Harvard é sempre melhor. Ela oferece performance previsível, mas impõe restrições sérias. Sistemas operacionais generalistas dependem de espaço de endereçamento unificado para loader dinâmico, shared libraries, e alocação flexível. Rodar Linux ou mesmo um RTOS pesado em uma Harvard pura exige camadas de abstração que aumentam complexidade e, em muitos casos, anulam parte do ganho de performance. Outro problema comum é a gestão de tabela de jump e endereçamento relativo. Em arquitetura von Neumann, um ponteiro pode apontar para qualquer região de memória. Em Harvard, você precisa tratar tabelas de vetores de interrupção, constantes de programa, e dados de operação como espaços distintos. Compiladores modernos abstraem isso com diretivas de seção e scripts de linker, mas se você escrever assembly ou usar ponteiros brutos, vai se dar mal rapidamente. Uma limitação real da abordagem é o custo de Silicon. Barramentos duplicados, controladores de memória independentes, e roteamento de PCB mais complexo encarecem o projeto. Para dispositivos de baixo custo onde volume e margem importam, a von Neumann ainda é a escolha racional. A Harvard brilha em aplicações onde latência determinística e throughput de processamento de sinal justificam o investimento.
O que você precisa saber para aplicar esse conhecimento
Se o seu objetivo é dominar o conteúdo cobrado em provas técnicas ou aplicar em projetos, foque nestes pontos práticos. Primeiro, entenda como o linker script organiza .text, .data, .bss, e seções específicas de memória de programa versus memória de dados. Segundo, saiba ler o datasheet de um microcontrolador e identificar onde estão os barramentos separados e como o DMA interage com eles. Terceiro, pratique depurar problemas de memória usando ferramentas como segfault analysis, watchpoints, e profiling de acesso a memória. Eu recomendo começar com um microcontrolador simples que exponha a separação claramente, como um AVR ou um PIC, e escrever code que acesse explicitamente registradores de memória de programa via tabelas de constante. Depois migre para um DSP e observe como o hardware gerencia múltiplos acessos simultâneos. A curva de aprendizado é mais suave quando você vê o comportamento no osciloscópio e no debugger, não apenas na documentação. Sobre recursos, a maioria dos fabricantes oferece application notes que cobrem mapeamento de memória e otimização de linker para suas famílias específicas. TI, Microchip, e ST têm material relevante. Livros de organização de computador tratam o assunto de forma teórica, então complementem com leitura de datasheets reais e testes práticos.
O campo não para. Arquiteturas modernas mesclam ideias de Harvard com cache coerente, memória unificada com partição lógica, e aceleradores especializados que ignoram a distinção tradicional. O que permanece constante é a necessidade de entender quando a separação física ajuda e quando ela cria fricção desnecessária. Se você conseguir responder a essa pergunta em contextos variados, a competência técnica exigida está consolidada.
Galeria
-

RH Criativo: O CHA da Competência -
Modelo CHA: entenda como aplicar na avaliação de competências -

Método Cha: O Que É E Como Aplicar O Tripé Das Competências – LYIKC
