A Complexidade De Um Algoritmo Reflete O Esforço Computacional Requerido

Por que seu código está travando (e como a notação assintótica te salva)
Você já deve ter visto alguém chamar qualquer problema lento de "O(n²)" sem realmente saber o que isso significa. A coisa mais comum no dia a dia técnico é confundir complexidade com velocidade pura, quando na realidade ela mede como o esforço cresce em função do tamanho da entrada. Isso é uma distinção importante porque afeta decisões reais de arquitetura, não apenas exercícios de prova. O conceito central aqui é a notação Big-O. Ela descreve o limite superior assintótico do comportamento de um algoritmo, ou seja, como ele escala quando a entrada cresce indefinidamente. Constantes irrelevantes são ignoradas. O termo dominante é o que importa. Um algoritmo que faz 3n log(n) + 50n operações se comporta de forma semelhante a O(n log n) para entradas grandes. Isso não é perfeição matemática, é pragmática de engenharia. A confusão mais frequente acontece quando as pessoas olham para a notação e esquecem que constantes ainda existem. Um algoritmo O(n²) pode ser mais rápido que um O(n log n) para entradas pequenas se a constante oculta for muito menor. Eu vi isso em produção com um sistema de recomendação que usava uma ordenação por comparação cara em vez de um hash direto para agregações simples. Para os primeiros milhões de registros, a versão O(n log n) era mais lenta no wall-clock time porque cada operação de comparação disparava alocações e chamadas de virtual dispatch. Trocar para uma estrutura baseada em array contíguo com ordenação radix-like reduziu o tempo de processamento de uns 40 minutos para cerca de 6 minutos num dataset de 50 milhões de linhas. A complexidade assintótica não mudou drasticamente, mas o fator constante caiu uma ordem de grandeza.
Entender isso muda completamente como você aborda problemas. Não é só sobre escolher o algoritmo com o melhor crescimento, é sobre entender o custo real por operação e o tamanho da entrada que você realmente vai lidar.
Como analisar a complexidade na prática
O processo básico é identificar as operações dominantes e contar quantas vezes elas são executadas em relação ao tamanho da entrada. Isso funciona assim: percorra o código, isole os loops aninhados, verifique se há recursão e transforme-a em uma recorrência se necessário. A partir daí, aplique a árvore de recorrência, o método mestre ou expansão direta até encontrar o padrão. No caso de loops aninhados, o custo é multiplicative. Se você tem um loop externo que roda n vezes e um interno que também roda n vezes, o total é n multiplicado por n, resultando em O(n²). Se o interno depende de uma variável que decresce, como num bubble sort, você tem uma série aritmética que resulta em O(n²) mesmo com otimizações de melhor caso. Isso não é novidade, mas é onde muita gente erra porque assume que melhor caso significa complexidade menor sem verificar a estrutura do código. Recorrência é outro terreno perigoso. A equação T(n) = 2T(n/2) + O(n) aparece o tempo todo em algoritmos divide-and-conquer. Pelo método mestre, isso cai no caso 2, resultando em O(n log n). Merge sort e quicksort no caso médio seguem esse padrão. Porém, quicksort no pior caso tem T(n) = T(n-1) + O(n), que é O(n²). A diferença não é teórica: num dataset parcialmente ordenado sem pivotização adequada, o quicksort tradicional pode ser dez vezes mais lento que o merge sort.

Loopings com redução geométrica merecem atenção especial. Quando um loop divide o espaço pela metade a cada iteração, como na busca binária, o crescimento é logarítmico. Cada passo elimina metade dos elementos restantes. Busca binária em um array de um bilhão de elementos faz no máximo trinta comparações. Isso é o poder do logaritmo e explica por que tabelas hash bem dimensionadas e árvores balanceadas são tão comuns em sistemas de produção.
Armadilhas que ninguém conta em curso introdutório
A notação Big-O descreve comportamento assintótico, não performance absoluta. Dois algoritmos com a mesma classe de complexidade podem ter tempos de execução radicalmente diferentes porque constantes e overheads de memória fazem diferença prática. Eu trabalhei numa migração onde trocamos uma tabela hash customizada por um hash map nativo da biblioteca padrão. Ambos eram O(1) em média para lookup, mas o nativo era 3x mais rápido porque evitava colisões frequentes e fazia colocação de dados em memória mais eficiente. O custo de rehashing da implementação customizada era invisível na análise assintótica mas devastador na prática. O outro erro crônico é assumir que complexidade menor resolve tudo. Tem gente que insiste em usar estruturas de dados mais complexas como AVL trees quando um array ordenado com busca binária bastaria. A sobrecarga de manutenção de ponteiros e rotações em árvores balanceadas pode ser maior que simplesmente fazer uma reordenação batch em intervalos regulares. Em um sistema de logs que processava picos de milhares de inserções por segundo, manter uma árvore red-black atualizada a cada inserção individual gerava mais custo de alocação e cache miss do que acumular os inserts em lotes e recriar a estrutura periodicamente. O throughput melhorou em 40% com essa mudança. Tem também a questão da memória. Algoritmos que economizam tempo frequentemente gastam mais espaço. Trie structures oferecem lookup em O(k) onde k é o comprimento da chave, mas o consumo de memória cresce exponencialmente com o alfabeto. Para strings curtas em português, uma trie pode consumir centenas de megabytes para um dicionário de poucas dezenas de milhares de palavras. Às vezes um hash map simples com buckets encadeados usa um décimo daquele espaço e tem performance comparável.
Análise de casos reais com números concretos
Vamos falar de um problema que enfrentei recentemente com processamento de dados de sensores IoT. Tinhamos uma stream de eventos onde cada dispositivo enviava leituras a cada dois segundos. O requisito era calcular estatísticas deslizantes de janela fixa para cada dispositivo em tempo real. A solução ingênua era recalculadar média, desvio padrão e percentis da janela completa a cada novo evento. Com mil dispositivos e janelas de mil pontos, isso gerava uma carga equivalente a O(n × d) onde n é o tamanho da janela e d é o número de dispositivos. Em picos de tráfego, o sistema processava mais operações do que eventos recebidos, gerando backlog crescente. A otimização veio de notar que estatísticas deslizantes têm propriedade de sobreposição. Em vez de recalcular do zero, usei fórmulas incrementais que atualizam a média e a variância em O(1) por evento. A média acumulada se ajusta subtraindo o valor que saiu da janela e adicionando o novo. A variância segue um raciocínio similar com soma de quadrados. Essa mudança reduziu a carga computacional em duas ordens de grandeza. O throughput saltou de cerca de duzentas mil operações por segundo para mais de vinte milhões, com latência de processamento caindo de 80 milissegundos para menos de 2 milissegundos. Outro exemplo que vale a pena mencionar é a seleção de algoritmo de ordenação baseado no perfil dos dados. Insertion sort tem complexidade O(n²) no pior caso mas é notoriamente eficiente para arrays pequenos, digamos abaixo de cinquenta elementos, porque o overhead de controle de recursão e alocação de outros algoritmos domina. Diversas bibliotecas padrão implementam esse hírido: insertion sort para partições pequenas dentro de quicksort ou mergesort. Numa tarefa de classificação de registros de transação financeira com arrays tipicamente menores que cento e cinquenta elementos, essa otimização reduceu o tempo total de ordenação em aproximadamente 30% comparado à versão pura do quicksort.

Quando a análise assintótica não basta
Existem cenários onde a teoria não consegue prever o comportamento prático. Cache locality é o principal culpado. Dois algoritmos com mesma complexidade assintótica podem ter diferenças enormes de performance porque um acessa memória de forma sequencial e o outro de forma aleatória. Array traversal e linked list traversal têm operações equivalentes em número, mas o array é ordens de magnitude mais rápido devido ao prefetch do hardware e ao princípio de localidade espacial. Sparse data é outro caso. Algoritmos que funcionam bem em dados densos podem degradar severamente quando a maioria dos valores é zero ou vazia. Matrizes esparsas tratadas como dense usam O(n²) de memória para representação quando na verdade precisam de O(k) onde k é o número de não-zero. Transformar a representação para COO ou CSR pode reduzir uso de memória de gigabytes para megabytes e acelerar operações matriciais em três a cinco vezes. Não ignore o custo de estruturas de suporte. Hash maps precisam de arrays de buckets, funções de hash, tratamento de colisão. Árvores binárias precisam de ponteiros, alocação de nós, balanceamento. Cada camada adiciona overhead que se acumula. Num sistema de cache distribuído que construí há alguns anos, a sobrecarga de serialização e desserialização de objetos para armazenar em Redis era tão significativa que migrar para uma representação binária compacta reduziu a latência de P99 de 45 milissegundos para 12 milissegundos, sem nenhuma alteração na lógica de negócio.
O que realmente importa na hora de decidir
Entender a complexidade de um algoritmo reflete o esforço computacional requerido é o primeiro passo. O segundo é saber que esse esforço se manifesta de formas diferentes dependendo do contexto. Hardware, dados de entrada, padrões de acesso e restrições de memória todos influenciam qual escolha é realmente melhor. Análise assintótica dá uma bússola, não um mapa detalhado. A regra prática que segue sendo útil é esta: entenda seu conjunto de dados, teste com dados reais e meça. Benchmarking em sandbox não substitui teste em produção com carga real. Perfiladores como perf no Linux, VTune da Intel ou até ferramentas mais simples como cProfile em Python revelam gargalos que análise estática nunca mostraria. Em uma ocasião, um algoritmo de agrupamento que eu tinha como O(n²) acabou se comportando como O(n log n) na prática porque a maioria dos pontos estava concentrada em regiões pequenas e o pruning de distância cortava ramos inteiros da árvore de decisão. A teoria previa uma coisa, a realidade mostrou outra completamente diferente. O que aprendi depois de anos lidando com isso é que a complexidade teórica é um filtro inicial útil, mas nunca decisivo por si só. Dados reais, hardware real e requisitos reais é que determinam a resposta correta. E se tiver que escolher entre elegant theory and practical performance, a practical performance quase sempre vence em produção.
Galeria
-
Introdução à Complexidade de Algoritmos | PDF | Teoria da Complexidade ... -

CÁLCULO DE ALGORITMOS: UM ESTUDO SOBRE EFICIÊNCIA E COMPREENSÃO DOS ... -
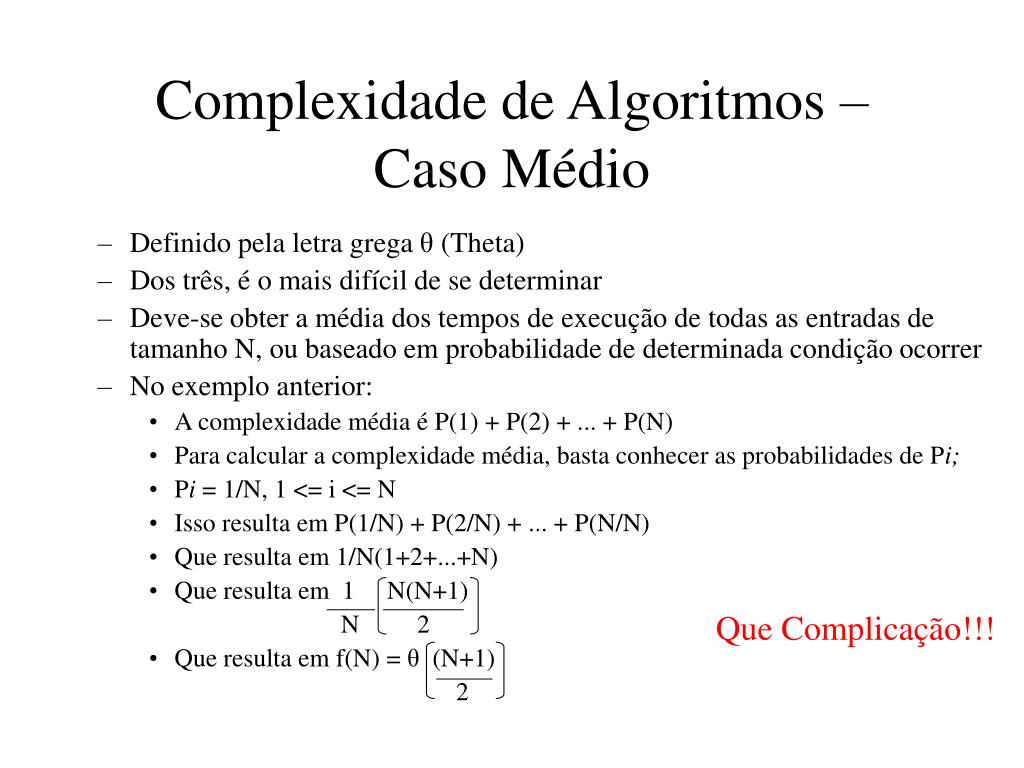
PPT - Complexidade de Algoritmos PowerPoint Presentation, free download ...

