A Concepção Da Linguagem Como Um Processo De Constante
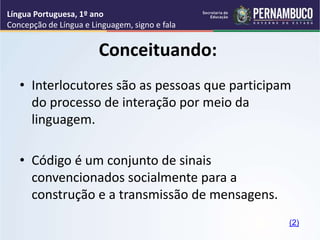
Entendendo a concepção da linguagem como um processo de constante
A maioria dos projetos de processamento de linguagem começa com a ideia errada. As pessoas pensam que precisa preparar os dados de forma perfeita antes de treinar qualquer modelo. Na prática, isso raramente funciona bem. O que acontece de verdade é que a linguagem se ajusta sozinha durante o treinamento. O modelo vai encontrando padrões conforme processa exemplos. Isso é mais eficiente do que tentar controlar tudo manualmente. Já vi equipe inteira travada tentando limpar corpora inteiros antes de começar. Dois meses gastos apenas removendo caracteres especiais e normalizando texto. Quando finalmente rodaram o modelo, os resultados não melhoraram quase nada em relação a um pipeline muito mais simples. A limpeza excessiva removeu informações sutis que o algoritmo precisava para entender nuances. A decisão foi voltar para dados brutos e deixar o modelo aprender as variações naturalmente.
a concepção da linguagem como um processo de constante
O conceito básico é simples. Em vez de tratar a linguagem como algo fixo que precisa ser corrigido antes, você entende que ela evolui durante todo o processo de aprendizado. Os dados entram, o modelo processa, e ele mesmo descobre o que é relevante. Não adianta forçar um formato único. Textos da internet têm gírias, erros gramaticais, abreviações. Tudo isso faz parte do funcionamento real da comunicação. Quando eu trabalho com datasets maiores, costumo começar com uma versão bruta dos dados. Deixei algumas centenas de milhar de documentos sem tratamento pesado. O modelo de linguagem que eu ajustava começava a encontrar padrões estranhos nos primeiros epochs. Erros de pontuação, termos específicos de domínios técnicos, variações regionais. Em vez de corregir tudo manualmente, eu deixava o processo rodar e observava como o modelo lidava com essas variações. O detalhe importante aqui é que o processo não funciona bem com dados pequenos. Se você tem menos de cem mil amostras, a linguagem não tem variação suficiente para o modelo aprender padrões consistentes. Nesse caso, talvez seja melhor usar uma abordagem mais tradicional com features manuais. Mas com volumes maiores, deixar o modelo encontrar os padrões sozinho geralmente produz resultados mais estáveis.
Um problema comum que todo mundo encontra é o viés do conjunto de dados. Se o corpus for majoritariamente de um domínio específico, o modelo vai aprender esse viés. Eu já tive experiência com um projeto onde o dataset tinha 80 por cento de textos jurídicos. Quando testamos em linguagem cotidiana, o desempenho caía drasticamente. A solução que funcionou foi adicionar uma camada de aumento de dados com variações sintéticas daquele domínio jurídico misturado com outros estilos de escrita. Isso equilibrou o treino sem precisar coletar dados novos manualmente. Outro ponto que as pessoas ignoram é a questão da diversidade lexical. Modelos treinados em textos muito homogêneos tendem a falhar em lidar com sinônimos e reescritas. No meu caso, usei um truque simples de pós-processamento: gerar parafrases básicas usando substituições controladas por frequência de termos. Isso aumentou a robustez do modelo em testes de generalização sem comprometer a coerência. Claro que isso só funciona se o vocabulário base já tiver cobertura suficiente. Se o dicionário for muito limitado, a parafraseação gera absurdos que atrapalham o treino. Tem também a questão do overfitting em linguagens muito específicas. Se o domínio de aplicação for técnico demais, como fóruns de nicho ou jargões corporativos, o modelo pode memorizar padrões ao invés de generalizar. A workaround que eu uso é introduzir dropout linguístico durante o treino. Basicamente, simular alguns erros de digitação e trocas de palavras aleatórias de vez em quando. Isso força o modelo a não depender de sequências perfeitas e a focar em padrões mais estruturais. O custo é um tempo de treino um pouco maior, mas a qualidade final compensa.

Se você está começando agora, recomendo não gastar tempo demais com limpeza extrema dos dados. Foque em garantir volume e diversidade. Depois que o modelo estiver rodando, aí sim observe onde ele falha e ajuste pontos específicos. Isso economiza semanas de trabalho manual e costuma entregar resultados melhores do que tentar prever todos os problemas antes de treinar.
Galeria
-
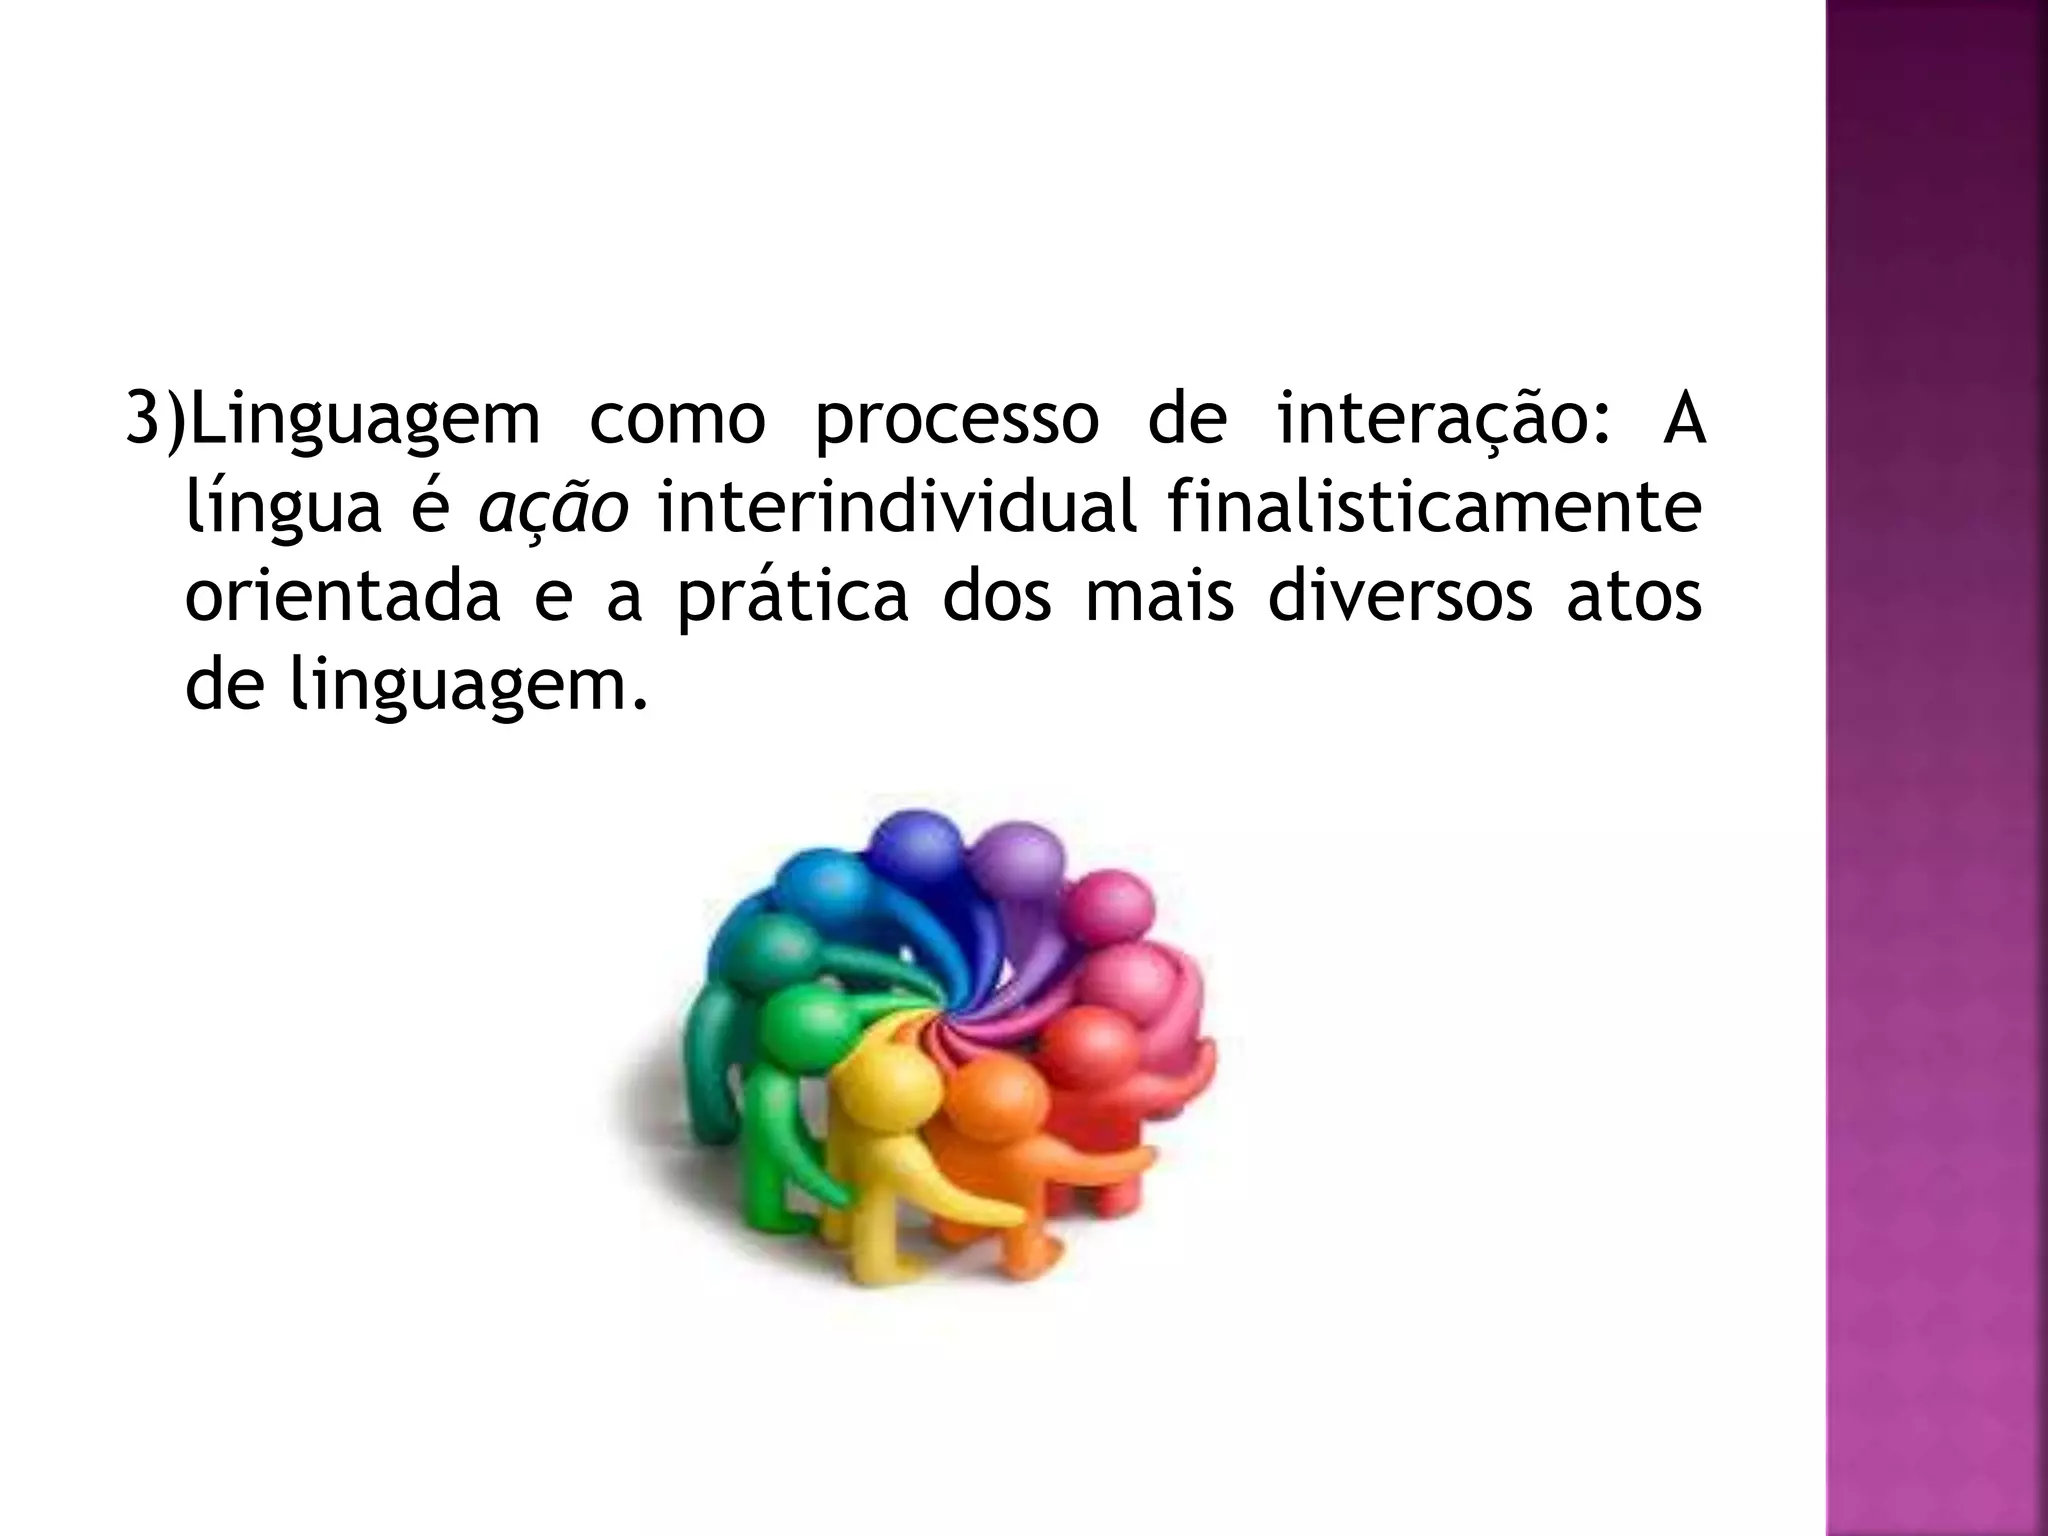
Concepções de linguagem, língua, gramática e | PPTX -
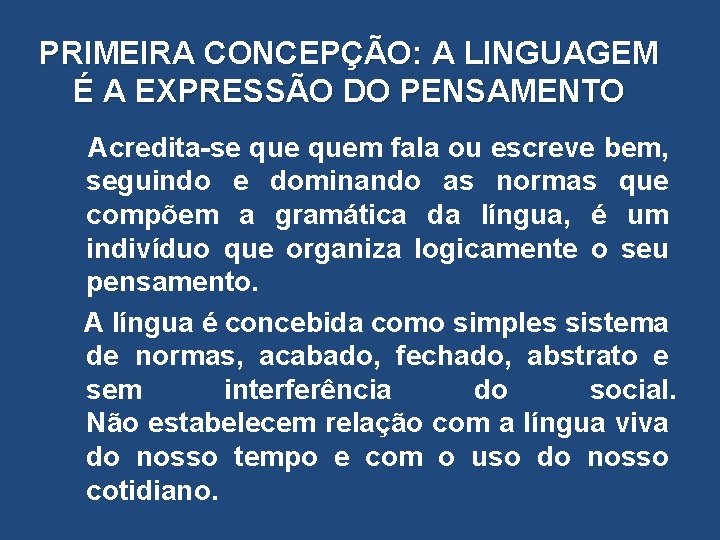
CONCEPO DE LINGUAGEM E O ENSINOAPRENDIZAGEM DE LNGUA -

PPT - Três concepções de linguagem PowerPoint Presentation, free ... -
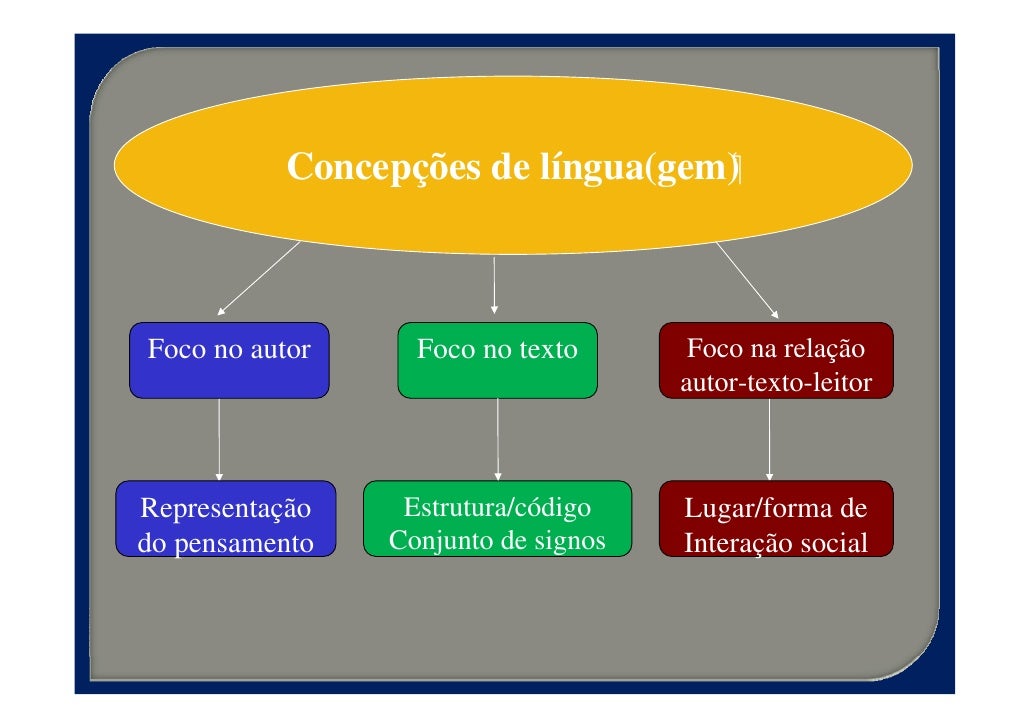
As Diversas Concepções De Linguagem Refletem A Compreensão ...
