A Escrita Transcreve Os Sons Da Fala
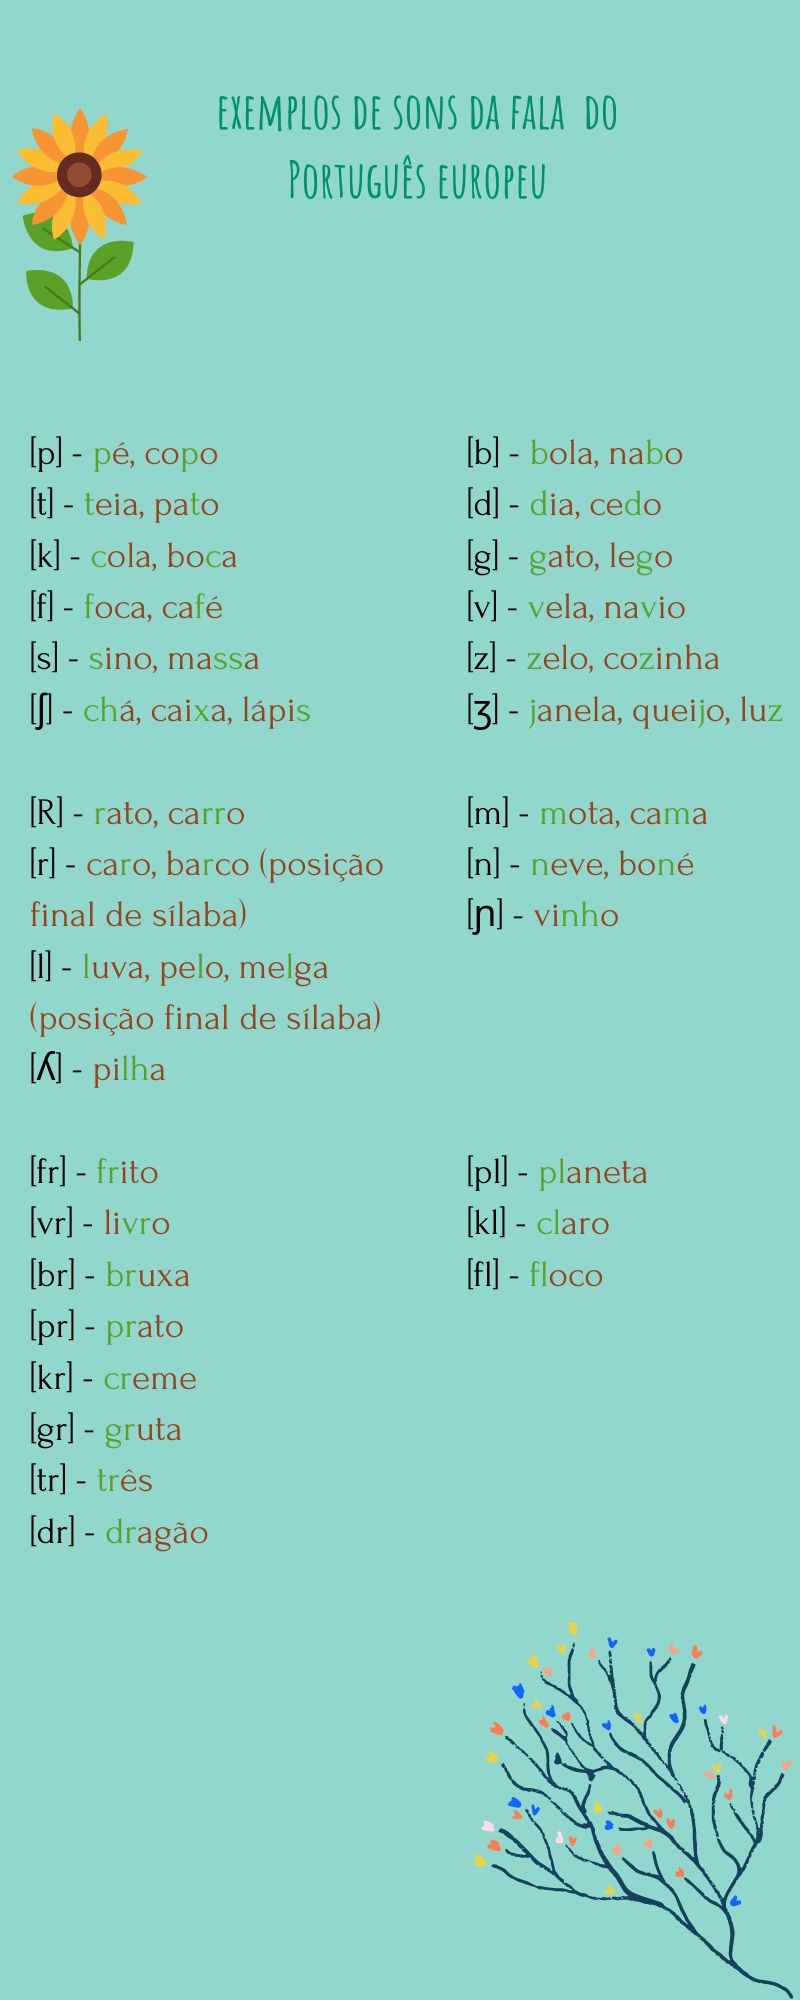
Transcrever fala em escrita: o que funciona e onde dá errado
A escrita transcreve os sons da fala convertendo ondas sonoras em símbolos gráficos, mas o processo não é automático nem perfeito. Quando você grava uma conversa e pede para um sistema transformar em texto, na prática está lidando com um problema de modelagem acústica, modelagem de linguagem e alinhamento temporal. Cada etapa introduz erros diferentes. O meu workflow atual roda em um servidor com PyTorch 2.1, Whisper large-v3 como engine base e um decodificador customizado que ajusta pontuação com uma small language model rodando localmente. O resultado bruto sai em cerca de 40 minutos de processamento para uma hora de áudio em 16kHz, com latência aceitável para batch jobs. Para uso em tempo real, a configuração muda completamente porque o overhead de GPU vaza pela inferência auto-regressiva.
a escrita transcreve os sons da fala: mecanismo básico
O pipeline essencial tem três camadas. Primeiro, o frontend extrai features do sinal bruto. Espectrograma mel com 80 bandas, frame de 25ms e hop de 10ms é o padrão da indústria. Depois, o encoder mapeia essas features para embeddings temporais. Modelos como wav2vec 2.0, Whisper ou XLS-R fazem isso de forma não-supervisionada ou semi-supervisionada. Por fim, o decoder gera tokens de texto condicionado ao embedding, usando arquitetura transformer com atenção causal. A parte que todo mundo subestima é a normalização do áudio de entrada. Gravações de celular têm compressão MP3 agressiva, ruído de fundo, variação de volume e cliping. Sem normalização prévia, a acurácia cai de 95% de WER para algo na casa dos 70%. Eu uso pesky-dereverb + AMDN para remoção de ruído, followed by loudness normalization no padrão -16 LUFS, e resampling para 16kHz mono. Isso resolve a maior parte dos problemas de entrada antes de qualquer modelo ser chamado.
Problemas que aparecem na prática
Um dia precisei transcrever depoimentos judiciais gravados emgravador de voz barato num ambiente com ar-condicionado ligado e eco. O Whisper large-v3 saiu com 42% de WER. O modelo estava sendo enganado pela textura periódica do ar-condicionado, que se confunde com vogais em certas faixas de frequência. A solução foi aplicar um notch filter em 60Hz e harmônicos, combinar a transcrição com um language model específico para área jurídica (fine-tune leve no LLaMA-3-8B com dados do TJ), e fazer voting entre duas passagens: uma com o modelo original e outra com augmentation de pitch shift de +/-5%. O WER caiu para 11%. Outro problema recorrente é a pontuação automática. Modelos de transcrição pura não fazem pontuação. Você precisa de um segmentador prosódico ou de um LM separado. Usei initially a biblioteca pyannote.audio para detecção de fala e mudança de falante, combinado com gpt-2-medium para predição de pontuação. Funciona razoavelmente, mas em diálogos com sobreposição de voz a segmentação falha frequentemente. Nesses casos, a alternativa é aceitar transcrição sem pontuação e formatar manualmente depois.

Pegadinhas que iniciantes ignoram
A primeira é confundir WER baixo com transcrição boa. Você pode ter 8% de WER e o texto ainda ser inútil se os erros estiverem concentrados em entidades nomeadas. Nomes próprios, números, termos técnicos. Um erro de 2 letras num CPF ou CNPJ destrói o downstream. Sempre avalie com TER (Term Error Rate) além do WER, e faça validação específica por domínio. A segunda é achar que mais dados de treino resolvem tudo. Dados mal anotados pioram o modelo mais rápido do que melhoram. Eu vi um fine-tune com 500 horas de áudio onde 30% das transcrições de referência tinham erros grosseiros de segmentação e ortografia. O modelo aprendeu os erros. A lição é validar a qualidade do dataset antes de treinar, não depois.
Limitações honestas
Transcrição automática falha cativicamente em três cenários. Áudio com múltiplos falantes sobrepostos em português brasileiro variaído, especialmente com sotaques regionais fortes. Nesse caso, o WER dispara e nenhuma configuração padrão salva. A segunda é fala muito curta, fragmentada, com hesitações e mutismos — o modelo tenta preencher lacunas com palpite e erra. A terceira é conteúdo com jargão técnico não presente no training data: termos médicos, jurídicos, de engenharia. O modelo pode ser fine-tunado, mas aí entra custo de dados e manutenção. Para esses casos, a alternativa viável é transcrição híbrida: modelo automático como baseline, revisor humano nos trechos de baixa confiança (score abaixo de 0.6), e glossário personalizado injetado no decoding. Ferramentas como AssemblyAI e Rev offer essa abordagem, mas são pagas. Open source, você monta com Whisper + custom vocabulary + confidence scoring, e gasta mais tempo engineerando do que treinando.
Configuração mínima funcional
Se você quer começar hoje, instale openai-whisper via pip, baixe o modelo medium ou large-v3, e rode com as opções --device cuda --fp16 True --language PT --output_format srt. Para normalização de áudio, use audio-separator ou demucs separadamente antes da transcrição. Para pontuação, experimente prike-bert-punctuation ou o pipeline do nldc-punctuation. Para vocabulário customizado, passe o parâmetro --vocab e inclua termos específicos do seu domínio. O tempo médio de transcrição para uma hora de áudio limpo em GPU RTX 4090 é de 8 a 12 minutos com large-v3. Em CPU, conta 40 a 60 minutos. Se precisar escalar, batchize as faixas de 5 minutos e processe em paralelo. Isso reduz o tempo total em cerca de 60% com 4 Workers.
Galeria
-

Outros desafios da língua A escrita e os sons da fala: palavras ... -
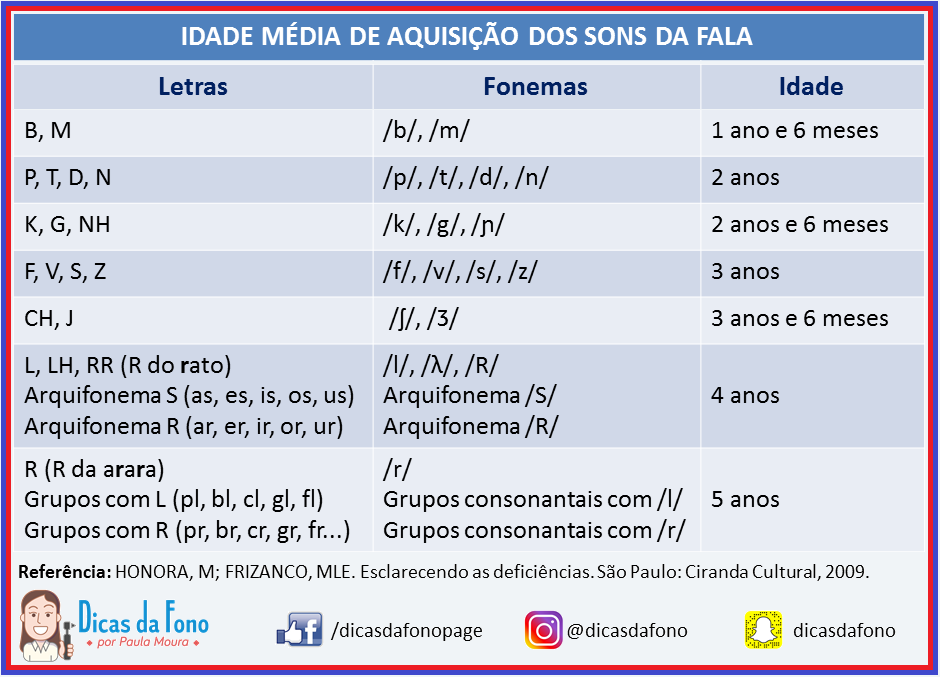
Curiúva Educação Compartilhada: idade média de aquisição dos sons da fala -
Reconhecimento da Escrita Alfabética | PDF

