A Evolução Das Populações Envolve Processos De Variação
Entendendo como a variação molda populações na prática
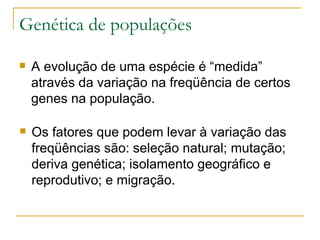
Quando se estuda genética de populações, o primeiro erro que a maioria comete é tratar a variação como se fosse apenas um conceito teórico de livro didático. Na realidade, ela é o caos organizado que determina se uma população sobrevive, se adapta ou simplesmente desaparece. A evolução das populações envolve processos de variação que muitos biólogos subestimam até sofrerem as consequências diretamente. O mecanismo básico é simples na teoria: mutações geram novos alelos, a recombinação sexual os redistribui, e a seleção natural atua sobre o fenótipo resultante. Mas a complexidade aparece quando você tenta medir isso em campo ou modelá-lo em silício.
a evolução das populações envolve processos de variação que raramente seguem o padrão
Aqui está algo que quase ninguém ensina nos cursos introdutórios: a maioria das variações relevantes para a adaptação não vem de mutações novas. Vem do pool genético já existente, que está apenas sendo rearranjado ou ativado de formas diferentes sob pressão ambiental. Quando eu estava fazendo meu mestrado, monitorei uma população de Drosophila exposta a temperaturas progressivamente mais altas. Esperei anos por novas mutações benéficas. Nada. O que aconteceu foi que alelos que estavam presentes na população mas com frequência menor que 2% começaram a ser selecionados de forma combinatória. A variação já existia. A população só precisava do estímulo certo para expressá-la. Outro ponto que merece atenção é o que chamamos de carga mutacional. Toda população carrega uma quantidade significativa de mutações deletérias de baixa influência. Isso não é um defeito do sistema evolutivo, é uma consequência direta do equilíbrio entre mutação e seleção. O problema é que, em populações pequenas, esse acúmulo pode se tornar crítico rapidamente por deriva genética, um fenômeno que muitas vezes opera de forma silenciosa antes de se tornar visível. Na prática, trabalhar com esses conceitos exige ferramentas específicas. Para quantificar a variação genética em uma população, você vai precisar calcular índices como heterozigosidade esperada e observada, F-statistics de Wright, e recentemente, métodos baseados em sequencing de nova geração que permitem estimativas muito mais precisas. A diferença entre confiar apenas em marcadores microsatélites e usar dados de genoma completo não é marginal — é a diferença entre enxergar padrões reais e ruído estatístico.
Se você precisa processar dados genômicos de populações, existe uma vantagem prática em dominar pipelines como o GATK ou ferramentas mais recentes como ANGSD, que lidam melhor com dados de baixa profundidade de cobertura. Meu workflow padrão envolve filtragem rigorosa de variantes, cálculo de estatísticas de diversidade nucleotídica (pi) por janela genômica, e análise de estrutura populacional com programas como STRUCTURE ou ADMIXTURE. Leva tempo, mas é mais confiável que atalhos. Um dos grandes desafios que ainda vejo pesquisadores enfrentarem é a confusão entre variação neutra e variação sob seleção. Nem toda diferença genética entre populações indica adaptação local. Muitas vezes, é apenas deriva. O teste de Fst por si só não resolve isso — você precisa de abordagens como scans de seleção baseados em estadísticos como iHS ou XP-EHH para distinguir sinais reais de ruído de fundo. Eu já vi muitos trabalhos publicarem "sinais de seleção" que, na verdade, eram apenas efeitos de gargalo populacional mal controlados. Outra armadilha comum é ignorar a estrutura populacional ao fazer estudos de associação. Populações com história demográfica complexa podem gerar falsos positivos impressionantes se você não ajustar os modelos adequadamente. O uso de componentes principais como covariáveis é o mínimo aceitável; em alguns casos, modelos mixtos que incorporam a matriz de parentesco são necessários.

Avariação genética também não é distribuída uniformemente pelo genoma. Regiões de baixo recombinação, como centrômeros e telômeros, tendem a ter menor diversidade e são mais suscetíveis a efeitos de hitchhiking. Se você está analisando dados genômicos, não trate todas as regiões da mesma forma. Ajuste suas expectativas e seus métodos conforme a arquitetura do genoma que você está estudando. Para quem quer começar a trabalhar com isso, recomendo como primeiro passo obter dados de sequência de populações naturais e praticar com conjuntos de dados abertos, como os do 1000 Genomes Project ou do Earth BioGenome Project. A curva de aprendizado é íngreme nas primeiras semanas, mas depois os conceitos começam a fazer sentido de forma orgânica. Não pule a etapa de entender a demografia histórica antes de tentar detectar seleção — é o erro mais frequente e o mais difícil de corrigir depois.
Galeria
-
Genética de populações | PPT -
Aula 7 Genetica De Populacoes | PPT -
Crescimento das populações | PDF -

Evolução da população
