A Inteligência Artificial É Uma Tecnologia Com Capacidade De Realizar

O que realmente significa esse conceito na prática
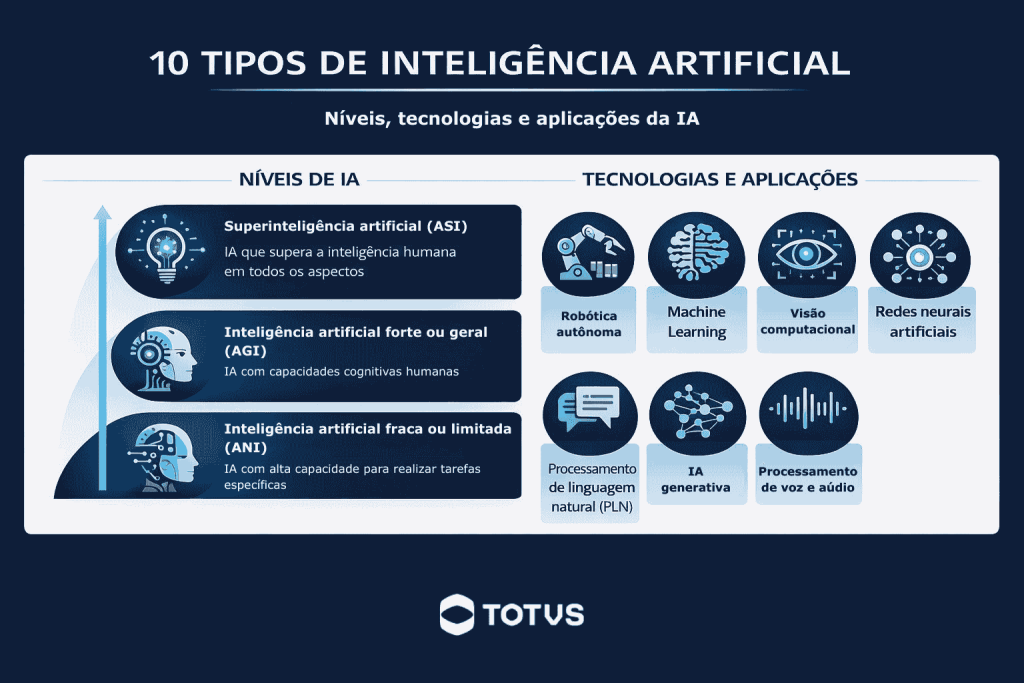
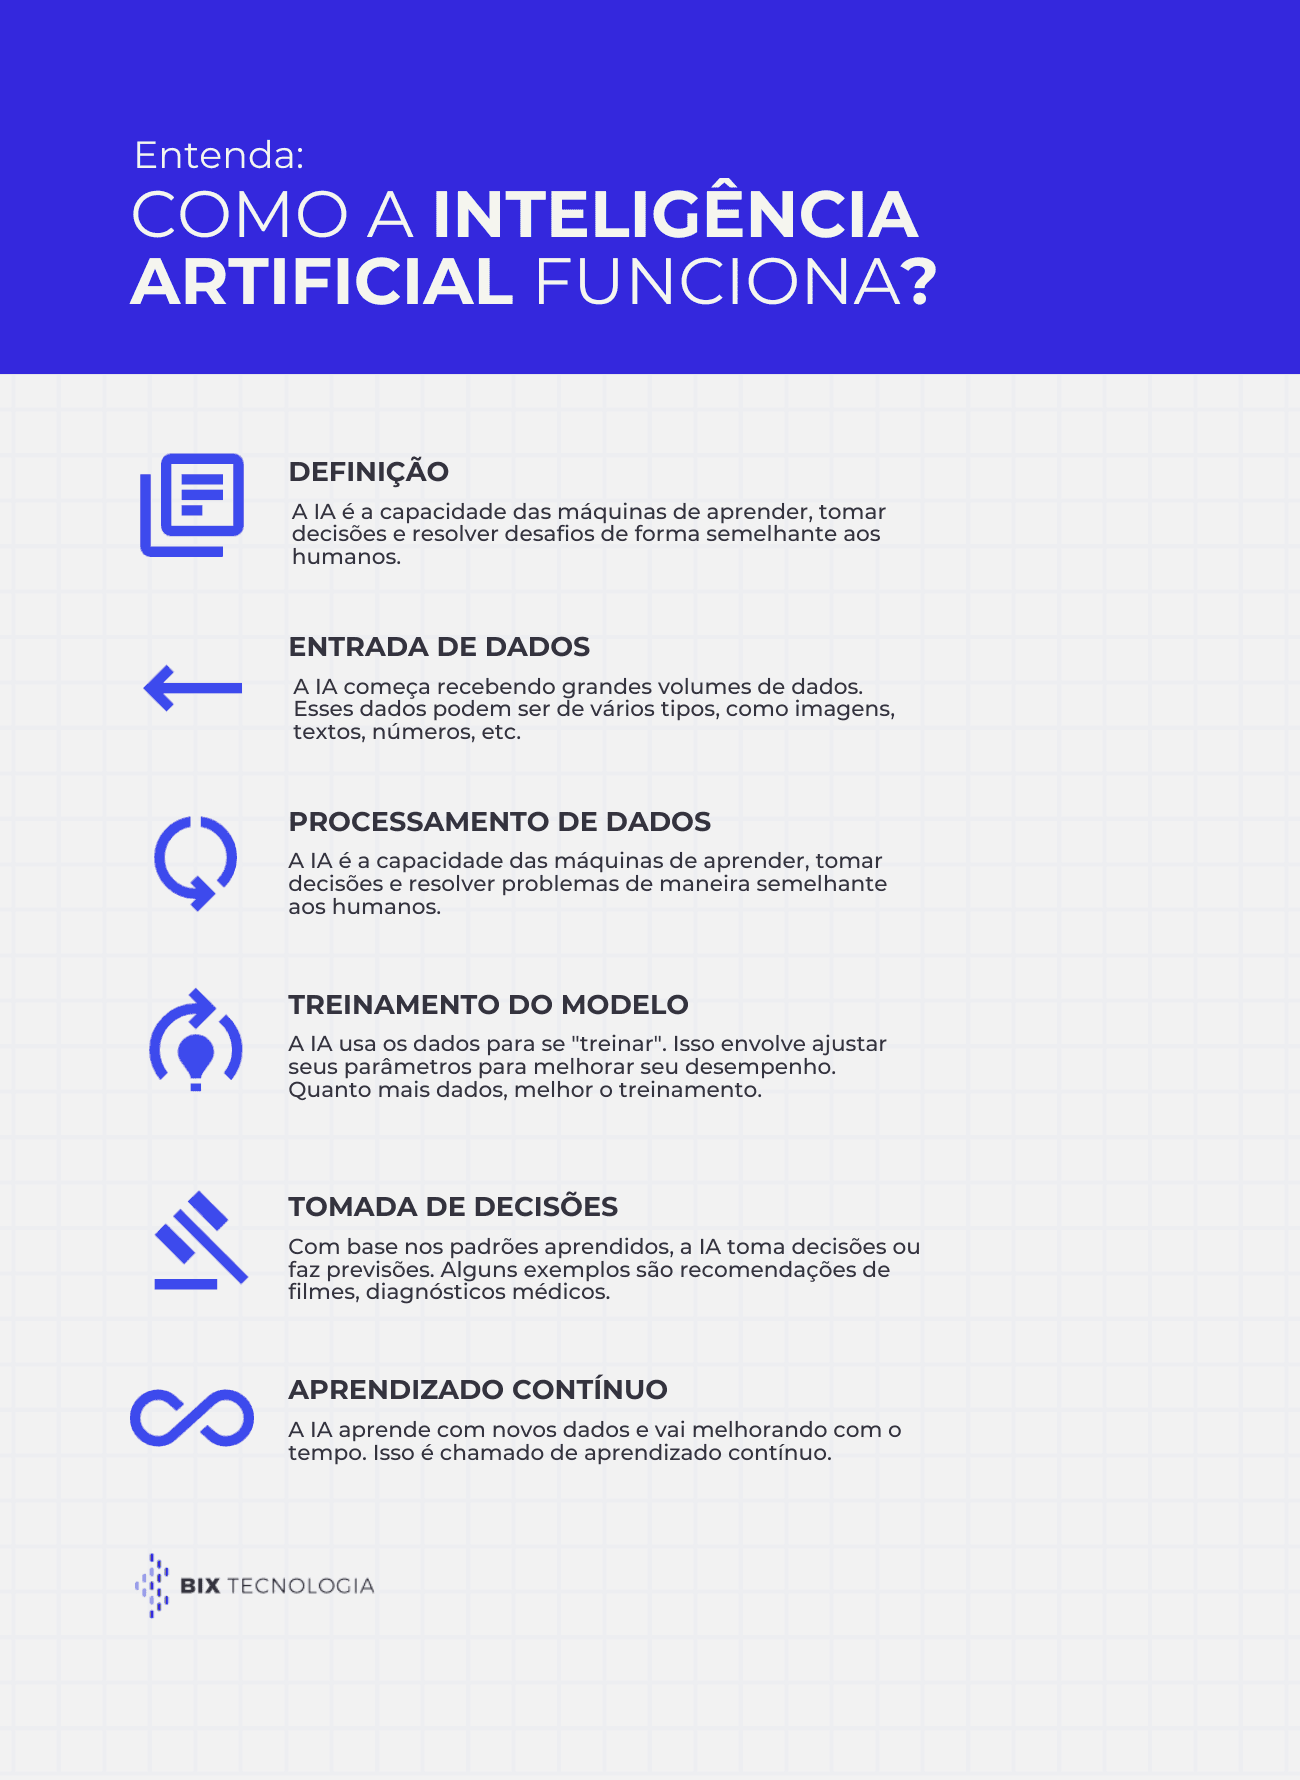
a inteligência artificial é uma tecnologia com capacidade de realizar tarefas que, historicamente, exigiam raciocínio humano. A definição soa bonita em papel, mas quando você coloca a mão na massa, descobre que há um abismo entre o que o marketing promete e o que o modelo entrega no deploy. Isso inclui classificação, geração de texto, reconhecimento de padrões, tomada de decisão, tradução, síntese de dados e muito mais. O termo genérico "IA" cobre desde regras heurísticas simples até transformers com bilhões de parâmetros. Saber qual categoria se aplica ao seu problema evita dor de cabeça desnecessária. Eu montava pipelines de extração de dados para relatórios financeiros quando encontrei um problema específico: um modelo de linguagem foi configurado para extrair valores monetários de contratos em PDF. O modelo entregava 94% de acurácia em média, mas falhava consistentemente em contratos com tabelas de duas colunas onde os valores não tinham vírgula decimal — tipo "50000" em vez de "50.000". A solução foi cruzar a saída do modelo com uma regex específica para formatação brasileira e aplicar uma camada pós-processamento baseada em regras para normalizar os valores antes de persistir no banco. Levou umas quatro horas para ajustar e depois funcionou sem regressão.
O erro mais comum que eu vejo é tratar todo problema de IA como se fosse resolver com o mesmo tipo de modelo. Comece entendendo a natureza dos seus dados e o que o resultado precisa representar no sistema final. Se você precisa de classificação binária com requisitos de interpretabilidade, uma floresta aleatória ou regressão logística pode ser suficiente e vai rodar dez vezes mais rápido em hardware comum. Outro ponto que pouca gente leva a sério: a qualidade dos dados de treino domina tudo. Um modelo mediano treinado em dados bem rotulados supera um modelo state-of-the-art treinado em dados sujos em qualquer cenário real. Invista tempo na curadoria dos dados antes de brincar com hiperparâmetros.
Como implementar do zero, passo a passo
Primeiro, defina o escopo com clareza. O que o sistema precisa fazer? Qual é o formato de entrada e de saída esperado? Sem isso, você gasta semanas refinando algo que nobody vai usar. Depois, colete e organize os dados. No meu fluxo de trabalho, costumo separar em três datasets: treino, validação e teste, com uma divisão de 70/15/15. Guarde os IDs dos exemplos no dataset de teste para que eles nunca apareçam no treino ou validação. Vazamento de dados entre splits é o erro silencioso que destrói métricas no deploy. Escolha a arquitetura certa. Para tarefas de texto, modelos de linguagem pré-treinados como BERT, RoBERTa ou GPT funcionam bem com fine-tuning. Para classificação de imagens, architectures como EfficientNet, ResNet ou ViT são opções sólidas. Para dados tabulares, XGBoost, LightGBM e CatBoost continuam sendo competitive mesmo contra redes neurais profundas.
Aqui vai uma informação contraintuitiva que aprendi na prática: modelos menores, quando fine-tunados adequadamente, frequentemente superam modelos maiores genéricos em domínios específicos. Um modelo de 125 milhões de parâmetros fine-tunado no seu domínio pode bater um modelo de 7 bilhões de parâmetros não adaptado, e vai rodar em uma CPU sem precisar de GPU. Para o fine-tuning, comece com learning rate baixo, na faixa de 2e-5 a 5e-5 para transformers. Use um scheduler linear de decréscimo e early stopping baseado na loss de validação. Um ciclo típico de fine-tuning leva entre 30 minutos e 4 horas, dependendo do tamanho do modelo e do dataset. O pós-treinamento é onde a maioria para e esquece de testar. Faça validação cruzada, teste em casos extremos, edge cases e inputs maliciosos. Meus testes de estresse envolvem entradas com caracteres especiais, campos vazios, números fora da faixa esperada e textos deliberadamente ambíguos. Isso revela problemas que a métrica de acurácia média esconde completamente.
Pitfalls reais que eu já vi dar errado
O primeiro problema é overfitting disfarçado. O modelo performa bem no dataset de teste mas falha em produção porque os dados de produção têm distribuição diferente. A solução prática é monitorar drift de distribuição e recolocar dados novos periodicamente no treino. O segundo é a ilusão de generalização. Um modelo treinado para classificar reclamações de seguros automotivos vai ter desempenho terrível com reclamações de seguros de saúde, mesmo que ambas sejam textos. Não assuma que o que funciona em um domínio escala para outro sem revalidação completa. Um terceiro problema crônico é a dependência de APIs externas. Se você construir toda a sua stack sobre um serviço de terceiros e ele subir de preço ou mudar os termos, seu produto simplesmente para de funcionar. Tenha um plano de contingência com fallback local ou multi-cloud.
Para quem quer começar agora, as bibliotecas padrão do mercado são Hugging Face Transformers para NLP, PyTorch ou TensorFlow para deep learning, Scikit-learn para modelos clássicos, e ONNX para exportação de modelos entre frameworks. A maioria das soluções gratuitas e open source roda bem em instâncias cloud entry-level com 8GB de RAM e uma GPU T4, o que custa menos de 50 dólares por mês. O campo evolui rápido demais para confiar em tutoriais antigos. Versionamento de dados, experiment tracking e pipelines de CI/CD para ML são obrigatórios em qualquer projeto que preze pela longevidade. Senão, você passa mais tempo caçando bugs de produção do que desenvolvendo funcionalidades novas.
Galeria
-

Conheça os diferentes tipos de Inteligência Artificial -
Inteligência Artificial: o que é, como funciona e por que ela já faz ... -
Inteligência Artificial Fundamentos: História, Conceitos e Aplicações ...
