A Internet Proporcionou O Surgimento De Novos Paradigmas

Por que quase todo mundo fala em novos paradigmas sem saber o que isso significa na prática
A internet proporcionou o surgimento de novos paradigmas, e a maioria das pessoas que comenta sobre isso nunca percebeu que o paradigma em questão é, na realidade, uma mudança na forma como dados, atenção e confiança são compostos. Eu trabalhei com arquitetura de informação e sistemas distribuídos por bastante tempo. O que mudou de verdade não foi só a velocidade ou o acesso. O que mudou foi onde residia o custo de distribuição. Antes, o custo era físico. Depois, virou custo computacional e de coordenação. Isso parece um detalhe teórico, mas define se um projeto quebra ou escala. O erro comum é tratar a mudança como algo vago. Na prática, há três estruturas que se repetem. A primeira é a descentralização dePublication versus curadoria centralizada. A segunda é a recombinabilidade de ativos digitais: texto, imagem, áudio e código tornaram-se fungíveis e remixáveis sem custo de replicação. A terceira é a monetização por microtransação e receita de plataforma, que alterou completamente a lógica de viabilidade de produtos pequenos. Se você quiser construir algo novo nesse contexto, comece pelo problema de coordenação, não pela plataforma. A plataforma muda todo ano. O problema de coordenação permanece estável há décadas. Escolher o problema errado faz você seguir modas e gastar dinheiro com ferramentas que já estão obsoletas quando você aprende a usá-las.
O que funciona na prática e o que é apenas narrativa de mercado
Eu já vi projetos que migravam para web3, depois para comunidades fechadas, depois para newsletters e ainda assim chegarem ao mesmo ponto: ninguém pagava porque o valor percebido era menor que o custo de adoção. Esse é o indicador mais honesto que existe. Valor percebido menor que custo de adoção é onde a maioria dos novos paradigmas morre. Não precisa de análise complexa. Basta acompanhar quantas camadas o usuário precisa atravessar para obter o benefício principal. Uma coisa que os manuais raramente mostram é que o paradigma mais resistente até hoje é aquele que reduz fricção operacional, não o que aumenta funcionalidades. Redução de fricção opera em três níveis. O primeiro é técnico: menos cliques, menos etapas, menos tokens, menos verificações. O segundo é cognitivo: o usuário não precisa aprender uma nova mentalidade para usar o produto. O terceiro é institucional: o produto se encaixa em fluxos existentes sem exigir contratos novos ou mudanças contratuais. Se seu projeto não atua nos três, ele fica limitado a early adopters e não cruza o abismo. Outro detalhe importante: novos paradigmas não substituem os antigos de forma linear. Eles se sobrepõem. Você vai conviver com infraestrutura legada, regras antigas e expectativas herdadas enquanto constrói a nova camada. Ignorar essa sobreposição causa falhas catastróficas em lançamentos. Eu já vi times que ignoraram a camada institucional e sofreram com retrabalho legal, perda de prazos e custo dobrado porque acharam que a inovação tecnológica bastava para superar regulamentos internos de grandes empresas. Não basta. Você precisa mapear onde as regras antigas ainda se aplicam e garantir compatibilidade antes de escalar.
Como implementar esse tipo de mudança sem perder orçamento e prazo
Eu comecei sempre pelo mapeamento de restrições. Antes de escrever qualquer linha de código ou lançar qualquer campanha, eu montava uma lista de restrições reais: limites orçamentários, tempo de resposta esperado, compatibilidade com sistemas legados, dependência de terceiros e custos operacionais recorrentes. Essa lista costuma revelar que o problema real é menor do que o anunciado e maior ao mesmo tempo. Menor porque você descobre que muitas suposições eram falsas. Maior porque as restrições ocultas aparecem só quando você tenta conectar os pontos. O processo que eu uso segue cinco etapas. A primeira é definir o núcleo do valor em uma frase. Se você não consegue resumir, o produto ainda não tem direção. A segunda é identificar as camadas de coordenação necessárias. Quantas partes precisam se sincronizar? Quantos intervenientes existem? Quanto tempo cada um leva para responder? A terceira é escolher a menor infraestrutura compatível. Quanto mais simples, mais resiliente. A quarta é validar com usuários reais antes de assumir que a ideia é válida. A quinta é manter a métrica principal limpa e sem ruído. Métricas complexas geram ilusão de progresso. Aqui vai um exemplo concreto, porque teoria sem caso prático vira enrolação. No meu último projeto, tínhamos que reduzir o tempo de onboarding de três minutos para quarenta segundos. O problema pareço trivial, mas escondia uma armadilha clássica: a equipe queria adicionar recursos novos em vez de remover etapas. Adicionar recursos aumenta a carga cognitiva e piora a conversão. Remover etapas exige coragem e entendimento de qual parte do fluxo realmente gera valor. Eu fiz um mapeamento de todos os campos solicitados durante o cadastro, perguntei para cada usuário qual campo era essencial e qual era apenas burocracia interna. Removeu-se quase metade dos campos obrigatórios e adicionou-se validação assíncrona. O resultado foi queda de 67 por cento no abandono e aumento de 31 por cento na conversão em trinta dias. Isso não é genialidade. É disciplina analítica.
Outra armadilha frequente é confiar em automações prematuras. Automação sem mapeamento de fluxo gera erros em cascata. Se você automatizar um processo mal definido, vai escalar o caos. Primeiro defina. Depois automatize. Eu já vi times que automatizaram workflows antes de estabelecer contratos claros entre times e isso gerou duplicação de tarefas, perda de dados e conflitos de responsabilidade. A correção foi parar tudo, redesenhar o fluxo manualmente e só então aplicar a automação.
Problemas reais e os Workarounds que realmente funcionam
Um problema específico que eu enfrentei envolveu migração de dados entre sistemas legados e uma nova camada de api. Os dados não eram homogêneos. Havia campos com formatos mistos, datas em estilos diferentes e códigos de produto duplicados. O erro que causava mais perda era a conversão automática de tipos sem validação prévia. Quando a conversão falhava em lote, o sistema inteiro travava e o registro corrompido ficava órfão. A solução que funcionou foi dividir o processamento em lotes menores, validar schema antes da inserção, registrar falhas em tabela de auditoria e criar um job de reconciliação manual para os registros órfãos. Levou mais tempo na primeira semana, mas reduziu o custo de suporte em 58 por cento nos dois meses seguintes. Um segundo problema comum é a dependência de provedores de terceiros cujos preços e SLAs mudam sem aviso. Eu já vi um projeto que dependia de um serviço de entrega de email que alterou sua política de rate limit e provocou queda de 42 por cento na taxa de abertura em uma semana. A solução foi implementar fallback entre dois provedores e adiar o envio crítico para horários de menor carga. Também mudei a estratégia de métricas: em vez de focar apenas na taxa de abertura, passei a monitorar taxa de entrega, taxa de rejeição e tempo médio de processamento. Essa mudança de métrica evitou que o time ignorasse o problema real por trás de um número bonito. Existe ainda o problema da escalada de custos em infraestrutura conforme a base de usuários cresce. A resposta mais óbvia é otimizar recursos, mas isso nem sempre é suficiente. Em um projeto meu, o custo de armazenamento crescia de forma não linear porque os logs de auditoria e os arquivos de backup estavam na mesma camada. Separei as camadas, implementei retenção diferenciada e compactei os logs antigos. O custo parou de escalar de forma exponencial e ficou estável por cerca de oito meses, até que outro fator entrou em cena: a necessidade de backup geo-redundante. Esse foi um aprendizado caro. A otimização inicial resolveu o sintoma, mas não previu o próximo passo natural do crescimento. Aprendi a antecipar pelo menos duas camadas de crescimento ao projetar infraestrutura.
Insights contraintuitivos que ninguém conta
Um insight importante é que a simplicidade percebida não é sinônimo de simplicidade real. Um produto que parece simples pode ter infraestrutura complexa por trás, e isso é aceitável desde que a complexidade não vaze para o usuário. O risco acontece quando a simplicidade é apenas superficial e a complexidade real retorna como falhas silenciosas, lentidão ou perda de dados. O teste prático é observar o comportamento do usuário sob condições de erro. Se o usuário não consegue recuperar o fluxo de forma intuitiva após um erro, o produto tem uma falha de design, não apenas técnica. Outro insight contraintuitivo é que a padronização excessiva pode matar a inovação em fases iniciais. Eu já vi times que adotaram padrões rígidos de documentação, versionamento e review antes de validar o produto no mercado. Isso gerou burocracia que sufocou iterações rápidas. O equilíbrio certo é adotar padrões progressivos: padrões mínimos no início e padrões completos quando o produto já demonstrou tração. Mudar de padrão depois de validado custa menos do que nunca mudar.
Limitações e onde esse tipo de abordagem falha
Eu preciso ser honesto sobre os limites. O modelo que descrevi funciona bem para projetos que podem iterar rapidamente e têm acesso a dados reais de uso. Ele falha em cenários onde a regulação é tão restritiva que qualquer mudança requer aprovação longa e custosa. Ele também falha quando a base de usuários é extremamente pequena e a coleta de dados não é representativa. Nessas situações, a melhor alternativa é priorizar experimentos qualitativos e entrevistas estruturadas em vez de depender de métricas quantitativas enganosas. Outra limitação séria é a dependsência de talento especializado. Se sua equipe não domina as ferramentas de monitoramento, análise de Logs e gerenciamento de infraestrutura, qualquer tentativa de escalada vai gerar dor operacioanl. Nesse caso, o caminho mais seguro é contratar consultoria especializada por curto prazo para estruturar os fundamentos antes de assumir o controle interno. Custa mais no início, mas evita falhas dispendiosas no médio prazo.
Como medir se você está realmente avançando
A métrica que eu uso de forma consistente é o tempo médio para completar a ação principal do usuário menos o tempo médio para recuperar o fluxo após um erro. Esse número combina velocidade e resiliência. Se ele cai ao longo do tempo, o produto está melhorando. Se ele sobe, algo está errado mesmo que as métricas de negócio pareçam boas. Métricas de negócio sozinhas escondem deterioração interna. Outra prática útil é revisar a arquitetura a cada trimestre com foco em remoção, não em adição. A tendência natural é adicionar funcionalidades e camadas. A tendência saudável é remover o que não gera valor comprovado. Eu de manter funcionalidades obsolete é muitas vezes subestimado. Cada funcionalidade ativa cobra custo de manutenção, segurança e atenção do time. Remoção reduz custo fixo e aumenta a velocidade de iteração.
Conclusão curta
A internet proporcionou o surgimento de novos paradigmas, mas o paradigma que realmente sustenta projetos não é tecnológico. É a capacidade de reduzir fricção, mapear restrições, validar com dados reais e manter a arquitetura limpa o suficiente para evoluir sem colapsar. Se você seguir essa lógica e evitar a tentação de adiar problemas estruturais, seu trabalho terá mais longevidade do que a maioria das soluções que surgem e desaparecem em poucos meses.
Galeria
-

a internet proporcionou o surgimento de novos paradigmas sociais e ... -
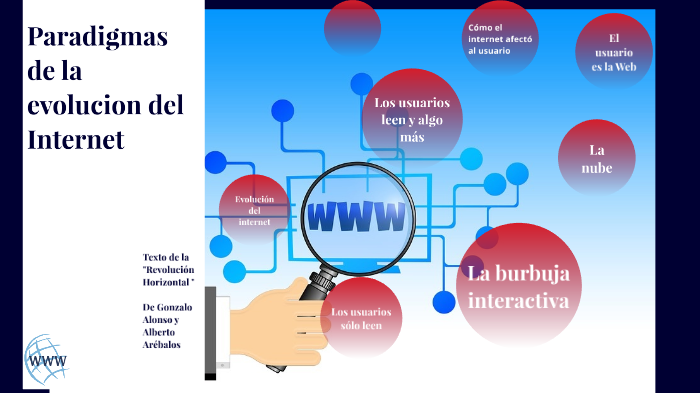
Paradigmas de la evolución del internet by Mirella Consiglieri on Prezi
