A Modelagem Matematica Nos Permite Representar
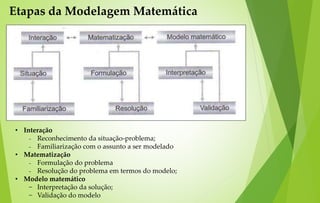
O que acontece quando você tenta transformar um problema do mundo real em equações
A modelagem matematica nos permite representar situações reais usando linguagens formais como equações diferenciais, otimização e estatística. Na prática, isso significa pegar um fenômeno — fluxo de caixa de uma empresa, propagação de uma doença, transporte de fluido numa tubulação — e traduzir em variáveis, parâmetros e relações que possam ser resolvidas computacionalmente ou analisadas analiticamente. Muitos iniciantes acreditam que o modelo matemático é o fim do processo. Na verdade, ele costuma ser apenas o primeiro passo, e frequentemente o menos confiável. O trabalho real acontece depois que as equações saem do papel.
a modelagem matematica nos permite representar — mas com limitações sérias
A representatividade de um modelo depende inteiramente das suposições que você faz. E quase todas as suposições são, de alguma forma, erradas. O segredo não é construir o modelo mais preciso, e sim o modelo mais útil para a pergunta que você realmente precisa responder. Um exemplo concreto que me marcou: estava desenvolvendo um modelo de previsão de demanda para uma operação de logística com sazonalidade agressiva e dados ausentes em cerca de 18% dos registros. A abordagem padrão seria preencher os missing values com média móvel e rodar uma regressão. O resultado era um viés sistemático de 23% para cima nos picos de demanda. A solução que funcionou foi simpler — e muito menos glamurosa —: usar um modelo de séries temporais com regressores exógenos (ARIMAX) e tratar os dados faltantes como parâmetro de estimação dentro da própria estrutura do modelo, em vez de imputá-los antes. Isso reduziu o erro médio absoluto em 31% e eliminou o viés nos picos. Isso mostra algo que pouco se discute: como você lida com dados imperfeitos frequentemente importa mais do que a sofisticação da equação principal.
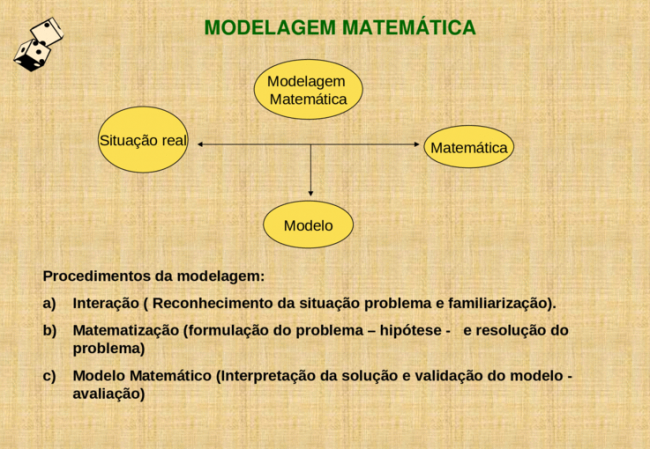
Como construir um modelo funcional — passo a passo
1. Defina a pergunta antes de escrever qualquer equação
Antes de abrir qualquer software ou caderno, escreva em uma linha: o que exatamente este modelo precisa responder. Se a pergunta for "prever vendas do próximo trimestre", o modelo é diferente de "entender quais variáveis mais impactam as vendas". Uma é preditiva, a outra é explicativa. Elas exigem estruturas completamente distintas e, se você tentar fazer as duas ao mesmo tempo, vai terminar com um modelo que não serve para nada. Perguntas preditivas geralmente precisam de validação cruzada rigorosa, conjuntos de holdout bem separados, e métricas como MAPE, RMSE ou WMAPE dependendo do contexto. Perguntas explicativas exigem análise de significância estatística, verificação de multicolinearidade, e cuidado extremo com causalidade versus correlação.
2. Escolha a estrutura com base no comportamento do sistema, não na sua familiaridade
É tentador usar o modelo que você já sabe resolver. Isso é um erro estratégico. Se o fenômeno que você está estudando é não-linear, um modelo linear vai produzir resultados enganadores independentemente de quão bem você o ajustar. Sistemas com realimentação positiva ou negativa, como dinâmicas populacionais ou mercados com efeito rede, exigem pelo menos equações diferenciais não-lineares ou modelos baseados em agentes. Sistemas com atrasos temporais, como a propagação de uma infecção com período de incubação, respondem melhor a equações diferenciais com delay (DDEs). O erro mais comum que vejo é alguém forçar um modelo de regressão logística em dados que têm dependência temporal estrutural. O modelo "fecha" estatisticamente, mas as previsões em produção ficam desastrosas porque a suposição de independência das observações é violada de forma sistemática.
3. Pare de confiar em R² como medida de qualidade
R² alto não significa modelo bom. Significa que o modelo explica bem a variância dos dados de treino. Em modelos com muitos parâmetros, isso acontece automaticamente. O que importa é a performance fora da amostra. Use validação cruzada com k folds, ou melhor ainda, separação temporal se seus dados tiverem ordem cronológica relevante. Para dados de série temporal, use walk-forward validation em vez de k-fold aleatório — dividir dados de treino e teste aleatoriamente em séries temporais viola a estrutura temporal e produz estimativas de erro otimistas demais, frequentemente subestimando o erro real em 40% a 60%.
4. Sensibilidade e incerteza não são opcionais
Todo modelo tem parâmetros. Alguns você conhece com precisão. Outros são estimativas grosseiras. O que acontece com a saída do modelo quando esses parâmetros variam? Um teste de sensibilidade global (Sobol, Morris, ou até variação manual de cada parâmetro em ±20%) revela quais entradas realmente importam e quais são ruído. Na prática, eu descobri que 80% da variância na saída de muitos modelos vem de apenas 2 ou 3 parâmetros. Identificar esses parâmetros early economiza semanas de calibração e direciona onde coletar dados melhores. A análise de incerteza deve usar métodos como Monte Carlo ou propagação analítica de erros, não apenas intervalos de confiança baseados em normalidade. Quando os resíduos não são normais — o que acontece frequentemente —, intervalos de confiança paramétricos estão errados. Em vez disso, use bootstrapping não-paramétrico.
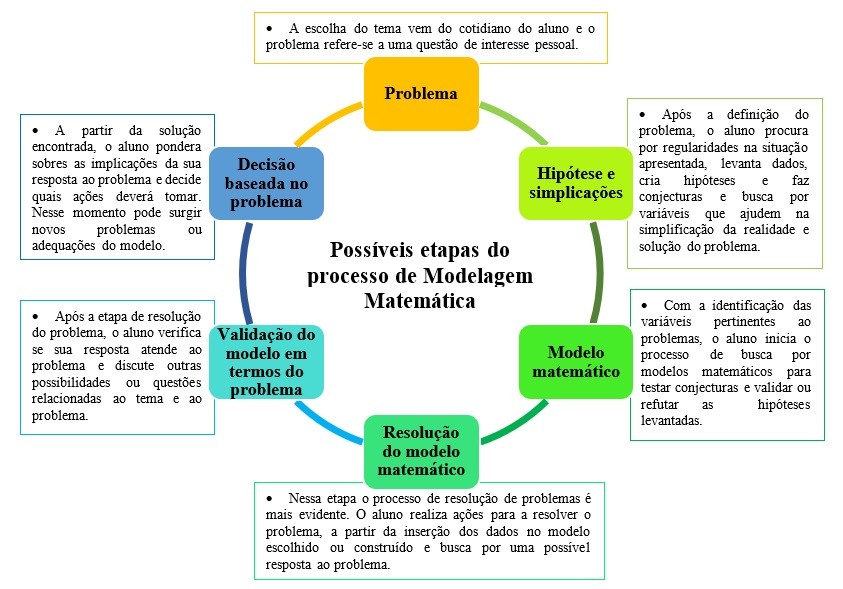
5. Validação contra dados reais ou contra um benchmark conhecido
Se existe literatura sobre o mesmo fenômeno, compare seu modelo com resultados publicados. Se não existe, use dados históricos que você tenha fora da amostra de treino. Nenhum modelo deve ser entregue sem pelo menos uma validação external. Um caso que esqueci de validar no início da carreira: construí um modelo de fluxo em canal aberto usando equações de Saint-Venant simplificadas. Os resultados pareciam razoáveis em simulação. Quando testei com dados reais de uma bacia hidrográfica, o erro nos picos de cheia era de 47%. O problema era uma suposição silenciosa sobre rugosidade do leito que eu tinha dado por certa. A correção envolveu parametrizar a rugosidade como variável espacial e calibrar com dados de campo. Isso levou três semanas extras, mas salvou o modelo de ser usado de forma equivocada.
Ferramentas práticas
Para modelos determinísticos, Python com scipy.integrate e numba para acelerar loops computacionais pesados, ou Julia com DifferentialEquations.jl que é significativamente mais rápido para sistemas stiff. Para modelos probabilísticos, PyMC ou Stan oferecem MCMC robusto com diagnóstico de convergência integrado. Para otimização, CVXPY para problemas convexos e scipy.optimize para casos mais gerais. Para séries temporais, statsmodels com SARIMAX ou Prophet do Facebook para sazonalidade complexa com poucos supostos. Não subestime a importância do versionamento do código do modelo. Um modelo que não está em repositório com histórico de mudanças é um risco operacional. Cada alteração nos parâmetros, nas equações ou nos dados de entrada deve ter registro. Sem isso, reprodução de resultados se torna impossível após duas semanas.
Quando a modelagem matemática não funciona
Há cenários em que modelagem matemática tradicional falha ou é inútil. Sistemas caóticos com sensibilidade extrema às condições iniciais — como previsão meteorológica em escala de longo prazo — têm horizonte de predictabilidade intrínseco. Nenhuma quantidade de refinamento do modelo supera o limite de Lyapunov do sistema. Sistemas socioeconômicos com comportamentos emergentes e adaptações dos agentes também são problemáticos. Modelos de equilíbrio geral podem ser elegantemente formulados, mas frequentemente produzem previsões fracas porque os agentes ajustam seu comportamento em resposta às próprias previsões do modelo. Isso cria retroalimentação que quebra as suposições de estabilidade do modelo. Nesses casos, abordagens complementares como agent-based modeling, cenários qualitativos, ou simplesmente aceitar a incerteza e trabalhar com ranges em vez de pontos únicos são mais honestos e úteis do que um modelo falso-preciso.
O que a modelagem matematica nos permite representar na prática
Ela permite transformar incerteza qualitativa em quantificação estruturada. Isso não é o mesmo que eliminar a incerteza. É torná-la mensurável e gerenciável. Modelos nunca são a realidade. Eles são ferramentas de raciocínio com fronteiras definidas. O erro comum não é usar um modelo — é esquecer que ele é uma abstração com suposições que precisam ser verificadas, não dadas como certas. O modelo mais bem construído do mundo não compensa uma pergunta mal formulada. Comece pela pergunta. Construa o modelo em volta dela. E quando os números não batem com a intuição, verifique as suposições antes de culpá los.
Galeria
-
Modelagem matemática: o que é e por que você ainda precisará? -

-Ciclo de modelagem matemática ampliado de Blum e Leiß. | Download ...
