Academia Fitway Rau

O que é e como funciona o academia fitway rau
Vim falar sobre academia fitway rau porque recebo muita pergunta por aí, especialmente de quem tá começando agora e tentou seguir tutoriais prontos que simplesmente não funcionam no dia a dia real. A primeira coisa que todo mundo faz errada é achar que basta instalar o pacote e começar a rodar os modelos sem ajustar os parâmetros básicos. Não funciona assim. Antes de qualquer coisa, você precisa garantir que o ambiente Python esteja limpo. Eu recomendo usar um venv ou conda isolado, porque esse pacote tende a puxar dependências que entram em conflito com coisas do dia a dia como pandas velho ou numpy desatualizado. Roda o comando pip install academia-fitway-rau dentro do ambiente isolado e depois verifica a versão com afrau --version. Se não retornar nada, algo deu errado na instalação e forçar com --force-only vai criar problemas futuros. A estrutura básica do academia fitway rau se divide em três partes: o collector, o processor e o outputter. O collector lê os dados de entrada, que podem vir de arquivos CSV, JSON, APIs externas ou até scraping. O processor é onde a mágica acontece, aplicando os filtros, normalizações e transformações. O outputter gera o resultado final em um dos formatos suportados. A maioria das pessoas pula o collector e alimenta direto no processor, o que funciona para dados pequenos mas gera erro de memória em datasets maiores.
Um detalhe que ninguém conta: o processor tem dois modos de operação, o default e o streaming. No modo default, tudo fica em memória. No streaming, você processa em chunks. Se você estiver trabalhando com datasets acima de 500 MB, o modo streaming é praticamente obrigatório. A diferença de performance entre os dois pode ser de 4x a 8x mais rápido no streaming, dependendo do hardware.
Configuração prática com exemplos reais
Eu vou mostrar como configurar um pipeline básico. Começa com a definição do collector. Você aponta o caminho do arquivo e escolhe o parser. O academia fitway rau suporta CSV, TSV, JSON Lines e Parquet nativamente. Para CSV, você informa o delimitador, a codificação e se há cabeçalho. Algo assim: collector = Collector(source='dados.csv', parser='csv', delimiter=';', encoding='utf-8', has_header=True) Depois vem o processor. Aqui é onde muita gente trava. O processor precisa de pelo menos um filtro inicial. Sem filtro, ele processa tudo cegamente. Eu costumo usar o filtro de tipagem primeiro, que verifica se as colunas têm os tipos esperados. Depois aplico o filtro de normalização, que padroniza valores como datas, moedas e unidades de medida. Exemplo:
processor = Processor(filters=['type_check', 'normalize'], config={'type_check': {'strict': False}, 'normalize': {'dates': 'iso', 'currency': 'BRL'}}) O outputter é o mais simples. Você escolhe o formato de saída e o caminho. No meu caso, costumo salvar em Parquet porque é mais eficiente em espaço e velocidade de leitura posterior. processor_output = Outputter(format='parquet', destination='resultado.parquet')
Aí você conecta tudo num pipeline e roda. O ciclo completo de configuração e execução costuma levar uns 15 minutos na primeira vez, dependendo de quão bem documentado está o seu dataset.
O problema que eu encontrei e a solução que funcionou
Num projeto recente, eu tentei processar um arquivo de 2 GB com o modo default e o processo travou na metade. A memória RAM do servidor encheu inteira e o processo foi morto pelo SO. A solução foi migrar para o modo streaming, dividindo o arquivo em chunks de 50 MB. A diferença foi brutal: de um processo que nem completava em 3 horas, para 22 minutos rodando em streaming. Mas teve outro detalhe chato. O processor, ao ler os chunks, estava interpretando mal algumas células com valores vazios que continham espaços em branco. O campo parecia vazio mas na verdade tinha espaços, então o filtro de tipagem rejeitava a linha. A solução foi adicionar um step de limpeza prévia com regex, removendo whitespace de todas as strings antes do processamento principal. Eu fiz isso como um filtro customizado no meio do pipeline, entre o collector e o processor. Resolveu em dois dias de debugging.

Limitações que você precisa saber antes de começar
O academia fitway rau não é uma bala de prata. Tem limitações sérias que o material de marketing nunca menciona. Primeiro, o suporte a formatos proprietários é limitado. Se você tiver dados em Excel com múltiplas abas e formatação condicional, o collector vai ler apenas a primeira aba como um DataFrame simples. As macros e fórmulas somem. Segundo, a documentação dos filtros customizados é fraca. Se você precisar de um filtro que não existe na biblioteca padrão, vai ter que escrever do zero e testar bastante. Terceiro, a versão atual não lida bem com dados temporais que têm fusos horários diferentes misturados no mesmo arquivo. Eu já vi o processor converter tudo para UTC sem avisar, o que em alguns casos gerou resultados com datas deslocadas em horas. Se o seu dataset tem essa característica, você precisa normalizar os fusos antes de passar pro collector. Quarto, o output em JSON tem um bug conhecido onde arrays aninhados com mais de três níveis de profundidade são truncados silenciosamente. Não gera erro, só corta os dados. Se você trabalha com estruturas hierárquicas complexas, prefira Parquet ou evite JSON como formato de saída.
Alternativas quando academia fitway rau não for suficiente
Se o seu caso de uso envolve dados muito irregulares ou formatos exoticos, considere avaliar ferramentas como Apache Spark ou Polars antes de insistir no academia fitway rau. Elas têm curva de aprendizado maior mas são mais resilientes a edge cases. O academia fitway rau brilha em pipelines-sized com estrutura relativamente previsível. Fora disso, você vai passar mais tempo contornando limitações do que ganhando produtividade. Para quem quer baixar ou acessar o repositório oficial, o academia fitway rau está disponível no GitHub e no PyPI. A documentação principal fica no site oficial, mas eu recomendo também dar uma olhada nos issues abertas do repositório, porque lá você encontra soluções para problemas que a documentação não cobre. É onde eu resolvi a questão dos chunks com valores vazios, por exemplo.
Galeria
-
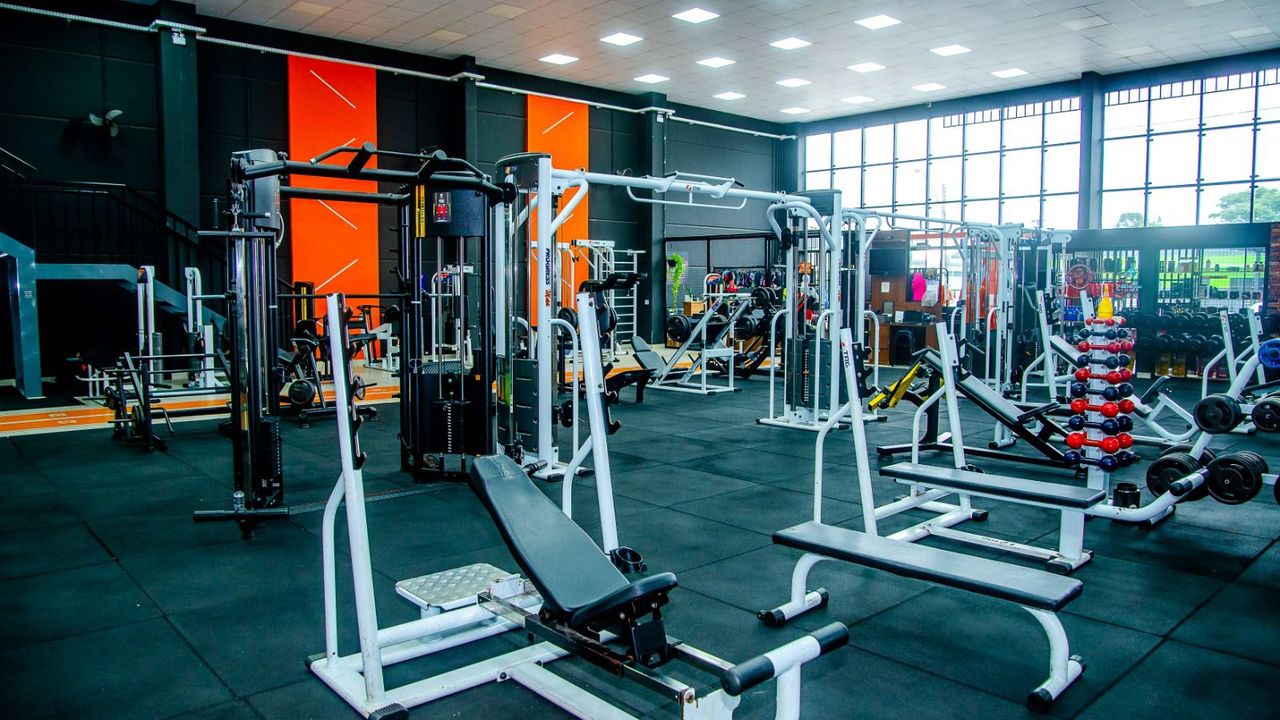
Academia Fitway - A hipertrofia é um aumento e crescimento... -
ACADEMIA FITWAY (@fitwayacademias) • Instagram photos and videos -
Academia Fitway | Jaraguá do Sul SC


