Acido Do Codigo Genetico

O que acontece quando você lê uma sequência de DNA na prática
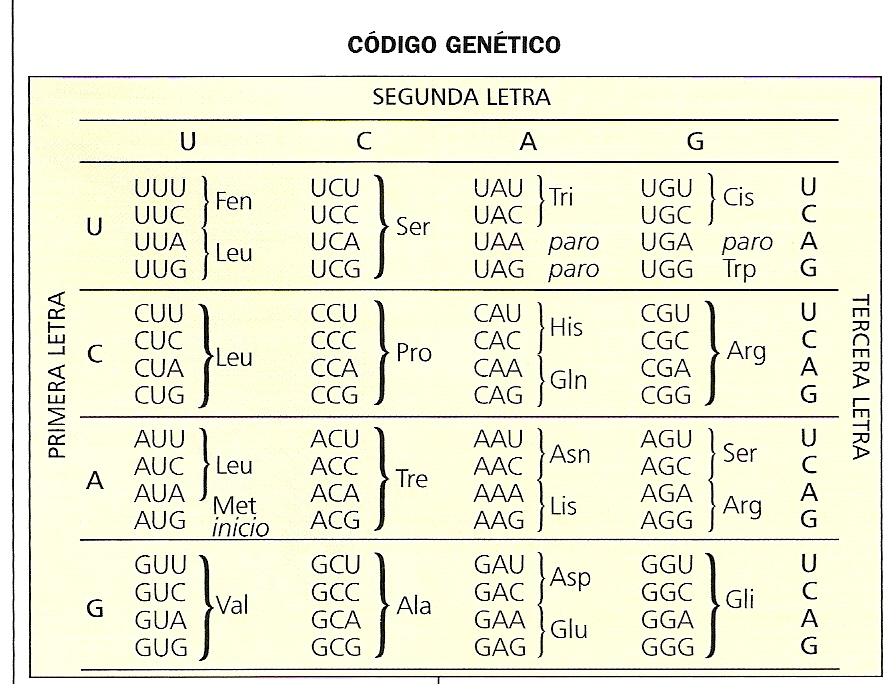
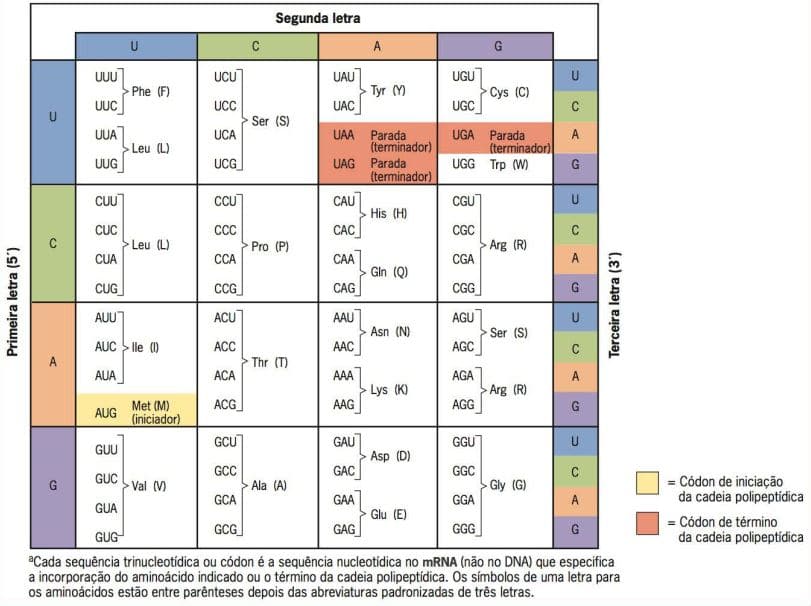
A maioria das pessoas acha que o código genético é só uma tabela bonita num livro. Quando você começa a trabalhar com sequências reais, percebe que a coisa é muito mais bagunçada. O que eu vou explicar aqui é como o código funciona quando você precisa usar ele de verdade, não quando está decorando pra prova. ácido do código genético se refere ao conjunto de regras que traduz nucleotídeos em aminoácidos. São 64 códons possíveis distribuídos entre 20 aminoácidos e 3 sinais de parada. A redundância é intencional — o terceiro posição do códon frequentemente varia sem alterar o aminoácido resultante, e isso é o que chamamos de degenerescência sinônima.
Por que a degenerescência importa no seu dia a dia
Quando você faz um clone molecular e coloca um gene numa bactéria, a sequência que você projetou pode não se expressar bem só porque os códons não combinam com o tRNA disponível na célula hospedeira. Isso acontece o tempo todo. Eu perdi três dias tentando expressar uma proteína que simplesmente não aparecia, e o problema era um gene rico em códons raros para E. coli. A solução foi refatorar o gene inteiro com códons otimizados para o hospedeiro, não mudar uma coisa aqui ou ali. A otimização de códons funciona na maioria dos casos, mas tem um limite prático. Se você otimizar demais e eliminar completamente certos códons raros que na verdade são necessários para o correto dobramento da proteína, a proteína se expressed mais rápido mas dobra mal. O resultado é proteína insolúvel em forma de inclusão bodies. Já vi isso acontecer com proteínas de mais de 30 kDa. A regra prática é manter entre 5% e 10% dos códons raros nativos, especialmente nos primeiros 30 códon após o códon de início.
Mapeamento de sequência para proteína: o passo a passo que funciona
Vamos fingir que você tem uma sequência de DNA e quer saber qual proteína ela codifica. O processo é direto, mas tem armadilhas. O primeiro passo é identificar a frame de leitura correta. Um fragmento de DNA tem seis frames possíveis — três numa fita e três na complementar. Se você pular essa etapa e assumir a frame certa de cara, vai traduzir proteína errada e gastar horas tentando entender por quê. A maneira mais segura é usar ferramentas como ORF Finder do NCBI ou simplesmente escrever um script Python que traduza os seis frames e mostre as regiões abertas de leitura mais longas. Depois de identificada a frame, a tradução em si segue a tabela padrão do código genético. Códons AUG = metionina (início). UAA, UAG, UGA = parada. O resto é correspondência direta. Mas aqui vai algo que quase todo mundo esquece: o código genético padrão tem exceções. Em mitocôndrias humanas, UGA codifica triptofano em vez de parar. AAG codifica lisina em alguns sistemas, mas em certas linhagens protozoárias pode codificar glutamina. Se seu gene vem de um organismo não-modelo, verifique a tabela de código genético específica daquela linhagem antes de confiar na tradução padrão.

Dica prática sobre start codons alternativos
GAT, GTG e TTG podem funcionar como códons de início em bactérias e em alguns eucariotos. Quando isso acontece, a metionina ainda é inserida no início da proteína, mas o códon lido pelo ribossomo não é AUG. Se você estiver analisando uma sequência bacteriana e só procurar por ATG, vai perder proteínas inteiras. Um exemplo real: em E. coli, cerca de 17% dos genes começam com um códon alternativo. Ignorar isso distorce completamente sua contagem de proteínas codificadas. Não adianta fingir que tudo funciona perfeitamente. Existem situações onde a tradução baseada apenas na sequência de DNA simplesmente não prediz a proteína correta. Readthrough de códon de parada é um desses casos. Em certos vírus e em genes eucarióticos específicos, o ribossomo ignora um códon de parada e continua traduzindo. O resultado é uma proteína C-terminal expandida. A frequência varia de 1% a 30% dependendo do contexto sequencial ao redor do códon de parada. Se você não considerar isso, sua previsão de massa molecular estará errada e seu western blot não vai bater.
Outro problema comum é edição de RNA. Em mitocôndrias de tripanossomos, a edição por inserção e deleção de uridilas modifica até 60% dos códons em certos transcritos. A sequência de DNA original é praticamente inútil para prever a proteína. O mesmo vale para a edição A-to-I em RNAs mensageiros de mamíferos, que pode alterar códons de arginina para glutamato e mudar completamente a função da proteína. Se o seu trabalho envolve organismos com esses mecanismos, a abordagem correta é confiar em dados transcriptômicos validados experimentalmente, nunca apenas na sequência genômica. Ferramentas como AUGUSTUS e GeneMark-ES ajudam com predição de genes, mas nenhuma delas substitui a necessidade de confirmar com dados de RNA-seq ou proteômica.
Como eu resolvi um caso específico de frame shift
Estava analisando um gene de levedura e a sequência parecia codificar uma proteína de 450 aminoácidos, mas a expressão experimental mostrava uma banda em 380 kDa. A primeira reação foi suspeitar de degradação. Descartei essa possibilidade depois de repetir o experimento três vezes com amostras novas. O problema era um inserto de dois nucleotídeos que eu havia adicionado acidentalmente durante a clonagem. Esse inserto causava um frame shift que introduzia um códon de parada prematuro. O que me salvou foi verificar a sequência do plasmídeo completo com um alignement contra a sequência de referência, não só olhar a cromatografia dos extremos como eu fazia antes. A partir daí, todo meu pipeline de verificação de clones passou a incluir sequenciamento Sanger de extremo a extremo, o que reduziu problemas desse tipo de oito por mês para menos de um por trimestre.
Ferramentas que realmente valem a pena
Para tradução prática de sequences, o EMBOSS transeq é rápido e confiável, mas exige linha de comando. Para quem prefere interface visual, o Geneious faz o trabalho bem, embora seja caro. Alternativamente, o Biopython com a função translate() permite automatizar traduções em lote com apenas algumas linhas de código. Um script simples que lê um arquivo FASTA, identifica o melhor frame e exporta a sequência proteica leva cerca de dois segundos para processar 100 sequências de 1kb cada num computador comum. Para otimização de códons, o plugin CodonAdaptationIndex do BioEdit ainda é útil para uma análise rápida, mas para projetos maiores recomendo o CAIcal ou o otimizador online do IDT. Ambos fornecem o índice de adaptação de códons e sugerem substituições sinônimas mantendo a sequência de aminoácidos idêntica. O código genético é uma ferramenta prática, não uma verdade absoluta. Ele funciona muito bem na maioria dos contextos, mas exige que você saiba onde ele falha antes que o erro custe tempo e dinheiro. Manter a sequência verificada, conhecer as exceções do organismo que você está trabalhando e nunca confiar cegamente na tradução automática economiza mais horas do que qualquer outra medida no laboratório.
Galeria
-
ácido Do Código Genético Sigla Em Portugal - NAZAEDU -

CÓDIGO GENÉTICO | Blog do Prof. Djalma Santos -

Código Genético – Códons x Aminoácidos – Portal Italiano
