Alfabeto Letras De Computador
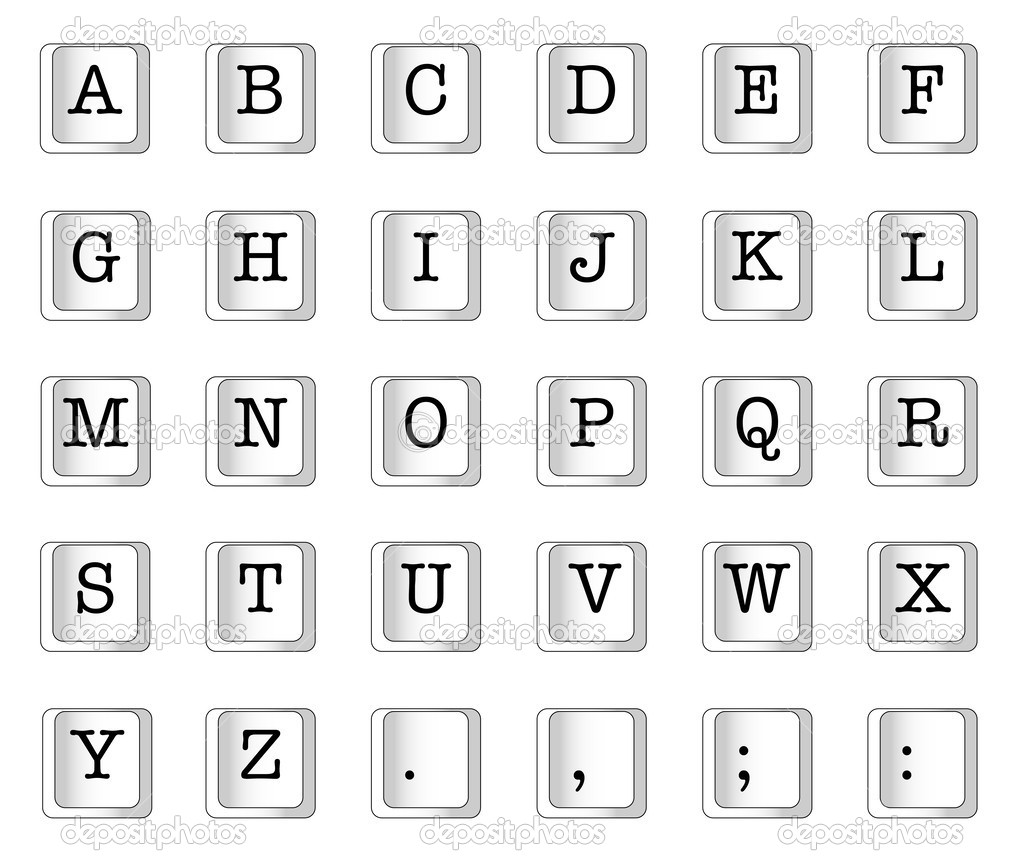
Como funciona o teclado de computador na prática
A maior parte das pessoas digita sem pensar no que está acontecendo. O alfabeto letras de computador no Brasil segue basicamente o padrão ABNT2, que é uma variação do layout QWERTY com teclas acentuadas específicas para o português. O A, o B, o C estão onde todo mundo espera que estejam, mas é nos detalhes que as coisas começam a complicar. Existe uma confusão constante entre letra e caractere. Quando você aperta a tecla A, o computador recebe o código ASCII 65. Quando aperta Shift+A, recebe 65 novamente, só que em maiúsculo. Para palavras acentuadas como "café" ou "ação", não há uma tecla única — você precisa usar combinações. Esse é o primeiro filtro que separa quem sabe digitar de quem sabe resolver problemas.
alfabeto letras de computador
O layout mais comum no Brasil é o ABNT2, que adiciona duas teclas específicas: Ctrl à esquerda do A e uma tecla de Ç na parte inferior direita. Teclados importados dos EUA ou da Europa muitas vezes não têm essas teclas, então quem trabalha com português em hardware estrangeiro acaba fazendo adaptações. A tecla AltGr (a terceira à direita da barra de espaço) é subutilizada na maioria dos escritórios, mas ela abre acesso a caracteres como ©, €, ™ e vários símbolos técnicos sem precisar passar pelo menu de caractere especial. Se você precisa digitar palavras com ç sem essa tecla dedicada, a sequência rápida é manter AltGr pressionado e clicar na tecla que tem o símbolo do ç impresso — normalmente a que está à direita da letra P. Funciona no Windows e na maioria das distribuições Linux. No macOS, o padrão é diferente porque o sistema operacional trata acentos de outra forma, e muitos brasileiros que migram levam semanas se adaptando. Já enfrentei um problema específico com um sistema legado interno que usava mapeamento de teclas customizado via registerkey. O software substitua automaticamente a combinação AltGr+C por uma string binária específica que o banco de dados antigo exigia. Quando atualizei um micro novo com um teclado ABNT2 genérico, o mapeamento quebrou porque o driver padrão não reconhecia a mesma configuração. A solução foi instalar o pacote de drivers do fabricante original do teclado e aplicar um arquivo .inf que restaurava o comportamento do registro. Sem isso, o sistema inteiro parava de aceitar inputs normais e entrava em loop de reconhecimento de tecla. Levou cerca de três horas para deixar funcionando, mas depois disso o processo de digitação ficou estável por anos.
Entendendo codificação de caracteres
Letras de computador são, na base, números. O ASCII original mapeia 128 caracteres, cobrindo o alfabeto latino em maiúsculas e minúsculas, números de 0 a 9, e sinais de pontuação básicos. O ISO-8859-1, também chamado de Latin-1, expandiu isso para 256 posições e incluiu acentos como á, ê, ã, ç. Esse era o padrão dominante em sistemas antigos e ainda aparece em arquivos legados. O UTF-8 é o padrão atual e substituiu praticamente tudo. Ele é compatível com ASCII para os primeiros 128 caracteres, mas usa codificação variável para o restante. Uma letra como ã ocupa dois bytes, e caracteres de idiomas como árabe ou chinês podem ocupar três ou quatro. Isso significa que arquivos que antes tinham tamanho fixo agora variam. Tabelas de banco de dados que usavam VARCHAR com comprimento fixo precisam ser repensadas quando migradas para UTF-8. Um erro comum é assumir que todos os caracteres acentuados precisam de Unicode. Na verdade, para textos exclusivamente em português brasileiro, o ISO-8859-1 funciona perfeitamente e consome metade do espaço em alguns contextos de armazenamento. O problema é que sistemas modernos raramente permitem essa escolha, então você acaba usando UTF-8 mesmo quando não precisa.
Teclas de acesso rápido que realmente importam
Além do básico, existem combinações que resolvem problemas recorrentes. Ctrl+Shift+K no Linux e no ChromeOS abre o menu de idiomas e layout de teclado instantaneamente. No Windows, Alt+Shift ou Win+Barra de Espaço alterna entre idiomas instalados. Essas atalhos salvam muito tempo quando você alterna entre trabalhos em português e inglês no mesmo dia. A tecla Caps Lock é outro ponto problemático. Muita gente deixa ativado acidentalmente e perde minutos tentando entender por que todas as letras saem maiúsculas. Há soluções como desabilitar Caps Lock completamente no registro do Windows ou usar ferramentas como SharpKeys para redefinir sua função. Eu pessoalmente nunca morei sem Caps Lock desativado desde 2018 — nunca mais tive esse problema. Outro recurso pouco conhecido é o mapa de caracteres do Windows (charmap.exe) e o equivalente no Linux, que permitem copiar e colar qualquer caractere Unicode. Se você precisa inserir um símbolo como ™, ©, ® ou letras gregas em um documento, essa ferramenta economiza a busca no Google. No macOS, o Visor de Caracteres faz o mesmo.
Problemas com teclados importados e layouts diferentes
Teclados vendidos como "internacionais" frequentemente seguem o layout ANSI dos EUA, que não tem tecla de Ç nem AltGr nativo. O resultado é que a acentuação precisa ser feita por software, usando sequências de combinação que funcionam apenas em certos sistemas operacionais. No Windows, isso é resolvido com o mapeamento ABNT2 nas configurações de idioma. No Linux, o comando setxkbmap br abnt2 resolve rapidamente. No macOS, o suporte a acentos portugueses existe mas a disposição das teclas é diferente do esperado por quem veio do Windows. Um detalhe que quase ninguém menciona: a tecla de Ç no ABNT2 está na posição onde o teclado americano teria a tecla Backslash e Barra. Quem troca de teclado frequentemente acaba digitando errado por muscle memory. Leva cerca de duas semanas de uso diário para o cérebro se reconfigurar, mas durante esse período os erros de digitação aumentam consideravelmente.
Quando o alfabeto de computador não funciona
Nem todo sistema lida bem com acentos. Programas antigos feitos para DOS ou Windows frequentemente assumem código page 437 ou 850, o que resulta em caracteres estranhos quando arquivos com UTF-8 são abertos. Esse problema é especialmente comum em sistemas industriais, caixas eletrônicas e equipamentos médicos que rodam software envelhecido. A solução geralmente é converter o arquivo para o codepage correto antes de processá-lo, usando ferramentas como iconv no Linux ou o próprio Notepad++ no Windows para fazer a conversão. Outro cenário problemático é a digitação em terminais SSH para servidores remotos. Se o cliente SSH não estiver configurado para UTF-8, os acentos saem incorretos no terminal. Configurar a variável de ambiente LANG=pt_BR.UTF-8 ou ajustar as preferências do terminal resolve. Esse é um erro que aparece com frequência em ambientes corporativos onde a infraestrutura não foi modernizada há anos. Para quem precisa de um guia rápido de referência, a documentação oficial do layout ABNT2 está disponível no site da ABNT, mas a maioria das informações práticas sobre codificação e atalhos pode ser encontrada diretamente nas documentações do sistema operacional que você estiver usando.

Galeria
-

Letras De Computador Alfabeto - RETOEDU -
Alfabeto Letras De Computador - RETOEDU -

Alfabeto Letras De Computador - RETOEDU
