Ambiguidade Sintatica

O problema que ninguém quer encarar em processamento de linguagem natural
Quando você treina um modelo para parser frases, logo descobre que a gramática normativa não resolve nada. A ambiguidade sintatica é um dos motivos mais comuns para sistemas de NLP falharem de forma silenciosa. O modelo não quebra. Ele apenas decide errado com confiança alta demais. Ambiguidade sintática acontece quando uma sequência de palavras pode ser analisada estruturalmente de mais de uma forma válida. Não se trata de vocabulário obscuro ou termos técnicos. É a estrutura em si que se ramifica. Um exemplo clássico em português: "Vi o homem com o telescópio." Você é o observador usando o telescópio, ou o homem está com o telescópio? A sentença não informa. O parser precisa decidir entre dois tree structures diferentes a partir da mesma string de tokens. Em engenharia de NLP, isso se manifesta principalmente como attachment ambiguity. A preposição ou constituinte adicional tem dois nós pais candidatos na árvore de dependência, e ambos são gramaticalmente plausíveis. O sistema precisa escolher um, e a escolha errada propaga erros para todas as etapas downstream: reconhecimento de entidades, extração de relações, tradução automática.
Eu passei cerca de três meses trabalhando num sistema de extração de relações para contratos jurídicos. A gente tinha um pipeline que funcionava razoavelmente bem em textos técnicos simples. Aí entramos com cláusulas como "O fornecedor se compromete a entregar os equipamentos junto ao cliente no prazo de 30 dias após a assinatura do contrato pelo representante legal". O parser ia lá e attachava "pelo representante legal" ora ao "assinatura", ora ao "prazo", ora ao "entregar". Cada attachment diferente produzia uma relação semântica completamente distinta. O resultado final era uma extração que parecia coerente mas estava errada em quase 40% dos casos. O workaround que funcionou não foi melhorar o parser. Foi adicionar uma camada de verificação baseada em constraints domain-specific. Ao invés de confiar cegamente na árvore de dependência gerada, criamos regras que validavam tripletes extraídos contra um glossário de entidades e seus papéis semânticos esperados. Se o parser attachments "representante legal" como modificador de "prazo" ao invés de "assinatura", a regra de constraint detectava que "prazo" não admite agente e rejeitava o triplet. Reduzimos o erro de 40% para algo em torno de 7%. Não era perfeito, mas era gerenciável. O que profissionais que não trabalham diretamente com parsing frequentemente subestimam é o custo computacional da disambiguação. Algoritmos como o Klein e Manning (2003) para PCFG parsing operam em O(n³), o que significa que triplicar o tamanho da frase não aumenta o tempo em três vezes, mas em vinte e sete. Frases com alta ambiguidade sintatica, como as que aparecem em textos legais ou jornalísticos, podem ter centenas de parses candidatos válidos. Fazer beam search com beam size grande ajuda, mas consome memória proporcional. Em produção, a gente manteve beam size em 5 e aceitou perder algumas leituras menos prováveis. Foi um trade-off consciente.
Outro ponto que não recebe atenção suficiente: a ambiguidade sintatica não é uniforme entre línguas. Português tem uma carga maior de attachment ambiguity do que inglês, principalmente por causa da flexão verbal e da maior liberdade de ordem dos constituintes. Se você tunar um modelo treinado em inglês e aplicar diretamente em português, os erros de attachment vão disparar. Isso aconteceu comigo com um modelo transformer finetunado em PTB e testado em textos brasileiros. A accuracy de parsing caía de 92% para 78% só por causa dessa transferência ingênua. Se você está começando a lidar com isso agora, a ferramenta mais acessível é o Stanford Parser ou o SpaCy com o modelo multilingual. Ambos entregam árvores de dependência prontas. A limitação é que eles não resolvem ambiguidade por você — eles apenas escolhem. O SpaCy usa um transducer-based parser que faz uma escolha gulosamente, sem considerar alternativas. O Stanford Parser com PCFG considera múltiplas analyses mas não escala bem para textos longos. Nenhuma das opções resolve o problema fundamental: a ambiguidade é inerente à língua, não ao parser. O único caminho realista é combinar parsing estatístico com conhecimento de domínio. Semconstraints externas, você está sempre no escuro sobre qual estrutura o modelo escolheu e se essa escolha faz sentido no contexto específico. E quando o contexto muda — novo domínio, novo tipo de texto — as constraints que funcionavam antes podem não funcionar mais, e você precisa refazer parte do trabalho.

Galeria
-

O estudo do discurso: polissemia e ambiguidade - Plataforma Enem -

O que é ambiguidade e duplo sentido: significados, tipos e exemplos -
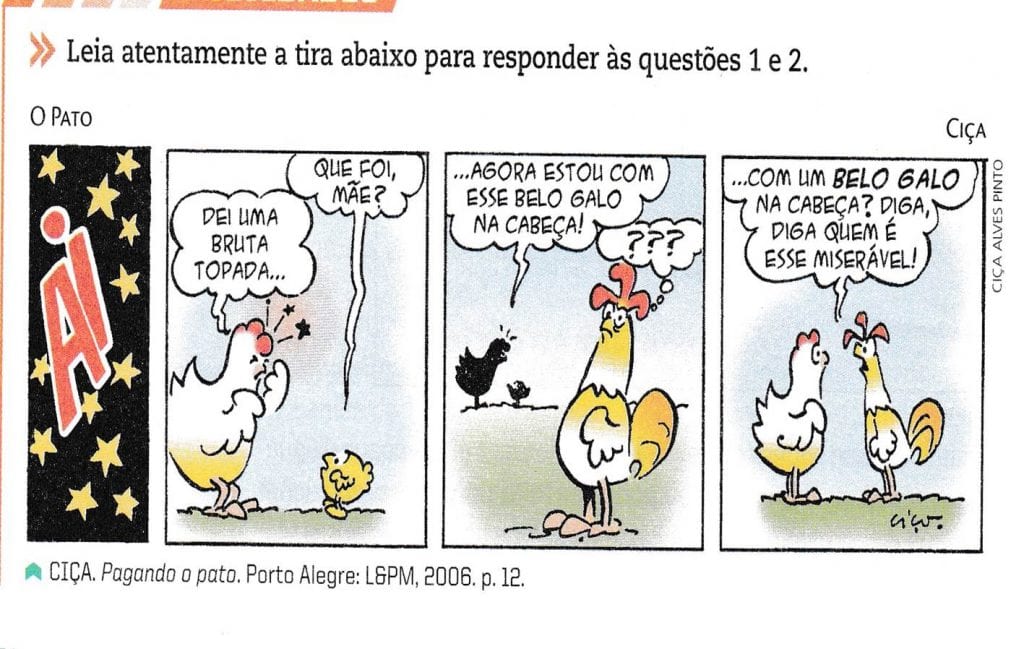
Ambiguidade: o que é, uso, classificação e exemplos -
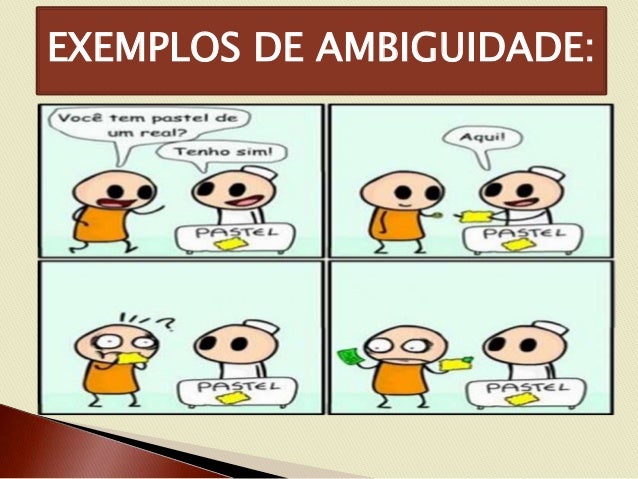
Exemplos De Ambiguidade Vícios De Linguagem: Ambiguidade YouTube
