Amostragem Probabilistica E Não Probabilistica
Entendendo os dois tipos de amostragem na prática
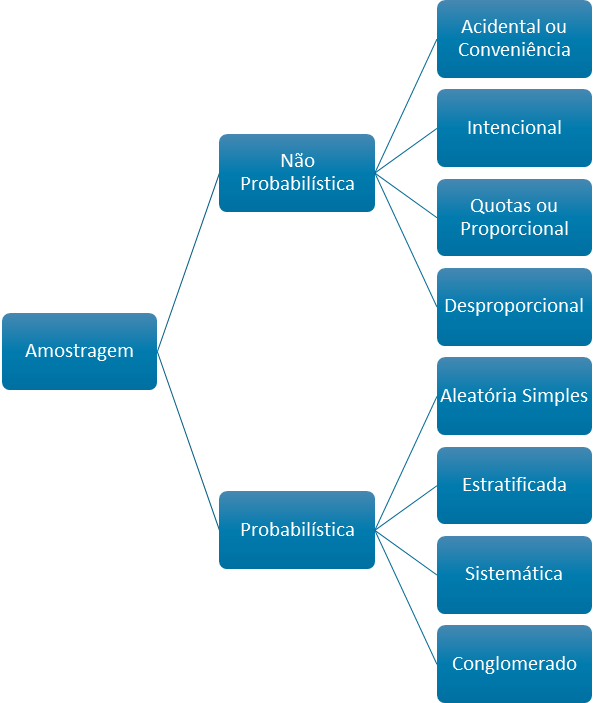
A gente costuma dividir a seleção de amostras em dois grandes grupos: amostragem probabilistica e não probabilistica. A diferença real entre eles não é só teoria de livro didático, ela muda completamente como o projeto é executado no campo. Eu já vi equipe inteira gastar semana inteira com um desenho de amostra que nunca ia funcionar porque quem desenhou não entendeu onde cada método se encaixa. Amostragem probabilística é aquela em que todo elemento da população tem uma chance conhecida, diferente de zero, de ser selecionado. O rigor aqui é técnico mesmo. Você precisa de uma lista de amostragem (framework) atualizada, e o erro amostral é calculável com fórmulas padrão. Intervalos de confiança, margem de erro, potência do teste — tudo se sustenta na base probabilística. Se um desses pilares falta, o número que sai do modelo não tem fundamento estatístico.
Amostragem probabilistica e não probabilistica: o que muda no dia a dia
No dia a dia da pesquisa aplicada, a amostragem probabilística aparece quando você precisa generalizar para uma população definida. Censo eleitoral, pesquisa domiciliar com frame oficial, auditoria de estoque com unidades listadas. A amostragem não probabilística aparece quando o frame não existe ou quando o objetivo não é generalização estatística, e sim compreensão qualitativa, validação de hipóteses, geração de insights para o produto. Isso inclui convenience sampling, snowball sampling, quota sampling e judgmental sampling. Um detalhe que muita gente erra: quota sampling não é a mesma coisa que probabilidade. Você pode controlar idade, gênero, região na amostra, mas como a seleção dentro de cada cota é feita por conveniência, o viés de seleção continua lá. O viés não some só porque os pesos parecem bonitos no relatório. Meu caso prático: em 2023 eu fui chamado para revisar uma pesquisa de satisfação de uma operadora de telecomunicações que usava amostragem por quota online para medir NPS em todo o Brasil. O frame era a base de clientes ativos, mas a coleta era feita por convite em apps próprios, com cotas por região e plano. A amostra tinha 4.200 respostas e os números pareciam sólidos. Quando eu peguei o frame original e fiz uma simulação de Monte Carlo com seleção aleatória simples estratificada pelas mesmas cotas, a média de NPS oscilou 11 pontos percentuais para baixo no pior cenário. O problema real era que usuários insatisfeitos tinham muito mais probabilidade de abrir o app e responder ao convite do que usuários satisfeitos, que simplesmente não acessavam. A amostra por quota mascarou um viés de autopreenchimento severo.
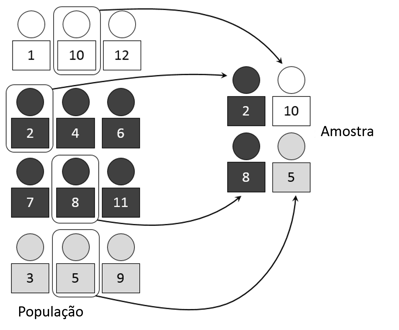
O workaround que eu implementei foi híbrido. Nós mantivemos a estrutura de cotas para controle operacional, mas trocamos a seleção dentro de cada cota por drawing probabilístico direto do frame, usando números aleatórios gerados a partir de seed auditável. Quando o volume de respostas ainda não atingia a meta da cota, aí sim entrava um pequeno componente de conveniência, mas com ponderação por inverso da probabilidade de seleção, incluindo a probabilidade de convite aceite. O resultado foi uma amostra com margem de erro calculável de 1,4 ponto percentual para a média geral, contra a impossibilidade anterior de estimar qualquer margem. A amostragem probabilística mais usada no campo segue algumas variações que valem a pena conhecer com details, não só nomes. Amostragem aleatória simples é o baseline teórico, mas raramente é a melhor escolha prática porque ignora variações strata. Estratificada divide a população em grupos homogêneos e sortea dentro de cada um; isso reduz variância quando as variáveis de estratificação explicam parte da variabilidade do indicador. Clusters é quando você sorteia unidades maiores (setores censitários, escolas, hospitais) e investiga todos os elementos dentro delas; economiza custo de campo, mas aumenta o erro devido ao design effect. Sistemática é prática e fácil de executar, desde que a lista não tenha padrão oculto que coincida com o período de amostragem — esse é um erro clássico que já me custou projetos inteiros quando a lista de chamadas telefônicas tinha ordem alfabética e o intervalo coincidia com um lote de números iguais por região. O design effect é um conceito que começa como detalhe técnico e vira problema real rapidamente. Em clusters, o de costuma ficar entre 1,5 e 2,5 dependendo da homogeneidade intracluste. Isso significa que, para a mesma precisão, você precisa de 50 a 150 por cento mais observações do que numa amostragem aleatória simples. Muitos relatórios escondem isso apresentando margem de erro como se fosse SRS. O correto é ajustar o tamanho da amostra antes do campo, não depois.

Já na amostragem não probabilística, os problemas são diferentes. Viés de seleção é apenas o mais óbvio. Tem também o viés de informação, quando o instrumento de coleta responde de forma diferente conforme o perfil do participante. Tem o problema da validade externa, que é outro nome para generalização impossível. E tem a tentação de transformar dados não probabilísticos em números aparentes com técnicas de pós-estratificação ou propagação de pesos, o que pode produzir estimativas numericamente bonitas mas estatisticamente infundadas. Uma coisa que eu vejo todo mundo subestimar: purposive sampling, quando bem feito, pode ser mais informativo do que uma amostra probabilística mal desenhada. O truque é ser transparente sobre o critério de seleção e não fingir que os resultados representam a população. Se você está estudando adoção de tecnologia em founders de startups series A, recrutar dez founders por conveniência de rede e entrevistar em profundidade gera insights úteis. Chamar esses dez de "amostra representativa" é o que quebra a credibilidade do trabalho. Quanto a tools e workflows práticos, a decisão começa antes de qualquer software. Primeiro você define a população-alvo com recorte temporal e geográfico explícito. Segundo, verifica a existência e qualidade do frame. Terceiro, escolhe o desenho de amostra com base no objetivo: generalização quantitativa pede probabilidade; exploração, teste de conceito ou acesso a populações de difícil alcance pede não probabilidade. Quarto, calcula o tamanho da amostra com as fórmulas corretas para o desenho escolhido, incluindo design effect quando aplicável. Quinto, documenta tudo em protocolo antes do campo, porque revisões post hoc são a principal fonte de reprovação em auditorias.
Para amostragem probabilística, ferramentas como R com a biblioteca survey, Stata com os comandos svy, ou mesmo Excel com funções adequadamente estruturadas para pesos e complexidade de desenho funcionam. Para amostragem não probabilística, o diferencial não está no software, mas no registro minucioso de critérios de inclusão e exclusão, fluxo de participantes e análise de sensibilidade. Uma análise de sensibilidade simples, variando assumptions de seleção, costuma revelar em duas horas o quanto sua conclusão dependia de suposições frágeis. Limitações sérias existem em ambos os lados. Probabilística depende de frame completo e acessível; quando o frame falha, a generalização morre, não importa o quão bem o sorteio seja executado. Populações sem cadastro formal, trabalhadores informais, moradores de rua, comunidades isoladas — todas sofrem com viés de cobertura que nenhuma correção pós-amostra elimina de verdade. Não probabilística depende de transparência e rigor qualitativo; sem isso, vira coleção de anecdotes com rótulo de dado. Se você precisa de um caminho rápido para implementar probabilística em projetos pequenos, comece com amostragem estratificada proporcional usando software livre e um frame atualizado. Se o frame não existe, considere amostragem por conglomerados em etapas com pesagem por inverso da probabilidade, mas registre desde o início que a precisão será menor e que a extrapolação tem limites definidos. Para não probabilística, adote um protocolo escrito com critérios de seleção explícitos, reporte limites de generalização na primeira página do documento e, sempre que possível, valide achados com uma segunda leva de coleta ou com dados secundários.
O que separa um trabalho sério de um que parece sério é a trilha auditável. Qualquer pessoa consegue replicar seu desenho de amostra a partir do que você escreveu, saber exatamente como cada unidade entrou na amostra e calcular, se quiser, como os resultadosiam sob assumptions alternativas. Quando isso existe, probabilística e não probabilística deixam de ser categorias de combate e passam a ser ferramentas escolhidas com critério.

Galeria
-
Tipos de Amostragem Probabilística e Não Probabilística | PDF ... -
Amostragem probabilística e não probabilística -

Amostragem Probabilistica E Não Probabilistica - RETOEDU

