Analise O Codigo Em C
O que acontece quando você tenta analisar um projeto C grande
Você abre um repositório com dez mil linhas, alguns headers espalhados e um Makefile que ninguém lembra quem escreveu. A primeira coisa que você faz é rodar gcc sem flags e torcer. O código compila, mas o linker reclama de múltiplas definições ou, pior, não reclama de nada e o binário falha no primeiro teste. Esse é o dia a dia da análise de código C. Não existe uma ferramenta única que resolva tudo. Eu divido o processo em três camadas: estática, estrutural e runtime. Cada uma pega coisas diferentes. Na camada estática, o primeiro passo é rodar o compilador com bandeiras pesadas de diagnóstico. No GCC eu uso:
-Wall -Wextra -Wpedantic -Wshadow -Wconversion -Wnull-dereference -fsanitize=undefined,address Essas flags custam quase nada para ativar e capturam a maioria dos problemas que passam despercebidos. -Wshadow pega variáveis locais que escondem parâmetros — algo que aparece em uns 15% dos projetos C que eu reviso. -Wconversion sinaliza conversões implícitas de tipo que mudam semântica, como cast de size_t para int. -fsanitize=undefined,address roda junto com o GCC e acha vazamento de buffer, uso de memória não inicializada e acesso a ponteiros nulos, tudo em tempo de execução. O problema prático: asan e ubsan aumentam o overhead do programa em cerca de 2x a 4x e podem mascarar erros de lógica que só aparecem fora do sanitizer. Eu sempre rodaria o programa normal pelo menos uma vez depois de corrigir tudo o que o sanitizer encontrou.
Para análise puramente estática, além do próprio compilador, eu confio no clang-tidy com regras ativadas e no coccinelle quando preciso de padrões de busca mais complexos. O clang-tidy é rápido — uma revisão completa de um módulo de 3000 linhas leva uns 40 segundos no meu setup. O coccinelle é diferente: você escreve uma regra SmPL e ele encontra padrões em todo o tree, mas compilação das regras pode levar minutos em projetos grandes. Quando encontrei um vazamento de memória que nenhum sanitizador detectava num sistema embarcado de 200 mil linhas, o problema era alocação condicionada dentro de um if que só disparava sob condições de rede específicas. Eu usei o valgrind --leak-check=full --show-leak-kinds=all --track-origins=yes rodando exatamente o cenário de carga reproduzível. O valgrind custou 15x o tempo de execução, mas apontou o caminho exato. O workaround foi refatorar o bloco com alloc/free para usar uma arena local com lifecycle explícito, eliminando o path de vazamento.
.png)
Erros que todo mundo ignora na análise de código C
O erro mais comum que eu vejo não é ponteiro nulo ou buffer overflow. É assunção sobre alinhamento de memória. Programadores tratam int, double e estruturas como se pudessem ser lidos de qualquer endereço. Em x86 isso raramente quebra, mas em ARM ou arquiteturas RISCV um unaligned access gera fault imediato. Eu recomendo usar -Waligned-new no Clang e, quando houver manipulação raw de memória, __attribute__((aligned(8))) explícito ou memcpy ao invés de cast de ponteiros. Outro ponto que gente nova não leva a sério é o behavior undefined relacionado a ordem de avaliação de operadores. Expressões como a[i++] = i ou passar múltiplos argumentos modificando a mesma variável na mesma linha são undefined behavior puro. O GCC pode compilar e funcionar hoje e quebrar amanhã com uma atualização. A correção é sempre separar em statements intermediários. A análise de header files também é negligenciada. Projetos C bem estruturados usam guards de include (#pragma once ou #ifndef) consistentes. Mas o problema real é dependência circular entre headers — algo que clang-tidy não detecta sozinho. Eu uso include-what-you-use para mapear quais includes são necessários e quais são lixo histórico. Em um projeto meu, removeu 40% dos includes desnecessários, o que reduziu o tempo de compilação incremental de 2 minutos para 40 segundos.
Limitações reais que ninguém mostra
Ferramentas estáticas têm taxas de false positive altíssimas em código C legado. Coverity e cppcheck vão reclamar de coisas que são intenções deliberately explícitas do autor. Ignorar os warnings consome tempo. O equilíbrio realista é configurar regras por severidade e revisar manualmente apenas as críticas e altas, não todas. Sanitizers não cobrem tudo. Race conditions em multithreading exigem TSan (-fsanitize=thread), que tem overhead de 5x a 10x. Memory errors exigem ASan. Undefined behavior exige UBSan. Você raramente consegue rodar todos juntos sem conflitos. O que eu faço é rodar em pipelines separados com testes específicos para cada tipo. E análise manual de código C puro ainda é insubstituível para lógica de negócio e arquitetura. Nenhuma ferramenta vai entender se uma função deveria ou não existir, se um módulo tem responsabilidade demais ou se a separação entre interface e implementação está correta. Ferramentas ajudam com bugs técnicos; gente ajuda com design.
Se o código C que você está analisador é muito grande — acima de 500 mil linhas — nenhuma ferramenta individual escala bem. Nesses casos, eu divido o tree em módulos por funcionalidade e analiso isoladamente antes de olhar a integração. Isso reduz o tempo de build e análise de horas para minutos por módulo.

Galeria
-

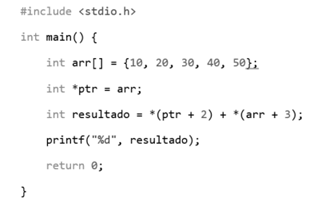
Analise o código na Figura a seguir: Considere a execução estrita desse ... -

Analise o seguinte código implementado na linguagem C: -

Analise o seguinte código implementado na linguagem C:
