Ao Analisar Os Dados De Uma Epidemia

O que acontece quando você realmente senta para analisar
Na maior parte das vezes, a primeira coisa que você percebe não é sobre os números em si, mas sobre a qualidade dos arquivos que chegam das secretarias de saúde. Dados chegam desatualizados, com campos vazios, datas inconsistentes e códigos de residência que foram alterados sem aviso. Quando você está ao analisar os dados de uma epidemia, esses problemas aparecem antes de qualquer modelo ou visualização fazer sentido. O passo mais importante nunca é construir a curva epidemiológica. É limpar a base. Sem isso, tudo que vem depois é ruído com aparência de resposta. Um problema concreto que eu enfrentei recentemente envolveu uma notificação de surto de sarampo em um município do interior. Os casos confirmados tinham datas de início dos sintomas distribuídas de forma absurda — várias delas posteriores à data de notificação. O padrão era claro: os profissionais estavam preenchendo o campo de data de notificação como se fosse a data de início, o que inviabilizava qualquer cálculo de período de incubação ou datalimite de expurgo. A solução foi simples, mas exigiu trabalho. Eu cruzei a base com os prontuários eletrônicos municipais disponíveis no portal de transparência. Nos casos em que a data de notificação era posterior ao óbito, eu substituí pela data de início dos sintomas registrada no histórico hospitalar. Para os registros sem informação clínica, apliquei uma imputação por data mediana do município nas semanas anteriores, com ressalva clara na documentação. O resultado foi um dataset onde a linha do tempo passou a fazer sentido epidemiológico.
Estrutura básica do processo
Antes de qualquer cosa, defina o que é um caso. A definição padrão usa três critérios: clínico, epidemiológico e laboratorial. Na prática, você raramente terá os três simultaneamente para todos os registros. O mais comum é trabalhar com definição suspeita para a curva inicial e confirmar depois. Isso faz diferença real no desenho da linha do tempo. Depois da definição, normalize as datas. Use sempre o formato ISO 8601 (AAAA-MM-DD) internamente. Converta campos de texto que estejam como DD/MM/AAAA. Trate datas nulas separadamente — não as substitua por zero ou por data mínima. Datas faltantes informam algo sobre a qualidade do sistema, não sobre a ausência do evento. O terceiro passo é geocodificar os endereços quando possível. Muitas bases trazem apenas o código do município. Se você tiver endereço completo, a precisão espacial permite identificar aglomerados que ficam escondidos quando se trabalha só no nível municipal. Ferramentas como o IBGE Cidades Temáticas ou o QGIS com os shapefiles atualizados do ano vigente resolvem isso em cerca de 20 minutos para municípios até 50 mil habitantes.
Medidas que realmente importam
A taxa de ataque merece atenção especial. Ela responde quantos indivíduos desenvolveram a doença dentro de uma população em risco durante um período determinado. O denominador precisa ser a população exposta, não a população total do município. Em surtos fechados, como em escolas ou instituições, use o efetivamente exposto. Se usar a população geral, a taxa fica artificialmente baixa e você subestima o risco. O número básico de reprodução, o R zero, é frequentemente mal interpretado. Ele representa o número médio de secondary cases gerados por um indivíduo infectado em uma população totalmente suscetível. Não confunda com a taxa de crescimento diária. Quando você vê um gráfico exponencial, isso indica crescimento, mas o R zero precisa de estimativas de distribuição de gerações e períodos de incubação para ser calculado corretamente. Métodos como o de Cori ou as implementações da package EpiNo no R produzem intervalos de credibilidade que mostram a incerteza envolvida. Valores pontuais sem intervalo são mais enganadores do que úteis. A letalidade também pede cuidado. A letalidade observada (casos fatais divididos por casos confirmados) sofre de viés de censura. Casos recentes ainda não evoluíram para cura ou óbito. O cálculo precisa considerar apenas casos com desfecho conhecido, preferencialmente usando métodos de sobrevivência como Kaplan-Meier quando a base permitir.
Ferramentas que eu recomendo
Para análise exploratória e limpeza, o R com tidyverse e a package phis (do Departamento de Análise em Saúde e Vigilância de Doenças não Transmissíveis da Fiocruz) economiza horas de trabalho. O script de padronização de variáveis típicas de notificação — como campo "agente", "uf_resid", "data_inicio_sintomas" — já vem configurado para os padrões do DATASUS. Para vigilância em tempo real, a package Surveillance oferece funções de detecção de aglomerados espaciotemporais, incluindo o scan estatístico de Kulldorff. A implementação exige especificar a distribuição escolhida (Poisson para contagem de casos, multinomial para variantes) e definir janelas com tamanho máximo de 50% da população em risco. Janelas muito grandes suavizam os aglomerados; janelas muito pequenas geram falsos positivos. Para visualização, Evowatch (plataforma do IMS-USP) permite criar linhas do tempo interativas com camadas de dados demográficos e temporais sobrepostos. O tempo de montagem de um painel completo varia entre 45 minutos e duas horas, dependendo dadade com a ferramenta.
Pitfalls que eu vi dar errado repetidamente
O viés de notificação é o problema mais frequente. Sistemas de notificação são sensíveis a mudanças de protocolo, a campanhas de busca ativa e a pressões políticas locais. Uma queda brusca nos registros pode indicar controle real do surto ou simplesmente uma quebra na capacidade de notificação. Sempre verifique a linha de base dos 12 meses anteriores antes de declarar qualquer tendência. O segundo erro clássico é a confusão entre incidência e prevalência em curvas epidêmicas. Curvas epidêmicas mostram incidentes novos por período. Se você incluir casos preexistentes na contagem, a linha do tempo fica inflada e a estima de pico epidemiológico fica distorcida. Cases already resolved devem ser removidos da janela de observação. Um terceiro problema diz respeito à divisão territorial. Mudanças de perímetro municipal, criação de novos municípios e alteração de distritos sanitários acontecem regularmente. Um surto que começou antes de 2020 pode ter seus casos atribuídos a municípios que não existem mais. Verifique o histórico de divisões territoriais do IBGE para o período em estudo.
Quando a análise não funciona
Há cenários onde o método padrão entra em colapso. Surto com fonte pontual indeterminada, como água contaminada distribuída em múltiplos municípios sem rastreio adequado, torna impossível calcular taxas de ataque confiáveis porque o denominador de exposição é desconhecido. Nessas situações, o melhor é apresentar limites superiores e inferiores para o risco, indicando a incerteza estrutural. Doença com subnotificação massiva, como dengue em regiões com baixa cobertura de saúde, produz curvas que refletem mais o sistema de vigilância do que a dinâmica real de transmissão. Nestes casos, modelos de captura e marcação ou estimativas baseadas em sindromes podem complementar os dados oficiais, mas introduzem suposições adicionais que precisam ser explicitadas. Obrigação legal de notificação é diferente de capacidade operacional. Muitos municípios têm serviço de vigilância reduzido a um profissional. A notificação formal existe, mas o preenchimento dos formulários é irregular. Dados agregados do SINAN podem ser a melhor fonte disponível, mas é necessário documentar a limitação de forma explícita em qualquer relatório publicado.
Um exemplo prático de fluxo de trabalho
Recebi uma solicitação para mapear um surto de leptospirose após enchente. O fluxo completo levou aproximadamente oito horas distribuídas em dois dias, considerando a espera por dados atualizados do município. O primeiro dia foi inteiramente dedicado à limpeza: 347 notificações foram revisadas manualmente, 89 registros tiveram datas corrigidas, 12 casos foram movidos para a categoria "descartado" após cruzamento com laudos laboratoriais, e 47 registros perderam dados de endereço e foram analisados apenas no nível do bairro pelo código de setor censitário. No segundo dia, construí a curva epidêmica usando datas de início dos sintomas agrupadas por semana, calculei taxas de ataque por faixa etária e gênero, e identifiquei aglomerados espaciais com o teste de Kulldorff. O resultado mostrou dois clusters significativos em áreas de baixa altitude próximas ao rio, com razão de probabilidade positiva acima de 50. A análise foi entregue em formato de nota técnica com annexos de metodologia para transparência. A parte mais demorada nunca foi a análise em si. Foi a comunicação com a secretaria para obter os prontuários completos e a verificação campo a campo dos dados de localização. Sem isso, o cluster identificado poderia estar errado por simplesmente estar em uma área com maior densidade de unidades de saúde que notificação, não necessariamente com maior incidence real.
Galeria
-

-Dimensões de análise e respectivos dados utilizados no monitoramento ... -

Conheça 5 medidas que podem controlar a epidemia de ebola -
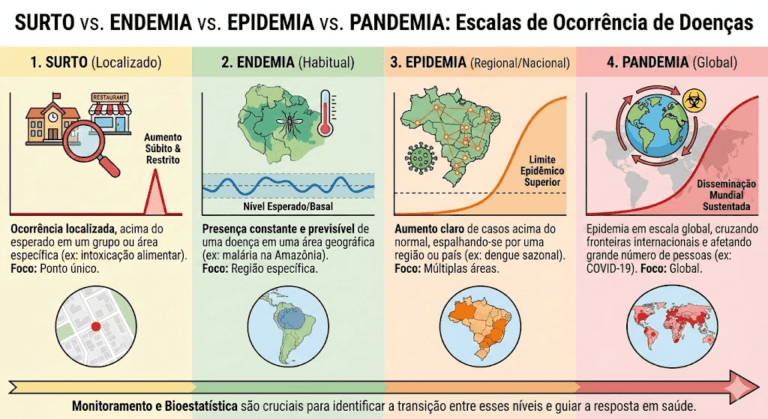
Epidemia e Pandemia: Entenda de Vez as Diferenças e Conceitos Chave
