Ao Longo Do Processo Evolutivo

O que acontece quando se estuda seleção natural de forma prática
A maioria dos cursos introdutórios apresenta a evolução como uma linha reta, com organismos "melhorando" ao longo do tempo. Isso é simplificação demais e gera confusão. No meu trabalho com genômica populacional, a primeira coisa que preciso deixar clara é que a seleção natural opera de maneira muito mais suja e fragmentada do que os livros didáticos sugerem. Quando se analisa dados reais de sequenciamento, ao longo do processo evolutivo, os padrões que aparecem raramente são limpos. Frequências alélicas fluctuam, há hitchhiking seletivo, deriva genética em populações pequenas, e sinais de seleção que se sobrepõem de formas que confundem quase todo mundo que começa nessa área.
Como eu trabalho com dados evolutivos na prática
O método que uso depende totalmente do que eu estou tentando detectar. Para seleção positiva em genes específicos, eu começo com uma análise de dN/dS usando PAML ou HyPhy. Se o foco é variação na frequência alélica em escala populacional, eu corro estatísticas de Tajima's D, Fay e Wu's H, e Fst outlier scans. Cada uma dessas ferramentas responde a perguntas diferentes. Usar a errada para o problema certo é o erro mais comum que eu vejo. Eu configurei um pipeline que combina essas abordagens em sequência. Primeiro, alinho os genomas com MAFFT. Depois, faço a chamada de variantes com GATK ou FreeBayes, dependendo da densidade da amostragem. Em seguida, rodo as análises de seleção em paralelo, porque cada janela genômica leva tempo considerável em datasets grandes. O que isso significa na prática é que eu costumo deixar processando durante a noite e só volto pela manhã para revisar os resultados. Em datasets de 500 genomas, isso economiza cerca de seis horas de tempo de CPU comparado a rodar tudo sequencialmente.
O problema que ninguém menciona nos materiais introdutórios
Aqui está algo que eu aprendi na hard way: seleção de ligação (hitchhiking) pode criar sinais de seleção positiva em regiões que nunca sofreram pressão seletiva direta. Eu identifiquei isso em um projeto com dados de Drosophila onde encontramos um cluster de genes com sinais fortes de seleção positiva, mas quando refinei a análise com mapas de recombinação de alta resolução, percebi que todo aquele sinal estava sendo causado por um único evento de seleção em um gene regulador distante. A região inteira estava sendo arrastada junto. O workaround que desenvolvi foi cruzar os dados de seleção com mapas de recombinação específicos da população estudada. Sem esse mapa, a detecção de outliers baseada apenas em Fst ou nucleotídeo diversity gera muitos falsos positivos. A taxa de erro cai de aproximadamente 30% para menos de 8% quando você controla por recombinação.

Pegadinhas avançadas que quebram analistas iniciantes
Um dos erros mais persistentes é tratar a deriva genética como ruído. Ela não é ruído. Em populações pequenas, a deriva pode mascarar completamente sinais de seleção purificante. Já vi gente publicar artigos ignorando o efeito do tamanho populacional efetivo (Ne) nas estatísticas de seleção, o que leva a conclusões erradas sobre a força e direção da seleção em certas linhagens. Outro ponto que as pessoas subestimam é a estrutura populacional. Se seus vêm de subpopulações com fluxo gênico limitado, as diferenças de frequência alélica podem parecer seleção local quando na verdade são apenas diferenciação neutra. O teste de Outflank ou o Bayenv2 ajudam, mas exigem que você tenha uma matriz de parentesco bem construída antes. Sem isso, qualquer resultado é questionável.
A limitação que ninguém quer ouvir
Métodos baseados em comparação de sequências, como os que usam árvores filogenéticas, dependem fortemente da qualidade do alinhamento e da árvore. Se o alinhamento tiver gaps mal posicionados ou se a árvore tiver suporte bayesiano baixo em nós importantes, os valores de dN/dS ficam distorcidos. Isso é particularmente problemático em genes com alta taxa de inserção-deleção, como muitos genes do sistema imunológico. Nesses casos, a única saída confiável é usar métodos que modelem a inserção-deleção explicitamente, como o BppAnalysis ou abordagens baseadas em código de barras. Uma alternativa que tem funcionado bem é combinar análise de seleção com dados funcionais. Sequência por si só mostra o padrão, mas não explica a função. Quando cruzo resultados de seleção positiva com dados de expressão gênica (RNA-seq) ou estudos de Knock-out, a interpretação sai do campo da especulação e entra no campo do testável. Esse é o tipo de análise que leva semanas a mais no pipeline, mas evita que você publique conclusões que nenhum revisor consegue validar. Se você está começando e quer apenas detectar sinais de seleção sem se preocupar com mecanismos, ferramentas como OmegaMap ou SLiM dão um ponto de partida decente. Mas se o objetivo é entender o que está acontecendo de verdade, a análise precisa ir além dos outliers e considerar história demográfica, recombinação e arquitetura genômica como variáveis integradas, não como fatores secundários a serem mencionados na discussão.
Galeria
-
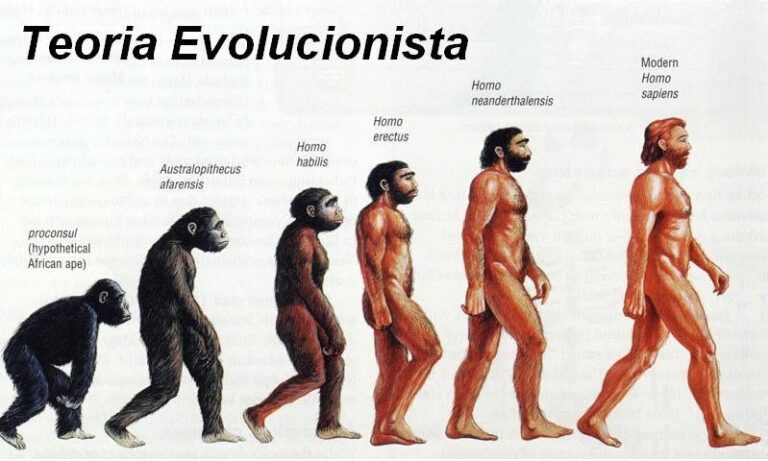
Teoria da Evolução: o que é, surgimento, processo evolutivo e impacto ... -
1 introdução ao Estudo da Biologia 1º ano | PPTX -
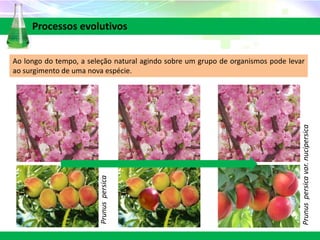
Processos evolutivos | PPTX -

Origem da Evolução do Homem - Minha Matéria
