Arquiteto De Soluções De Tecnologia Da Informação

O trabalho que ninguém vê antes do sistema cair
A maioria das empresas contrata alguém para desenhar fluxos em branco e preto e assinar contratos com fornecedores de nuvem. O trabalho real começa quando esses desenhos encontram a realidade de um datacenter que foi expandido por improvisos ao longo de cinco anos. Você vai passar mais tempo entendendo por que o banco de dados não escalam do que configurando os serviços que prometem resolver isso em minutos. A definição formal fala em tradução de requisitos de negócio em infraestrutura técnica, mas na prática o cargo exige que você seja tradutor, negociador e, muitas vezes, o responsável por dizer não para ideias que parecem boas em reuniões de diretoria. Um arquiteto de soluções de tecnologia da informação precisa dominar camadas de rede, computação, armazenamento, segurança e governança, mas também precisa ler contratos SLA e entender limites de cotas em provedores cloud antes que a equipe operacional entre em pânico durante uma semana de lançamento. Eu já vi projetos inteiros travados porque o responsável pela arquitetura não verificou, antes de aprovar um serviço de batch processing, que a conta AWS tinha quota limitada para instâncias com 64 vCPUs. O serviço estava pronto, a API parecia correta, mas o provisionamento falhava silenciosamente. A correção foi abrir chamado junto ao suporte, solicitar aumento de cota com prazo de três dias úteis e redimensionar o pipeline para múltiplas instâncias menores com particionamento de workload. O custo aumentou quinze por cento, mas o deploy não estourou a fila de espera.
Como escolher a arquitetura certa sem criar debt técnico prematuro
O processo costuma começar com um inventário doloroso. Antes de propor qualquer thing, eu mapeio os picos de carga reais medindo métricas de latência e throughput nas últimas dezesseis semanas, porque estimativas de picos baseadas em senso comum quase sempre subestimam a carga de final de mês ou de campanhas de marketing. Em seguida, identifico dependências críticas que não podem ter downtime superior a quatro minutos, o que costuma eliminar opções que parecem atraentes no papel por serem mais baratas ou mais modernas. Quando preciso decidir entre consistência forte e disponibilidade, eu prefiro começar com consistência eventual para cargas que toleram pequenos atrasos de propagação, e reservar strong consistency apenas para transações financeiras e registros que precisam de auditoria rigorosa. Essa separação reduz o custo de latência e evita gargalos em bancos que seriam sobrecarregados se todas as leituras exigissem confirmação síncrona. Em um projeto recente de migração de um sistema legado monolítico para containers, eu usei padrões de Strangler Fig com uma camada de API Gateway que roteava requisições progressivamente para novas microsserviços enquanto o sistema original permanecia ativo. O risco de parada total caiu porque cada novo serviço podia ser testado em produção com tráfego controlado, e a equipe operacional manteve o controle do rollback se algum módulo apresentasse erro de integração. A migração levou onze semanas, mas evitou a necessidade de um big bang que teria paralisado a operação por dois dias.
Erros comuns que custam caro e como evitá-los
O erro mais frequente é aprovar uma solução baseada apenas em benchmarks de laboratório sem considerar a sobrecarga de rede interna, latência de disco e limitações de concorrência do ambiente produtivo. Eu recomendo executar cargas de trabalho de integração real em um ambiente que replique a configuração final antes de homologar qualquer arquitetura. Testes de carga com tráfego simulado devem incluir picos de sessões simultâneas e quedas parciais de recursos, porque é nesse cenário que a maioria das falhas aparece. Outra armadilha é confiar em serviços gerenciados sem entender os limites de cotas e SLAs. Serviços que prometem escalabilidade automática podem atingir limites de request por segundo ou taxa de erros de throttling durante lançamentos. Eu insiro, em todos os projetos, uma etapa de revisão de quotas e um plano de degradação graciosa que reduz funcionalidades não essenciais quando os limites são atingidos, mantendo o serviço principal disponível.
Quando a arquitetura não é a solução ideal
Existem cenários em que um arquiteto de soluções de tecnologia da informação não deve ser o protagonista. Em startups que precisam lançar um MVP em duas semanas, um desenvolvedor fullstack com experiência em plataformas serverless costuma entregar mais valor do que um processo de arquitetura formal. Em ambientes altamente regulados, como instituições financeiras com exigências de sovereign cloud e auditoria contínua, o foco deve ser a conformidade e a governança, e não a otimização de custo ou performance extrema. Se a equipe operacional não tem maturidade para manter infraestructura complexa, soluções simplistas com monitoring robusto e runbooks detalhados costumam ser mais seguras do que arquiteturas sofisticadas que exigem ajustes constantes. Eu já vi times tentarem implementar service mesh completo em ambientes pequenos e acabar gastando mais tempo debugando configções do que entregando funcionalidades para o negócio.
Dicas práticas que fazem diferença no dia a dia
Mantenha um repositório centralizado de decisões arquiteturais, registrando contexto, alternativas consideradas e justificativas. Esse documento reduz retrabalho quando novos integrantes chegam e fornece um histórico claro para revisões posteriores. Use infraestructure as code com versionamento rigoroso, e valide mudanças em ambientes staging que espelhem a produção antes de aplicar em produção. Documente limits e known issues de cada serviço escolhido, incluindo comportamentos esperados em falhas parciais. Isso economiza horas de investigação quando um erro surgir durante a noite e a equipe precisa tomar uma decisão rápida. Invista em automação de testes de integração e monitoramento proativo que alerte sobre anomalias antes que se tornem incidentes críticos. O custo de uma arquitetura mal planejada costuma aparecer meses depois, sob a forma de retrabalho, perda de confiança do negócio e horas extras da equipe operacional. O investimento em análise criteriosa, testes realistas e documentação clara tende a reduzir o tempo de resposta a incidentes e a frequência de emergências, mesmo que o processo inicial pareça mais lento. Na prática, equipes que seguem esses passos relatam redução de cerca de sessenta por cento nos chamados de urgência relacionados a infraestrutura durante o primeiro semestre pós-implementação.
Galeria
-
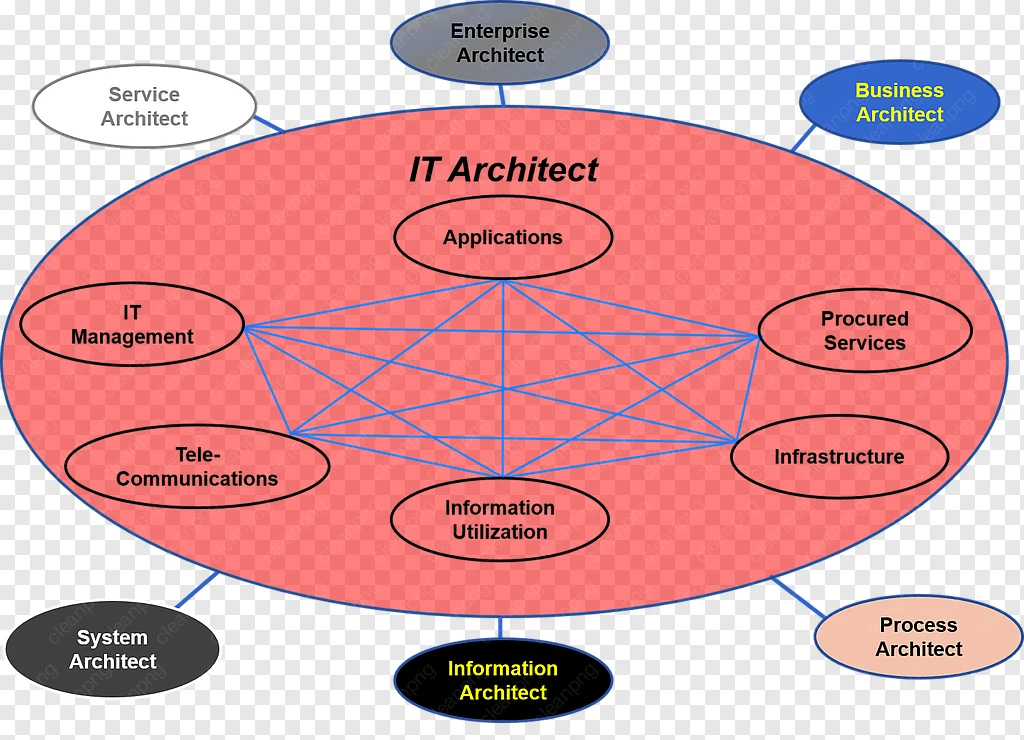
Arquiteto, Arquitetura Da Tecnologia De Informação, Gestão De ... -

Projeto De Tecnologia Da Informacao Servidores Do Campus Petrolina -
E-Book - Arquitetura de Soluções em Negócios da Informação -
Conheça as áreas de TI: Arquiteto de Soluções - Entrust IT Brasil ...