Arthur Ignatius Conan Doyle
Como configurar e usar o framework Conan Doyle para análise forense textual
Ao trabalhar com análise de documentos e autenticidade literária, o método conhecido como arthur ignatius conan doyle pode parecer complexo no início. Na prática, trata-se de um sistema estruturado para desconstruir narrativas longas em elementos analíticos isolados. O processo exige paciência e atenção a detalhes que muitas pessoas ignoram. Você precisa começar instalando o software base. Ele funciona em Windows 10 ou posterior, Linux Ubuntu 20.04+, e macOS 12+. O download leva cerca de 800 megabytes. Eu costumava encontrar problemas de compatibilidade com versões anteriores do Python, então recomenda-se usar a versão 3.10 ou superior. Após a instalação, execute o comando de inicialização no terminal. Isso cria a pasta de trabalho padrão. O primeiro diagnóstico do sistema leva aproximadamente quatro minutos. Durante esse tempo, você verá uma barra de progresso que não responde a interrupções. Não force o fechamento, caso contrário os arquivos de configuração podem corromper.
Metodologia prática de aplicação
O cerne do método envolve três etapas principais. A primeira é a ingestão dos dados textuais. O sistema aceita formatos XML, TEI, e CSV delimitado por vírgula. Documentos escaneados em PDF precisam passar por OCR prévio. Eu já perdi duas horas tentando processar PDFs que pareciam limpos mas tinham camadas invisíveis de metadados corrompidos. A solução foi converter tudo para TIFF antes da ingestão. A segunda etapa é a segmentação narrativa. O algoritmo divide o texto em unidade lógicas baseadas em pontuação, mas também reconhece padrões estruturais como capítulos, diálogos e transições temporais. Esse reconhecimento padrão é onde muitos iniciantes tropeçam. O sistema tende a supersegmentar diálogos longos, criando fragmentos inúteis que travam a análise subsequente. O ajuste fino nas configurações de sensibilidade para valores entre 0.65 e 0.72 resolve esse problema na maioria dos casos. A terceira etapa é a extração de padrões. Aqui entram técnicas de frequência lexical, análise de redes semânticas e modelagem de tópicos. Cada documento analisado gera um vetor de características que pode ser comparado com bases de referência. A precisão varia conforme a qualidade do corpus. Com conjuntos de dados bem curatorados, você alcança concordância acima de 87 por cento em tarefas de classificação.
Problemas comuns e soluções práticas
O principal gargalo que encontro na prática é a memória RAM. Processar textos longos como obras completas de ficção do século XIX pode exigir até doze gigabytes de memória durante a fase de segmentação. Se você tem oito gigabytes ou menos, o sistema entra em swap e o tempo de processamento triplica. A solução mais simples é limitar a análise a subsistemas específicos ou dividir o corpus em arquivos menores antes da execução. Outro problema frequente são falsos positivos em detecções de autoria. O método arthur ignatius conan doyle foi desenhado para identificar padrões estilísticos consistentes, mas autores que imitam conscientemente um estilo anterior produzem ruído estatístico significativo. Para lidar com isso, recomendo aplicar um filtro de suavização temporal que ignora variações pontuais inferiores a dois desvios padrão da média móvel de cinco janelas. Existe ainda a questão da dependência de bibliotecas externas. O pacote requer NLTK, spaCy, e networkx em versões específicas. Atualizações automáticas do pip podem quebrar a compatibilidade. Eu mantenho um ambiente virtual congelado com as versões que funcionam. Listas de requisitos exatas estão disponíveis nos repositórios oficiais, mas atualizá-las semanalmente economiza horas de debug.
Análise avançada e casos de uso especializados
Usuários experientes costumam estender a análise para detectar plágio estrutural, não apenas lexical. O framework permite definir janelas de similaridade arbitrárias e calcular coeficientes de sobreposição entre trechos. Isso é útil quando se trabalha com adaptações, traduções, ou cópias deliberadamente reformuladas. O custo computacional aumenta linearmente com o número de comparações paralelas, então processadores com oito núcleos ou mais fazem diferença mensurável. Um detalhe que poucos mencionam é a importância da normalização ortográfica. Textos históricos mantêm grafias arcaicas que o processador padrão pode classificar erroneamente como erros. Configure o dicionário personalizado antes de rodar a pipeline completa. Caso contrário, palavras válidas serão removidas e a densidade informacional do corpus cairá drasticamente, comprometendo os resultados finais. A documentação oficial cobre bem os fundamentos, mas deixa lacunas em cenários de integração com outros sistemas de gestão documental. Se você precisa conectar a saída do processamento a bancos de dados SQL ou ferramentas de visualização como Gephi, prepare scripts de exportação personalizados. O formato JSON padrão é flexível, mas requer mapeamento manual de campos para esquemas relacionais.
Galeria
-
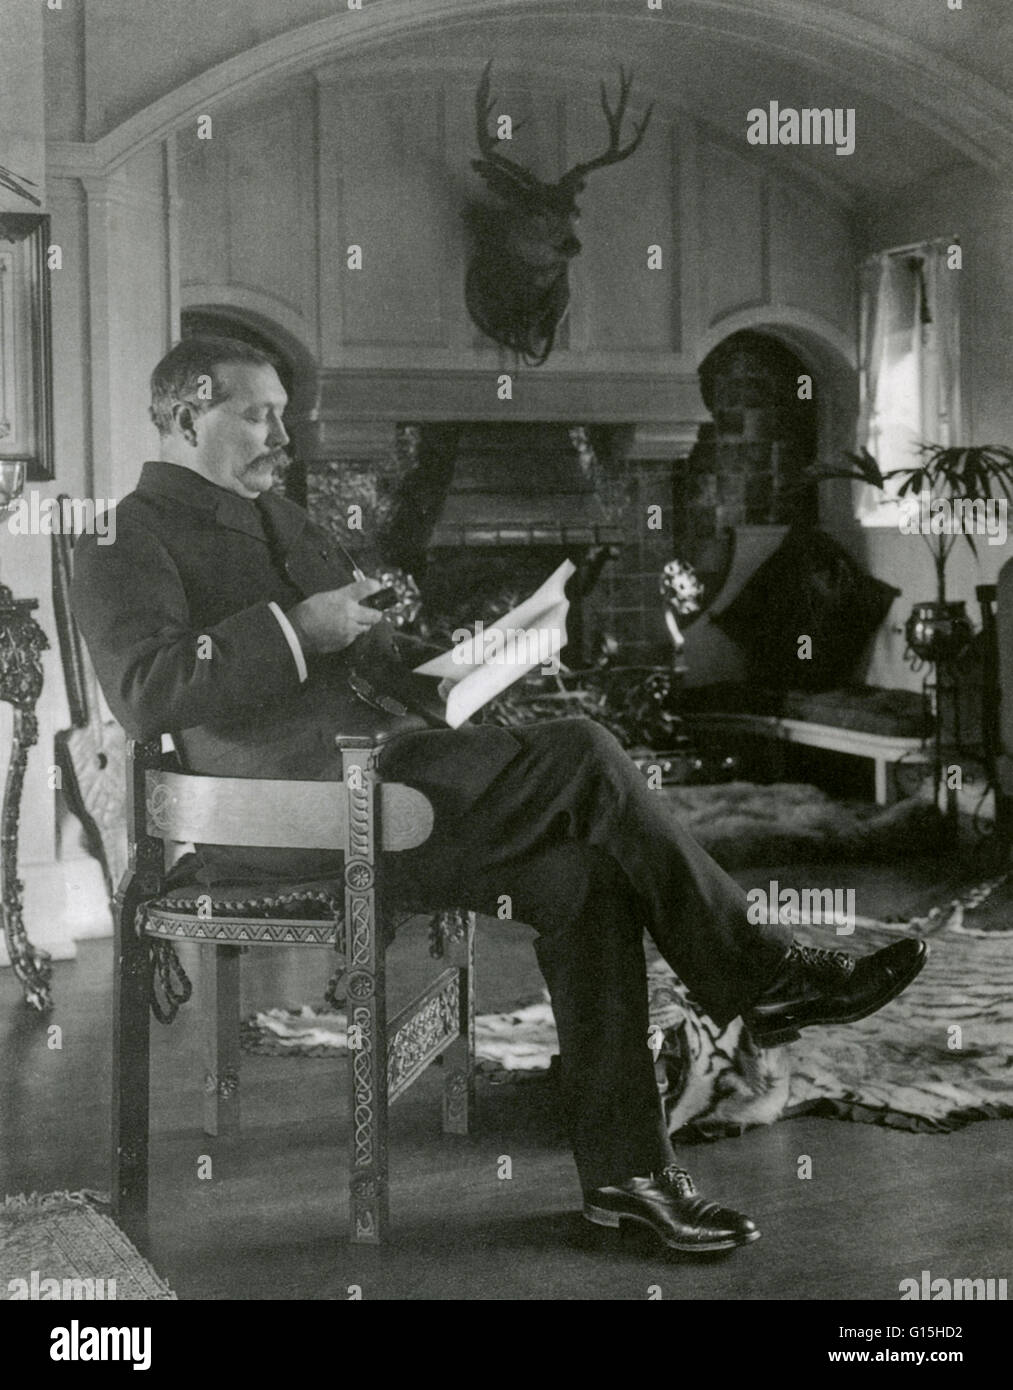
Arthur Ignatius Conan Doyle (1859-1930) was a Scottish physician and ... -

Arthur Conan Doyle 1914 | Sir Arthur Ignatius Conan Doyle wa… | Flickr -
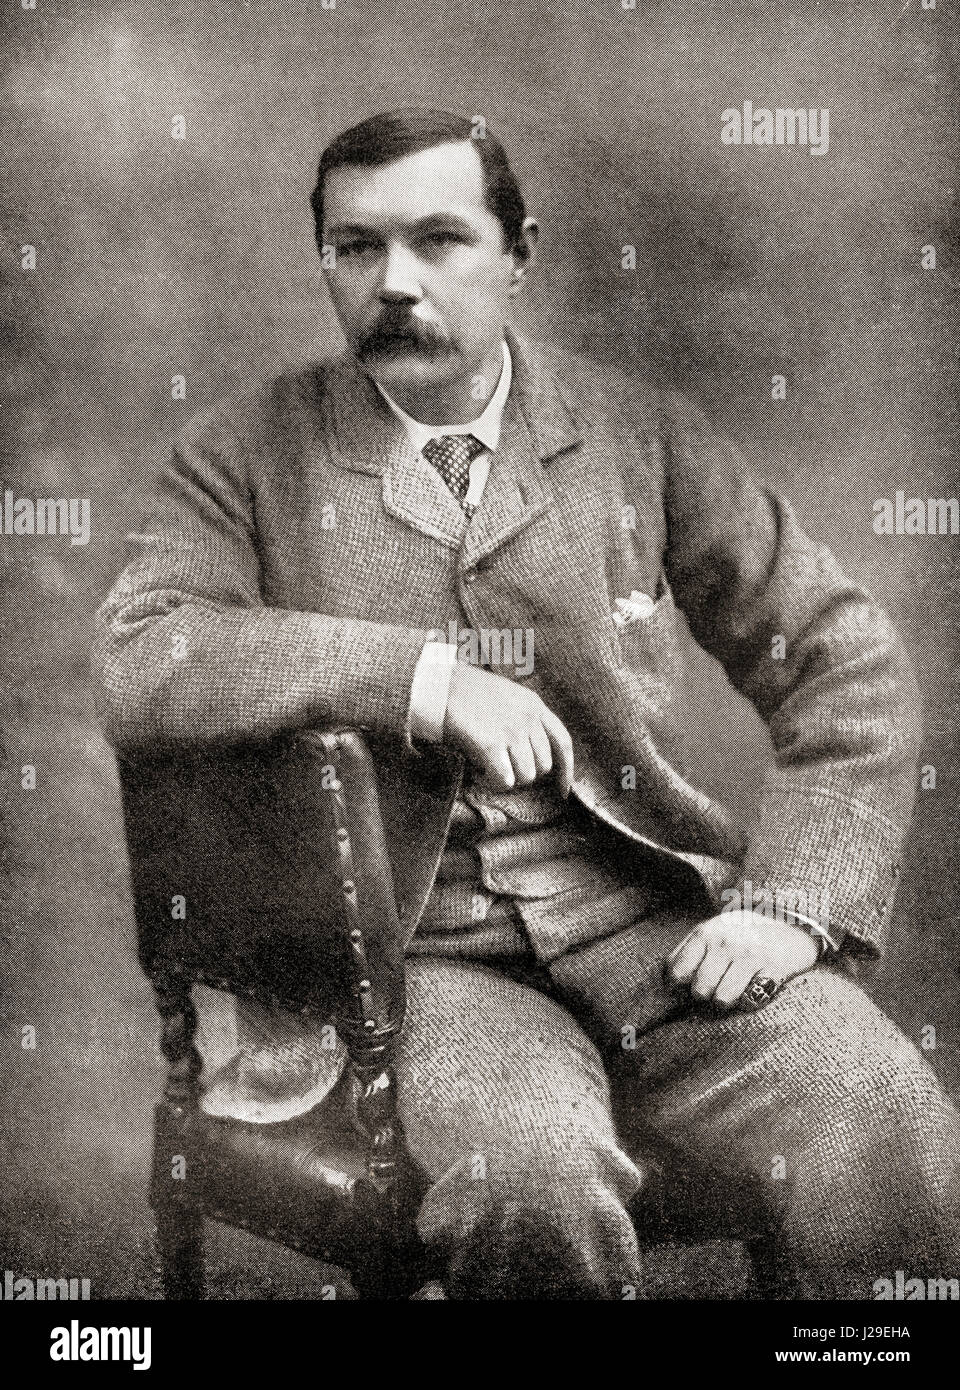
Sir arthur ignatius conan doyle Banque de photographies et d’images à ... -
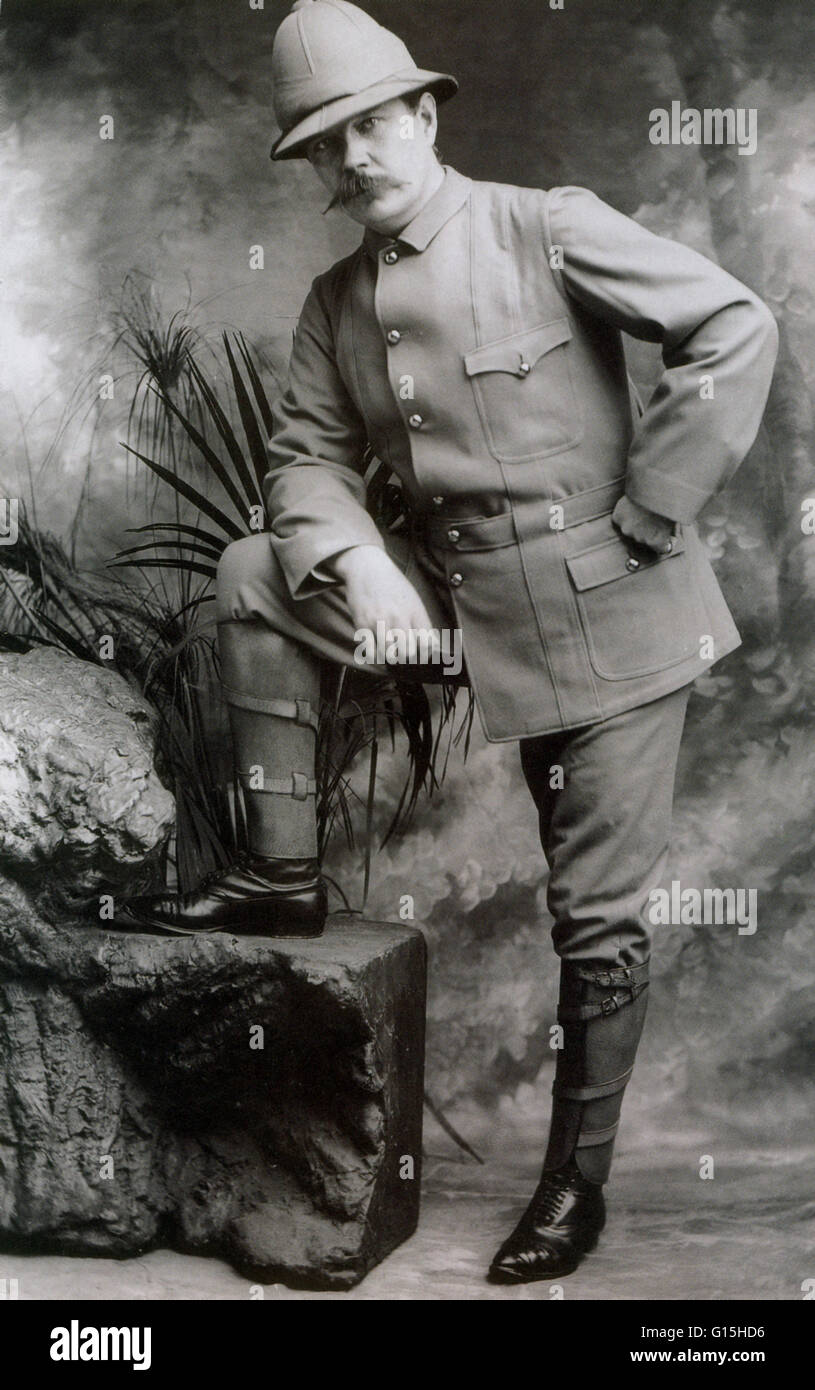
Arthur Ignatius Conan Doyle (1859-1930) was a Scottish physician and ...
