As Operações De Subconsultas São Uma Ferramenta Poderosa

Subqueries na prática
Eu comecei a usar subconsultas quando ainda escrevia queries monolíticas com dez joins e me perdia no meio delas. O banco nunca conseguia otimizar direito e o plano de execução virava um caos. Foi aí que percebi que separar lógica em subconsultas não era apenas uma questão de organização — mudava como o otimizador lia tudo. Se você trabalha com SQL no dia a dia, já deve ter ouvido que as operações de subconsultas são uma ferramenta poderosa, mas a maioria das pessoas para na definição básica. O problema é que a parte interessante — e a que realmente causa dor de cabeça — fica nos detalhes de desempenho e nos casos limítrofes.
Como as operações de subconsultas são uma ferramenta poderosa
Uma subconsulta é basicamente uma consulta aninhada dentro de outra. Pode aparecer no SELECT, no FROM, no WHERE, no HAVING. Cada posição tem regras próprias de correlação e otimização. Quando você usa uma subconsulta correlacionada no WHERE, por exemplo, o banco executa ela uma vez para cada linha da consulta externa. Isso pode ser uma vantagem quando os dados são pequenos. Pode ser um desastre quando não são. Eu aprendi isso na marra. Tinha uma query que buscava funcionários com salário acima da média do departamento deles. A abordagem ingênua foi uma subconsulta correlacionada no WHERE. Funcionou bem com mil linhas. Quando o cenário real cresceu para duzentas mil, a coisa travou. O otimizador não conseguia reutilizar o resultado da média por departamento e recalculava tudo a cada linha. Passei trinta minutos esperando um SELECT simples. A solução foi transformar a subconsulta correlacionada em uma CTE com GROUP BY, depois fazer o JOIN. O tempo caiu de mais de vinte segundos para cerca de duzentos milissegundos. O plano de execução ficou muito mais previsível. Eu simplesmente não tinha percebido que o otimizador da versão que eu usava não fazia materialização automática de subconsultas correlacionadas com agregações tão benévolamente quanto versões mais recentes.
Isso me leva a um ponto que poucos mencionam: subconsultas não são automaticamente lentas. O que determina o custo é como o otimizador decide processá-las. Em bancos modernos, subconsultas escalares no SELECT muitas vezes são materializadas de forma eficiente. Em outros, o comportamento é imprevisível e depende da configuração do plano. Outra armadilha comum é confiar cegamente em EXISTS versus IN. A regra simples que ensinam é que EXISTS é melhor quando a subconsulta retorna muitas colunas, enquanto IN é melhor com listas pequenas. Na prática, isso varia muito entre motores. No PostgreSQL, por exemplo, a diferença entre EXISTS e IN costuma ser irrelevante porque o otimizador transforma uma na outra. No SQL Server, já vi casos em que IN com lista de constantes gerava um plano completamente diferente do EXISTS equivalente, e o EXISTS vencia por largo margem. Se você quer evitar surpresas, o caminho mais seguro é sempre olhar o plano de execução. Não adianta escrever uma subconsulta bonita se o banco vai decidir executar de forma iterativa. Um plano com nested loops repetindo uma subconsulta é um sinal claro de que algo precisa mudar. Um scan de clustered index com hash match, mesmo que pareça mais complexo, geralmente indica que o otimizador encontrou uma estratégia mais eficiente.

Outro ponto que merece atenção é o uso de subconsultas no SELECT list. Parece inofensivo, mas pode criar comportamento inesperado de performance. Eu já vi queries onde adicionar uma subconsulta escalar para buscar um valor relacionado fazia toda a consulta cair porque o otimizador escolheu um plano com mais nested loops do que necessário. Substituir por um LEFT JOIN resolveu o problema, e o custo de leitura caiu pela metade em termos de I/O. Também é importante saber quando não usar subconsultas. Se você está fazendo aggregações complexas com múltiplas camadas de dados, uma CTE ou uma tabela temporária costuma ser mais legível e mais fácil de otimizar. O custo de escrita na temp table é compensado pela capacidade de inspecionar o dado intermediário e ajustar índices se necessário. Subconsultas aninhadas demais viram um pesadelo de manutenção e depuração. Quando trabalho com dados massivos e preciso de flexibilidade, minhas consultas tendem a ficar mais verbosas porque divido o problema em etapas. Cada etapa é uma CTE nomeada. É mais texto, mas o plano de execução fica transparente e eu consigo explicar cada decisão para quem for dar manutenção depois. E sim, isso inclui eu mesmo daqui a seis meses.
O que eu quero dizer é que a eficiência das subconsultas depende do contexto, do banco, do tamanho dos dados e da configuração do otimizador. Não existe receita única. O que funciona num cenário pode falhar grotescamente noutro. A melhor coisa que você pode fazer é testar, comparar planos, e não ter medo de refatorar quando o comportamento não estiver alinhado com a expectativa. Se você está começando agora, recomendo que domine primeiro a diferença entre subconsultas correlacionadas e não correlacionadas, entenda como o EXISTS se comporta no seu banco específico, e pratique a leitura de planos de execução antes de depender de subconsultas para lógica complexa. Essa base evita muitos problemas comuns e economiza horas de debugging.
Galeria
-
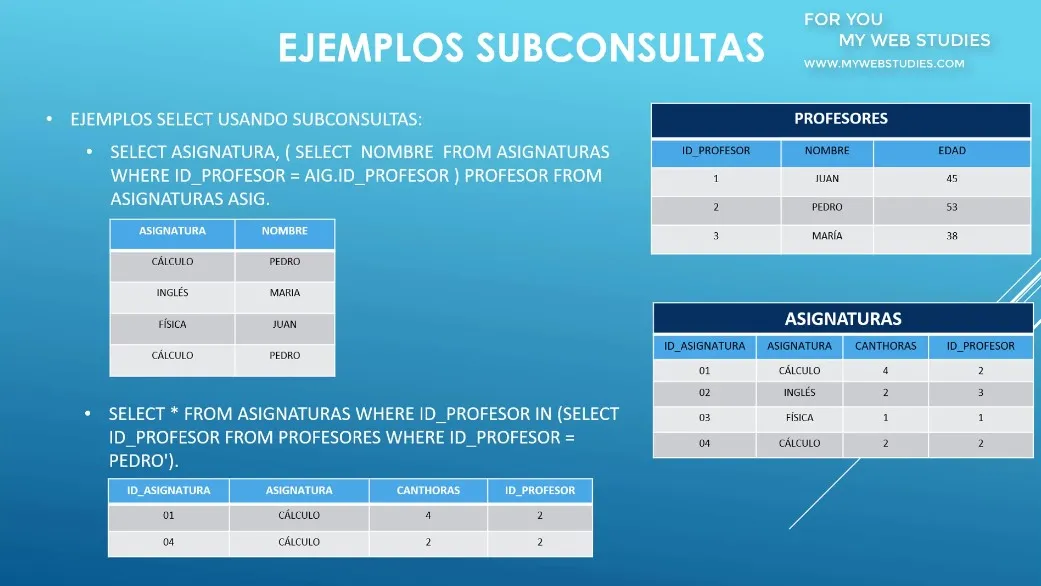
Concepto de subconsultas en sql -
Tipos de Subconsultas SQL: Guía Completa | PDF | Informática -
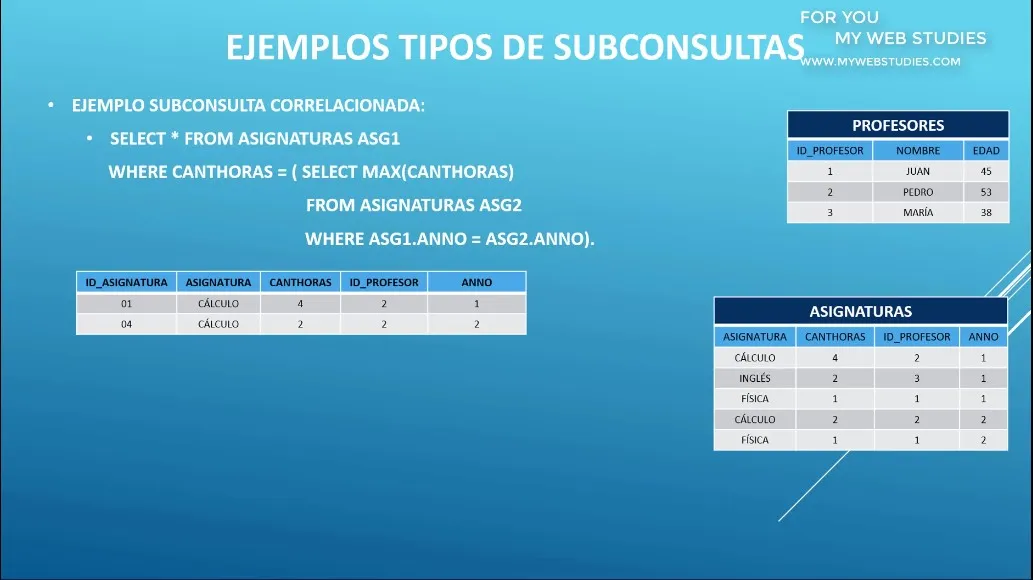
Categorías de subconsultas en sql -
Subconsultas | PDF | SQL | Gestión de datos


