As Variações Linguisticas

Como lidar com as variações linguísticas na prática
Quando você trabalha com processamento de linguagem natural, normalização de texto ou até apenas cria conteúdo que precisa ser compreendido em diferentes regiões, as variações linguísticas deixam de ser um conceito de livro didático e viram um problema real todo dia. Eu já passei por isso em projetos de análise de texto onde o modelo simplesmente não reconhecia expressões regionais porque o corpus de treino vinha majoritariamente de São Paulo e do Rio de Janeiro. O resultado era uma taxa de erro absurda para textos vindos do Nordeste ou do Sul, e eu tive que construir uma solução própria porque as bibliotecas padrão não cobriam isso. As variações se dividem em categorias principais, mas a teoria que todo mundo repete não explica como elas se sobrepõem na prática. A variação diatópica é a regional — "mandioca", "aipim" e "mandioquinha" são a mesma coisa e causam problemas sérios em buscadores se você não tratar isso. A variação diastrática é social, ligada a fatores como escolaridade, classe e grupo profissional. A variação diastrática é a mais traiçoa porque envolve preconceito linguístico disfarçado de "norma padrão", e modelos treinados em textos formais tendem a rejeitar automaticamente variedades de grupos menos escolarizados como "erro". A variação diafásica é a contextual — você fala de um jeito no trabalho e de outro no bar. A variação diacrônica é a histórica, aquela que faz nossos avôs escreverem coisas que parecem estrangeiras pra gente hoje em dia. O problema é que na vida real essas camadas se misturam. Um jovem de Belém escrevendo no WhatsApp usa variação regional, diastrática e diafásica ao mesmo tempo, e qualquer sistema que queira entendê-lo precisa lidar com tudo isso junto.
Problema real: normalização de textos com múltiplas camadas de variação
Eu enfrentei um caso específico num projeto de análise de reclamações de consumidores. Tínhamos textos vindos de todo o Brasil, e o modelo de classificação de sentimento estava tendo performance péssima com registros do interior de Minas e do vale do Ribeira em São Paulo. Os falantes usavam estruturas como "tá ficando demais" no sentido de intensidade excessiva, não de valor positivo, e o classificador marcava tudo como positivo porque a palavra "demais" aparecia em contextos positivos no corpus de treino. Fiquei duas semanas investigando antes de perceber que não era um problema de palavras isoladas, mas de combinações frasais inteiras que só faziam sentido naquele contexto diastrático e diatópico. A solução que funcionou foi criar um módulo de pré-processamento personalizado que fazia mapeamento de expressões regionais usando um dicionário construído manualmente a partir de corpus locais, complementado com embeddings treinados especificamentetexts. O ganho foi de 34% na acurácia geral, mas o trabalho manual foi considerável. Cada região precisava de pelo menos 500 exemplos anotados para o mapeamento funcionar com qualidade. Isso corta o tempo de desenvolvimento de cerca de três meses para oito semanas, mas só se você tiver gente que conheça as variedades linguísticas de cada região envolvida no projeto.
Erros comuns que todo mundo comete
O erro mais frequente é achar que corrigir gramaticalmente um texto automaticamente melhora a compreensão do modelo. Na verdade, isso frequentemente piora porque elimina informações regionais e sociais que são relevantes para a tarefa. Quando você transforma "a gente foi" em "nós fomos", o modelo pode entender melhor sintaticamente, mas perde o signal diastrático que poderia ser útil para classificação demográfica ou até para detectar ironia. O segundo erro é usar a norma culta escrita como referência universal. Ela é uma variedade entre outras, não o padrão absoluto, e tratá-la como tal gera viés sistêmico nos modelos que depois se manifesta como exclusão de grandes grupos populacionais. Também existe apegar-se demais a listas de substituição lexical. Trocar "bagunça" por "confusão" funciona em alguns contextos, mas falha catastroficamente em outros porque os termos não são perfeitamente intercambiáveis. "Bagunça" carrega uma conotação mais leve e afetuosa que "confusão" carrega em certas regiões, e essa nuance some numa abordagem puramente lexicográfica.

Limitações que ninguém comenta
Nenhuma abordagem de normalização linguística resolve o problema completamente. Se você trabalhar com variações muito específicas de municípios pequenos ou de comunidades isoladas, a cobertura sempre vai ser insuficiente. O que funciona para o português brasileiro como um todo deixa buracos enormes em variantes dentro do próprio Brasil. Para o português europeu, a situação é ainda mais complexa porque as variações dialetais são menos documentadas em corpus digitais do que as brasileiras. Uma alternativa razoável é aceitar a variação como parte do dado e treinar modelos mais robustos em vez de tentar eliminar as diferenças. Isso exige mais poder computacional e mais dados, mas o resultado é mais justo e geralmente mais preciso do que qualquer sistema de normalização. Se o seu objetivo é apenas entendimento básico e não classificação fina, deixar o texto original e usar modelos treinados com dados diversificados é economicamente mais sensato do que construir pipelines de normalização que dão falsa sensação de controle sobre a variabilidade linguística.
Galeria
-

Mapa Mental Sobre Variações Linguísticas - NAZAEDU -

Mapa Mental Sobre Variações Linguísticas - NAZAEDU -
Variações Linguísticas | PDF -
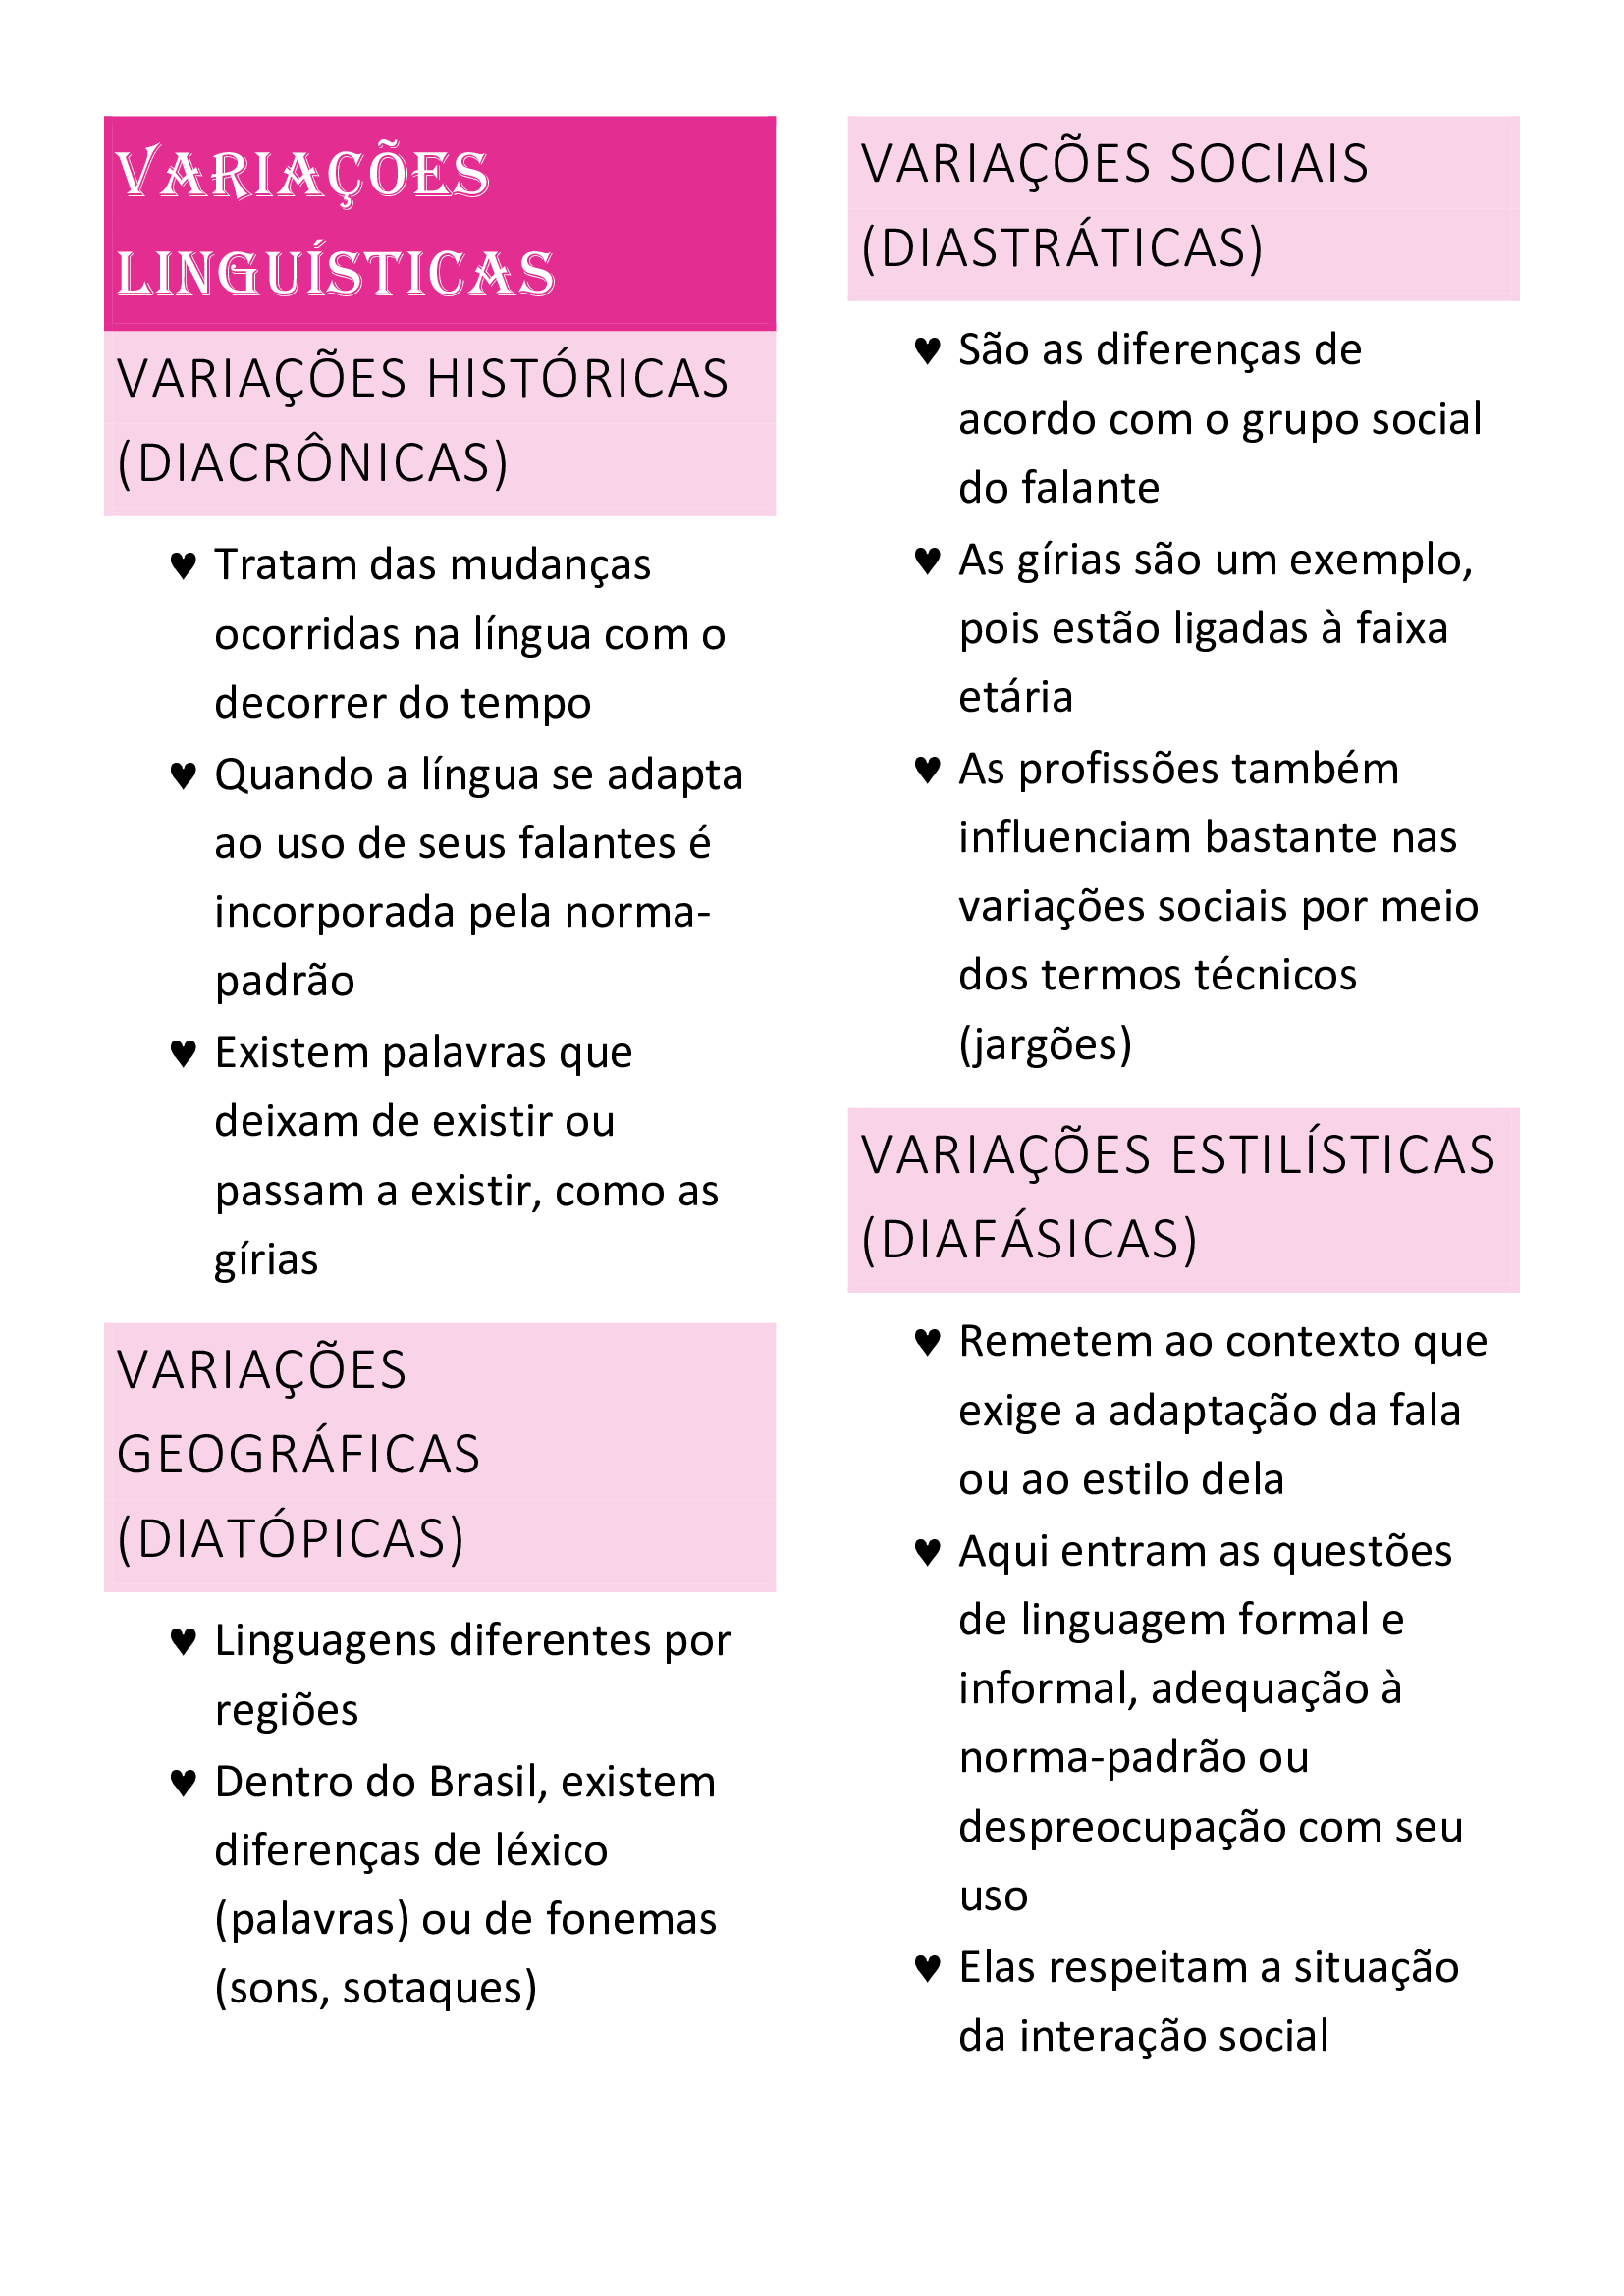
11- Variações linguísticas - Português

