Atividades De Localização
O que acontece quando você vai localizar software pela enésima vez
A maioria dos times começa com o óbvio: traduzir strings, ajustar layouts para alemão que é longo, testar datas. O trabalho é mais chato do que difícil na maior parte do tempo. O problema real aparece quando você leva isso a sério e descobre que a localização não termina quando o texto fica bom em russo ou japonês. Cada atividade de localização envolve decisões que parecem pequenas no início mas custam horas de correção depois. A ordem que você executa essas atividades importa muito mais do que a qualidade individual de cada uma.
Como estruturar atividades de localização na prática
A primeira coisa que eu faço não é abrir um tradutor. Eu examino a estrutura de strings e a arquitetura do projeto para entender onde os problemas vão explodir. String IDs duplicados aparecem em projetos React quando você usa hardcode como key em múltiplos componentes. Tradutores acabam vendo a mesma string três vezes e traduzindo de formas diferentes. Isso gera inconsistência silenciosa que só aparece em produção. Depois vem a classificação de conteúdo. Nem tudo precisa passar pelo mesmo fluxo. UI elements, mensagens de erro, conteúdo marketing e documentação técnica exigem workflows completamente diferentes. Eu separei isso em camadas no meu último projeto: camadas críticas com revisão humana obrigatória, camadas de suporte com tradução automática revisada, e camadas estáticas que só precisam de validação visual.
O problema que ninguém conta
No segundo trimestre de 2024, eu perdi quatro dias inteiros porque não previ um conflito de formatação em localização árabe. O sistema usava placeholders com ordem fixa de variáveis: Olá {nome}, você tem {idade} anos. Em português funciona perfeitamente. Em árabe, que é RTL e tem regras morfológicas de pluralização completamente diferentes, o resultado era uma sentença gramaticalmente incorreta que nenhum tradutor conseguia consertar só manipulando texto. A string inteira precisava ser reescrita com suporte a plurais plurais via ICU MessageFormat, e isso exigia mudanças no código-fonte, não apenas no glossário. Workaround que funcionou: implementei suporte a CLDR plural rules desde o início do desenvolvimento, usando o formato de mensagens ICU em vez de simples interpolation. Custou uma semana extra no sprint, mas eliminou três rodadas de correção em Árabe, Hebraico e Tailandês que normalmente acontecem na fase de QA.
Sobre ferramentas e automação
Plataformas como Crowdin, Lokalise e Transifex resolvem o problema de colaboração e versionamento. A limitação real é que nenhuma delas detecta automaticamente strings que quebram em contextos específicos. Um texto de 15 caracteres em inglês pode precisar de 60 caracteres em finlandês. O layout quebra. Isso é previsível com medidas de expansão de texto por idioma, mas a maioria dos times ignora até ver o bug em tela cheia. Uma prática que reduz drasticamente retrabalho é usar uma tabela de expansão de texto antes de começar qualquer atividade de localização. Cada idioma alvo tem um fator de multiplicação típico: espanhol expande 25-35%, japonês contrai cerca de 30%, alemão expande 30-45%. Se o seu layout aceita 35% de expansão sem quebrar, você evita pelo menos metade dos problemas visuais pós-tradução. Para download de glossários e templates de strings, o padrão da indústria é XMAL ou JSON com chaves hierárquicas. Estruturas planas como { "hello": "olá" } funcionam para projetos pequenos, mas colapsam quando você precisa de contexto para tradutores. Chaves namespaceadas como nav.header.cta.primary resolvem isso e levam menos de uma hora para implementar em qualquer stack.
O que funciona e onde isso falha
Localização manual com revisores nativos funciona bem para conteúdo de alto valor: páginas de venda, onboarding, emails transacionais. Para logs do sistema, nomes de campos internos e documentação de API, o custo-benefício é ruim. Nesses casos, tradução automática neural com pós-revisão leve entrega resultados aceitáveis em 10-15% do custo, dependendo do par de idiomas. O ponto cego mais comum é assumir que localização é sinônimo de tradução. Data, hora, moeda, unidades de medida, fuso horário, conformidade regional e test coverage para cada variante linguística formam o resto do trabalho. Um app que só traduz texto mas não converte datas para o formato BR versus US vai falhar feio em mercados específicos. O mesmo vale para formatos de endereço e validação de campos. Se você tem um projeto grande com mais de cinco idiomas alvo e budget limitado, considere começar com os mercados que geram 80% da receita e tratar os outros como secundários. Localizar para todos os idiomas ao mesmo tempo raramente faz sentido comercialmente, exceto em plataformas open source onde o investimento é diferente.
Galeria
-

Atividade matemática sobre localização espacial | Atividades de ... -

Atividades De Localização 4 Ano - ZULEDU -
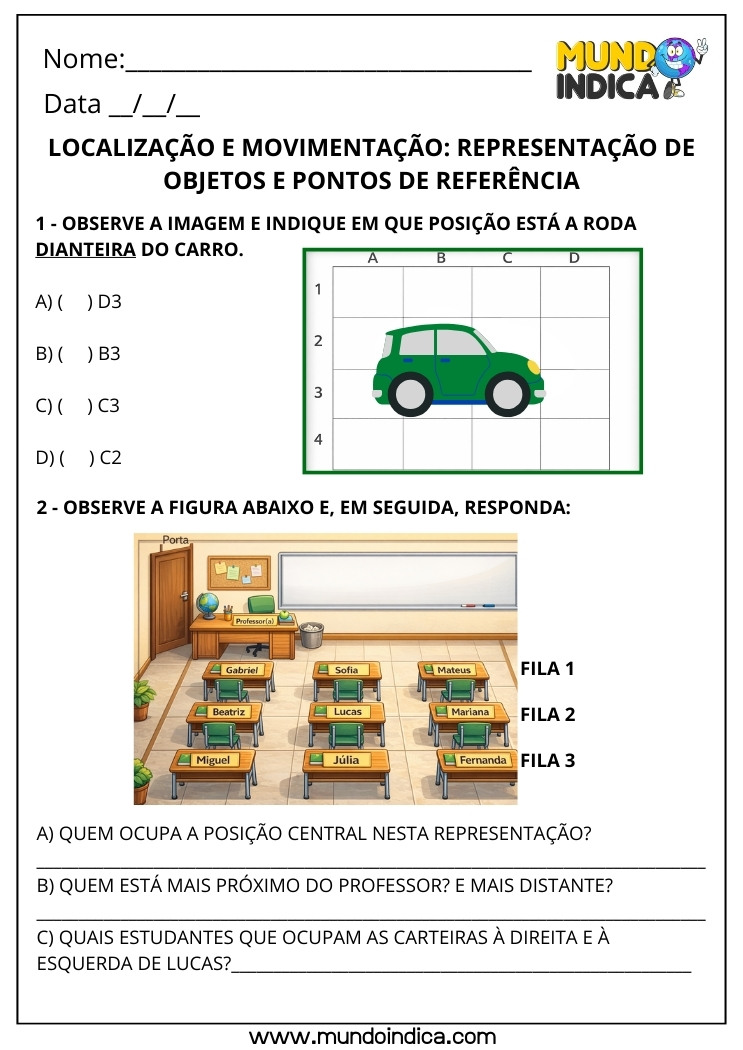
Atividades de Matemática 3º Ano sobre Localização e Movimentação para ... -
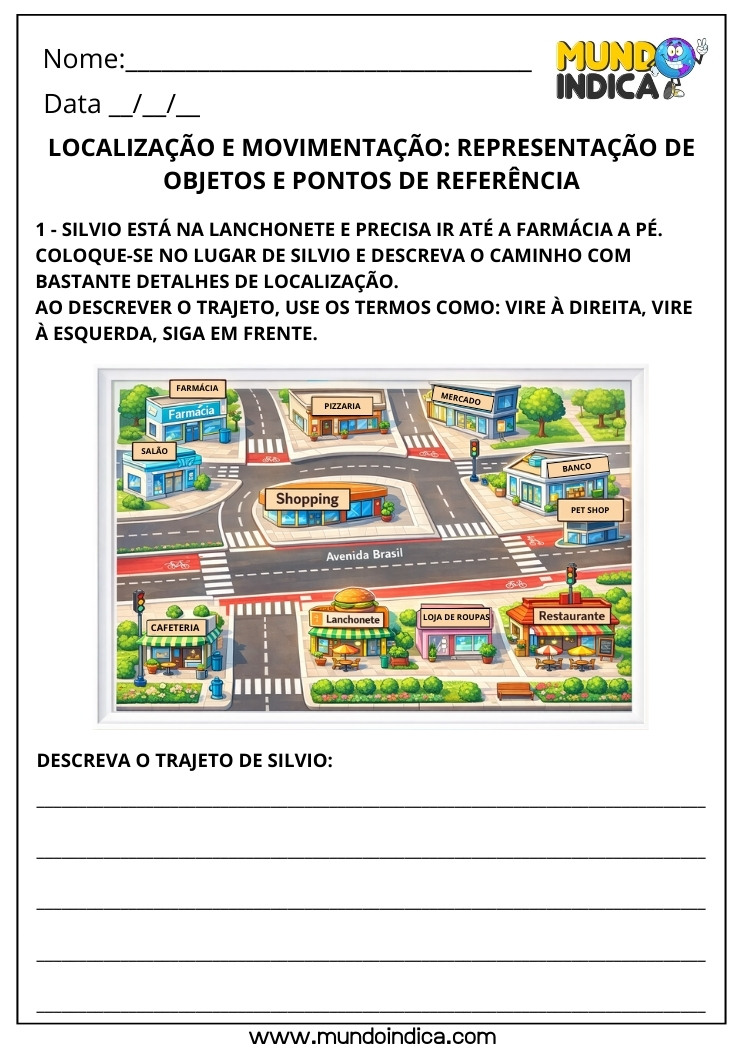
Atividades de Matemática 3º Ano sobre Localização e Movimentação para ...
