Banco De Dados Faculdade
Configurando um banco de dados para projetos acadêmicos: o que realmente funciona
A maioria dos alunos de faculdade entra em banco de dados achando que vai decorar comandos SQL e depois aplicar em qualquer cenário. Na prática, o primeiro semestre é uma mistura de normalização teórica, instalação frustrada de servidores e consultas que levam cinco minutos para rodar porque esqueceu um índice. Vou explicar como eu vejo isso funcionar no dia a dia, com exemplos práticos, e incluir um link no final caso você queira baixar algum material de apoio.
Por que banco de dados faculdade ainda causa dor de cabeça
O principal problema não é o conceito em si. É a diferença entre o que o professor mostra na lousa e o que acontece quando você tenta colocar algo em produção, mesmo que seja um projeto de faculdade. Achei que era só levantar uma base PostgreSQL num container, criar tabelas e pronto. Aí chegou a hora de popular com dados de teste e percebi que o SELECT mais simples estava levando quarenta segundos. Falta de índices, tipagem errada, Foreign Key apontando pra coluna varchar — coisas dessas que ninguém fala nas aulas.
O básico que você precisa ter claro antes de começar
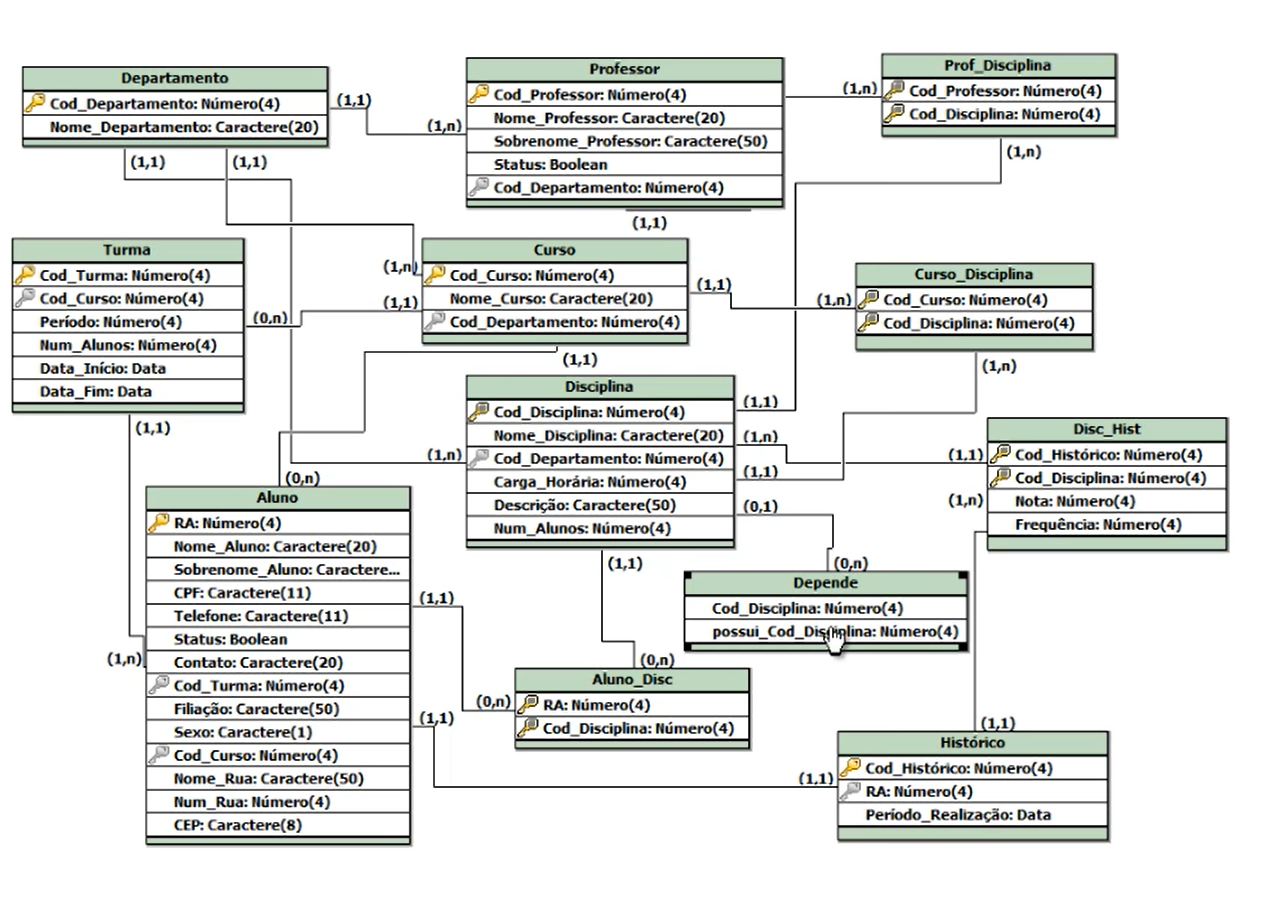
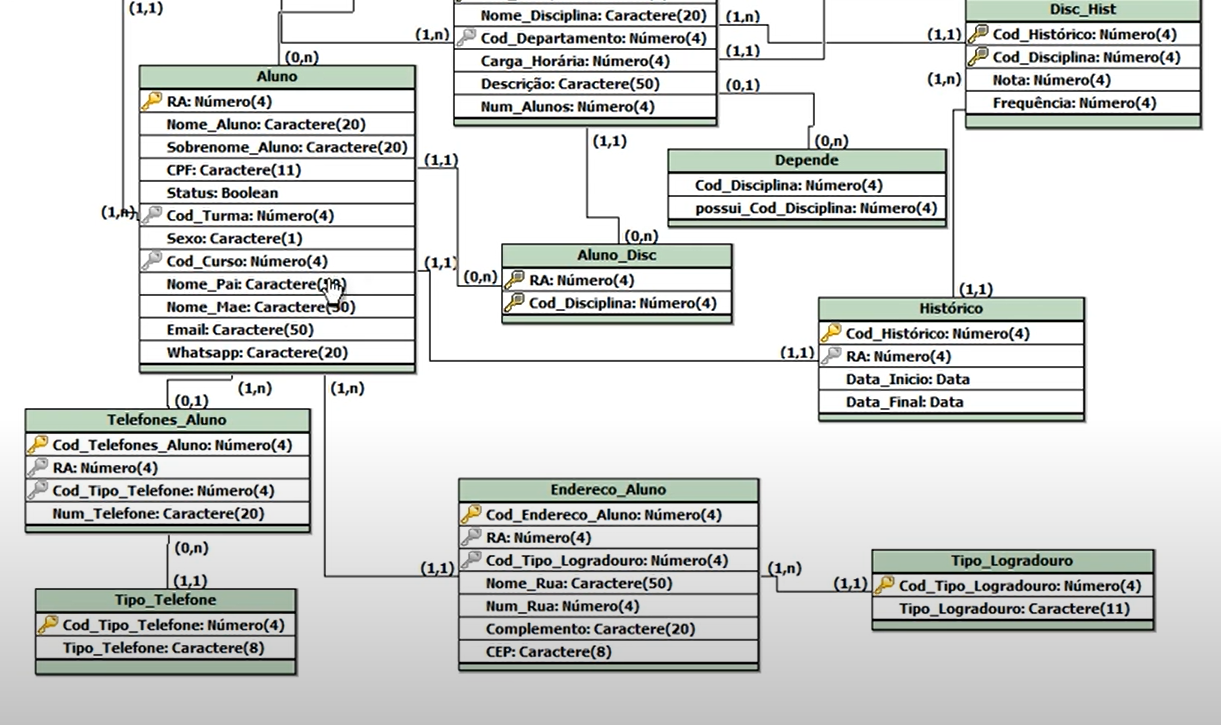
Banco de dados é um sistema organizado para armazenar, recuperar e manipular dados de forma eficiente. No contexto acadêmico, geralmente você vai lidar com modelos relacionais, seja usando MySQL, PostgreSQL, SQLite ou até Oracle em algumas faculdades mais tradicionais. O conceito central é a relação entre tabelas. Cada tabela representa uma entidade, com colunas definindo seus atributos e linhas sendo os registros. A chave primária identifica exclusivamente cada linha. A chave estrangeira cria o vínculo com outra tabela. Não é segredo, mas muita gente pula essa parte e vai direto pra modelagem visual sem entender a restrição de integridade referencial. Quando o banco deixa você inserir um registro com FK inválida, o problema não tá no software, tá na falta de constraint.
Modelagem e normalização na prática
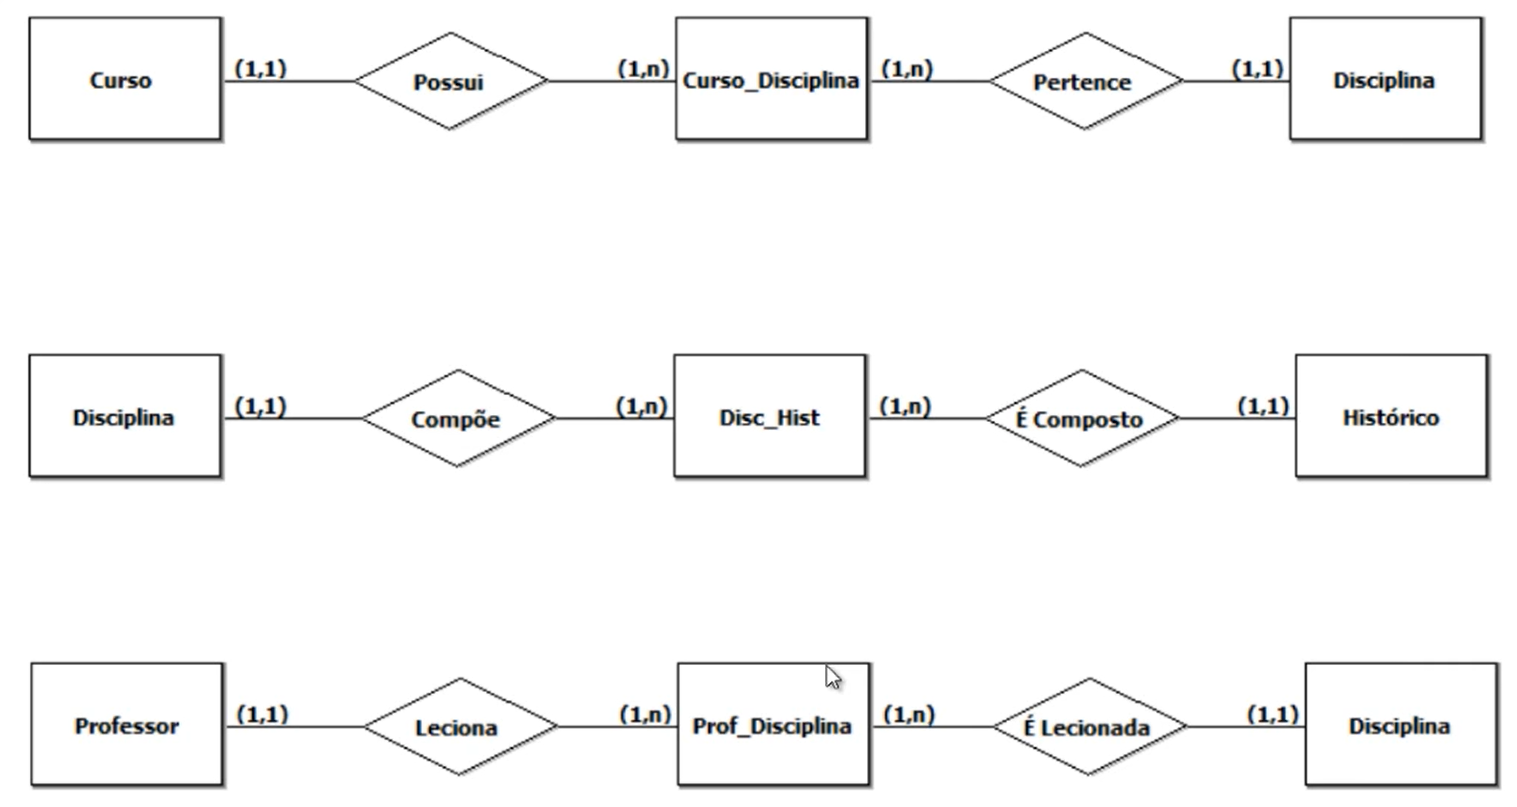
Normalização é o processo de organizar os dados para reduzir redundância e anomalias de atualização. As formas normais mais cobradas são 1FN, 2FN e 3FN, mas na vida real raramente você vai precisar chegar na 4FN ou 5FN para um projeto acadêmico. 1FN exige que cada coluna contenha valores atômicos, ou seja, nada de múltiplos valores na mesma célula. Se você tem uma coluna chamada telefones com valor "123456789 / 987654321", isso já quebra a primeira forma normal. 2FN exige que todo atributo não-chave dependa de toda a chave primária, não apenas de uma parte dela. Isso é especialmente relevante quando sua chave primária é composta por duas ou mais colunas.
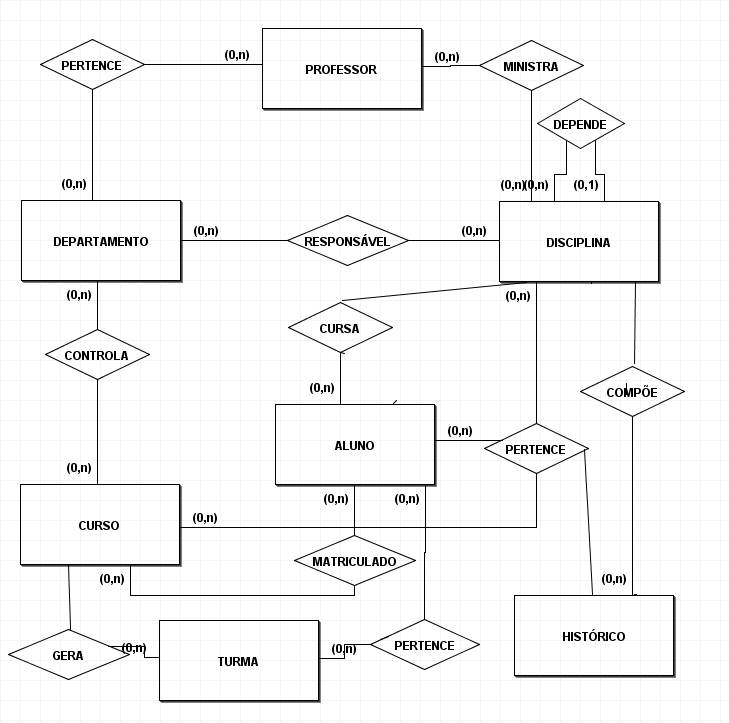
3FN elimina dependências transitivas. Um atributo não-chave não pode depender de outro atributo não-chave. Se aluno depende de curso e curso depende de coordenador, aluno indiretamente depende de coordenador, o que viola a 3FN. Aqui vai um insight que poucos professores destacam: normalização excessiva pode prejudicar a performance. Dividir uma tabela que raramente é consultada separadamente só aumenta o número de JOINs. Às vezes, uma leve desnormalização controlada faz mais sentido do que seguir a forma normal até o fim.
Instalação e configuração: o caminho menos doloroso
Para projetos de faculdade, PostgreSQL é a minha recomendação padrão. É gratuito, robusto, bem documentado e suporta funcionalidades avançadas que aparecem em provas e trabalhos, como window functions, CTEs e tipos JSON. O passo a passo básico: Baixe o instalador no site oficial do PostgreSQL ou use o pgAdmin que vem bundle. Durante a instalação, defina uma senha forte para o usuário postgres. Não use 1234 ou senha123, porque alguém vai tentar conectar e dar errado na hora da demonstração.
Após a instalação, abra o pgAdmin ou use o psql no terminal. Crie um banco de dados com naming convention consistente, tipo nome_do_projeto_db. Evite acentos e espaços no nome. Se quiser algo mais leve e rápido pra rodar em qualquer máquina sem instalação, SQLite funciona bem pra protótipos e testes unitários, mas não recomendo pra projetos que precisam simular concorrência ou acesso multiusuário. Link direto pro download do PostgreSQL: postgresql.org/download
Criando tabelas com constraints adequadas
Um erro comum é criar tabelas sem definir constraints. Veja esse exemplo: CREATE TABLE aluno (id SERIAL, nome VARCHAR, email VARCHAR, curso_id INT); Parece inofensivo, mas tem problemas aqui. Nome e email deveriam ter tamanho definido. Email deveria ter UNIQUE. curso_id deveria ter FOREIGN KEY referenciando a tabela curso. E se curso_id for NULL quando não fizer sentido?
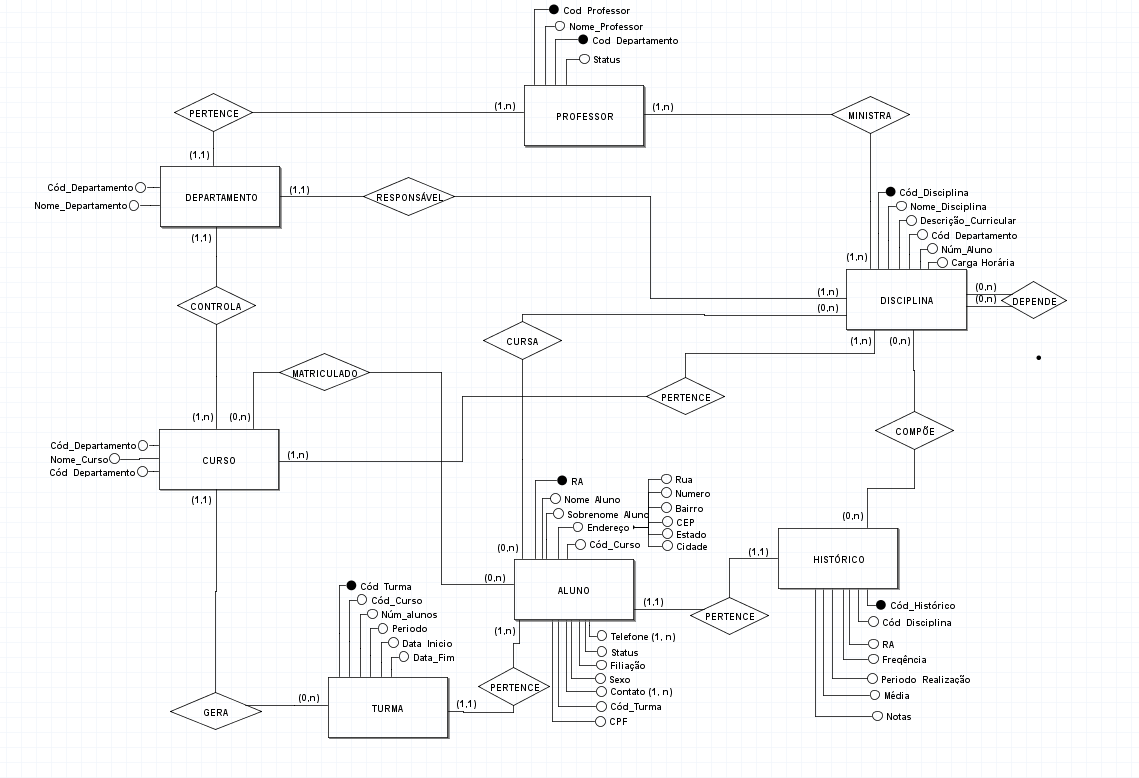
A versão corrigida seria algo assim: CREATE TABLE aluno ( id SERIAL PRIMARY KEY, nome VARCHAR(100) NOT NULL, email VARCHAR(255) NOT NULL UNIQUE, curso_id INTEGER NOT NULL REFERENCES curso(id) ); Isso parece burocrático no início, mas na hora de fazer UPDATE ou DELETE, as constraints te protegem de destruir dados sem querer.
Índices: quando adicionar e quando não adicionar
Índices aceleram leituras mas desaceleram escritas. Toda vez que você insere, atualiza ou apaga uma linha, o banco precisa manter o índice atualizado também. Adicione índice em colunas que você usa frequentemente em WHERE, JOIN e ORDER BY. Em tabelas pequenas, tipo menos de mil linhas, o impacto é imperceptível. Em tabelas com centenas de milhares de registros, a diferença é abismal. Um caso que eu enfrentei: tinha uma tabela de transações com cerca de 500 mil linhas. Uma consulta filtrando por data e tipo de transação levava onze segundos sem índice. Adicionei um índice composto nas colunas data e tipo. A consulta passou a rodar em oitenta milissegundos. Onze segundos pra oitenta milissegundos é o tipo de ganho que transforma um projeto de avaliação numa apresentação digna.
O contraponto: se você indexar tudo, o banco vai gastar mais tempo mantendo os índices do que executando as consultas. A regra prática é indexar colunas de filtro e ordenação, não colunas de status com poucos valores distintos como verdadeiro ou falso.
Consultas avançadas que aparecem em provas e trabalhos
Subconsultas correlacionadas são aquelas que dependem de valores da consulta externa. Funcionam, mas podem ser pesadas em tabelas grandes porque são executadas uma vez por linha. CTEs (Common Table Expressions) com a cláusula WITH melhoram a legibilidade e em alguns casos a performance. São úteis pra dividir consultas complexas em partes menores. Window functions como ROW_NUMBER(), RANK() e LAG() aparecem constantemente em exercícios de banco de dados faculdade e são muito usadas no mercado também. A sintaxe é straightforward, mas o uso correto exige entender a cláusula OVER.
Exemplo prático de window function: SELECT nome, salario, RANK() OVER (PARTITION BY departamento ORDER BY salario DESC) as posicao FROM funcionario; Isso retorna o ranking salarial dentro de cada departamento sem precisar de subconsulta ou self-join.
Transações e isolamento: o que todo aluno deveria saber
Transação é um bloco de operações que deve executar completamente ou não executar nada. O princípio ACID (Atomicidade, Consistência, Isolamento, Durabilidade) é a base de tudo. O nível de isolamento controla o quanto transações concorrentes podem interferir umas nas outras. Os níveis padrão são READ UNCOMMITTED, READ COMMITTED, REPEATABLE READ e SERIALIZABLE. PostgreSQL usa MVCC, que significa que cada consulta vê uma snapshot dos dados no momento em que começou. Isso evita locks desnecessários, mas pode causar o problema de leitura fantasma em níveis de isolamento mais baixos.
Na prática acadêmica, você vai usar BEGIN, COMMIT e ROLLBACK. A dica é sempre terminar transações com COMMIT explícito e testar ROLLBACK em ambiente de desenvolvimento antes de aplicar em produção, mesmo que seja um banco de teste.
Erros frequentes que derrubam projetos na reta final
Esquecer de colocar limites de tamanho em VARCHAR. Isso parece bobo até você receber um nome com duzentos caracteres e o banco rejeitar a inserção. Não tratar campos NULL de forma consistente. NULL não é o mesmo que zero ou string vazia. Operações com NULL retornam NULL, o que quebra lógica condicional e agregações sem aviso. Depender de ORDER BY implícito. Tabelas não têm ordem garantida. Se sua aplicação ou relatório assume uma ordem específica sem cláusula ORDER BY, o resultado pode mudar a qualquer momento.
Usar nomes de colunas reservados como order, group, select sem fazer o escape correto. O PostgreSQL aceita, mas o comando fica confuso e outros bancos podem rejeitar. Um problema específico que tive: criei uma tabela com coluna date. O PostgreSQL entende date como palavra reservada e, dependendo da versão e configuração, gera erro silencioso ou comportamento inesperado. A solução foi renomear pra data_criacao e ajustar todas as consultas e o código da aplicação.
Alternativas ao modelo relacional tradicional
Para projetos que envolvem dados não estruturados ou flexibilidade extrema, bancos NoSQL como MongoDB ou Firebase podem fazer mais sentido. A desvantagem é que você perde integridade referencial, transações ACID completas e a riqueza de consultas que o SQL oferece. Se o trabalho da faculdade pede explicitamente modelagem relacional, fique com PostgreSQL ou MySQL. Se o foco é velocidade de desenvolvimento e os dados são essencialmente documentos JSON, considere MongoDB.
Recursos úteis e downloads
Além do link pro PostgreSQL que coloquei acima, o site do db-fiddle permite testar consultas SQL online sem instalar nada. É útil pra validar queries antes de aplicar no banco do projeto. Para modelagem visual, o pgModeler é gratuito e gera scripts SQL a partir do diagrama ER. Economiza tempo significativo na documentação do trabalho. O livro "Database System Concepts" do Silberschatz, Korth e Sudarshan é referência acadêmica sólida. A versão em inglês é mais fácil de encontrar, mas há resumos e tradutores automáticos decentes.
Se quiser um script SQL completo com exemplos de criação de tabelas, constraints, índices e consultas avançadas baseado nos pontos que discuti aqui, posso compartilhar. Basta pedir nos comentários.