Big Data É Um Conceito Melhor Definido Como

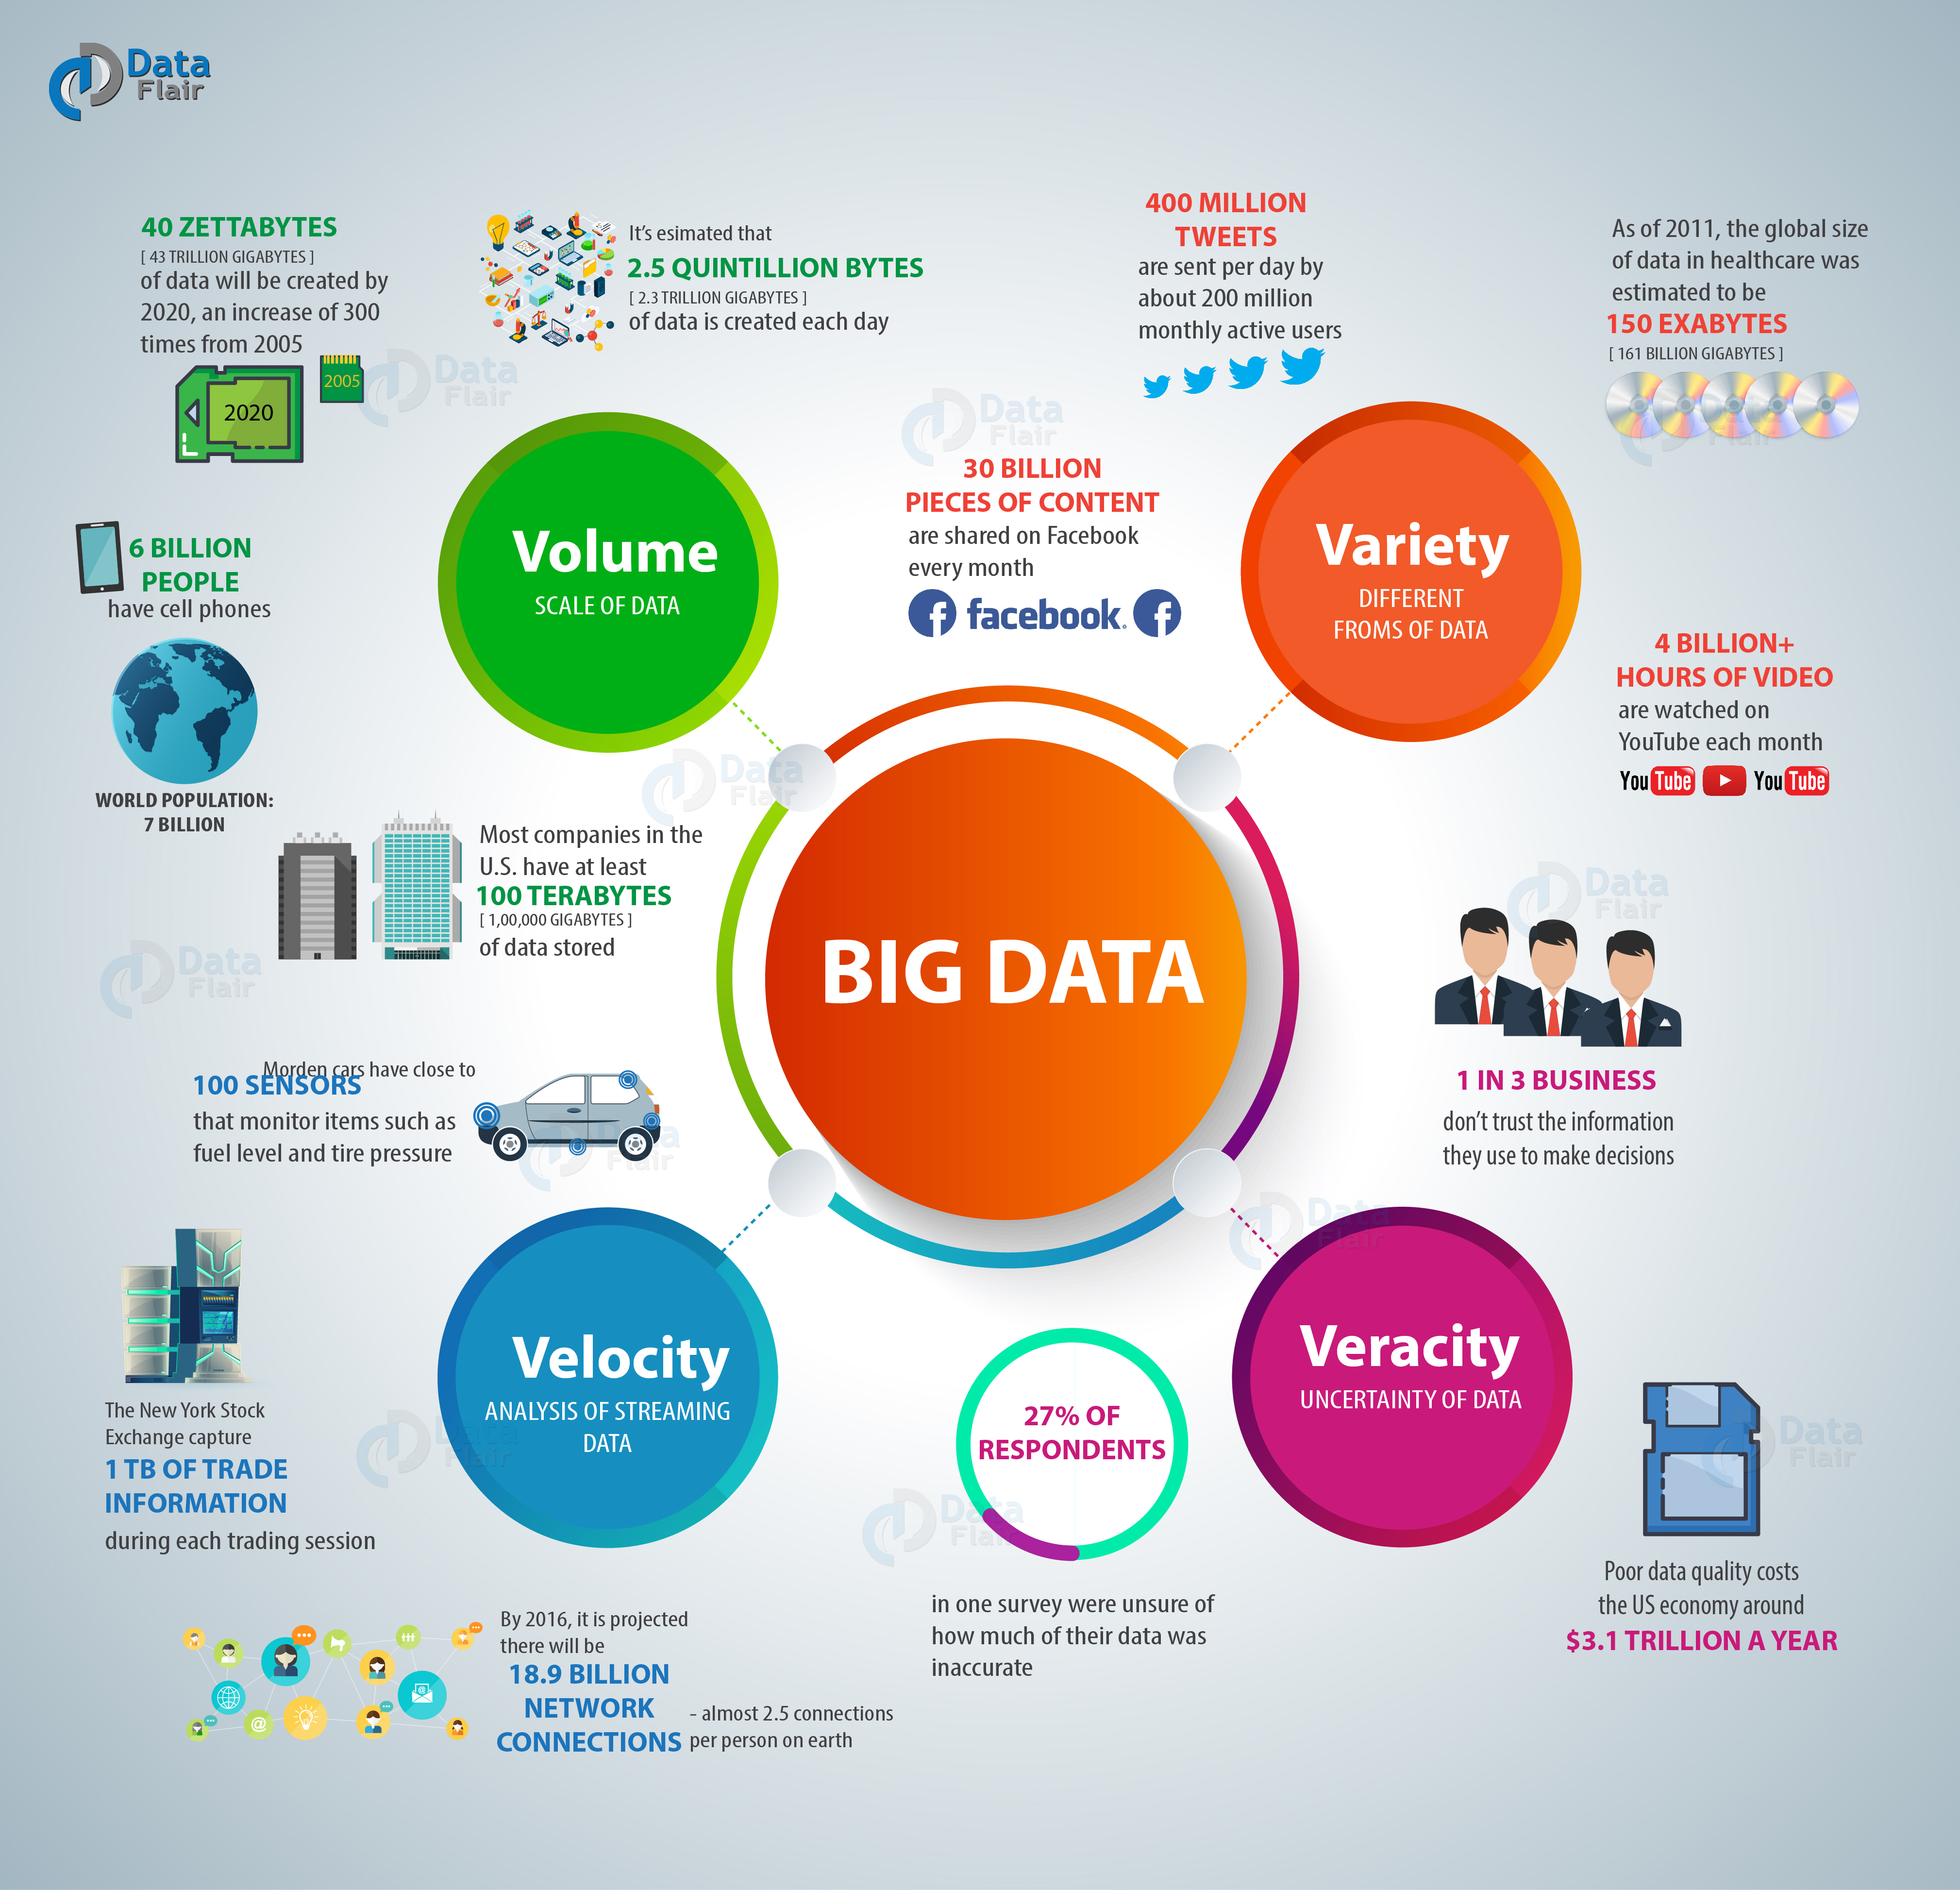
O que realmente é big data na prática
Muita gente trata big data como se fosse apenas "muito dado". Não é. É uma categoria de problema que exige ferramentas diferentes das que você usa quando tem uma tabela de dez linhas. A definição útil não gira em torno do volume sozinho. Gira em torno da combinação de volume, velocidade e complexidade estrutural que quebra os métodos tradicionais de análise. a incapacidade de processar ou analisar um conjunto de dados com ferramentas convencionais, exigindo arquitetura distribuída e modelos adaptados às características do fluxo. Isso significa que o conceito começa onde o Excel, o MySQL padrão ou um pandas simples dão erro. Quando você tenta carregar um dump de três terabytes em uma planilha, o problema não é a ambition do projeto. O problema é que a ferramenta não foi feita para isso. Big data é o termo que colamos nesse momento de quebra.
No dia a dia, eu trabalho com logs de eventos, séries temporais de sensores e transações financeiras. Em um projeto recente, precisei agregar quase 400 gigabytes de dados de cliques em sessões de usuários, com horários em milissegundos e metadados aninhados em JSON. Tentei primeiro com Spark local, em modo single-node, com 32GB de RAM alocados. O job estourava a memória a cada dois minutos. O gargalo não era o processamento, era a seralização e o shuffle em disco. A solução foi particionar os dados por data e ID de sessão antes do agregado, salvar em Parquet com compressão Snappy, e rodar o aggregação em cluster com executor distribuído. O tempo caiu de algo indeterminado por causa dos crashes para cerca de 18 minutos em produção. Isso é big data na prática: não é o tamanho que define, é o comportamento inesperado da ferramenta quando o volume atinge certo patamar. Outra coisa que poucos dizem é que big data não é sinônimo deMachine Learning avançado. Eu vejo muita gente achar que precisa de redes neurais porque o dataset é grande. Na maioria das vezes, um modelo de regressão bem regularizado ou uma árvore de decisão com feature engineering adequado resolve. O tamanho dos dados só se torna vantagem quando você tem dados heterogêneos e não-lineares que modelos simples não capturam. Se o seu dado é linear e bem comportado, mais dados só vão acelerar o overfitting se você não controlar a complexidade do modelo. Há também um ponto cego sobre qualidade. Quanto mais dados, mais ruído estrutural aparece. Em um projeto de análise de churn para uma operadora de telecomunicações, tínhamos 2 milhões de registros de clientes com campos como "data de última compra" e "tipo de plano". A primeira análise mostrou que o churn caía drasticamente em clientes com plano "premium". Parecia uma descoberta brilhante. A verificação posterior revelou que o campo "tipo de plano" tinha valores nulos codificados como "premium" em parte do banco de dados legado. A correção foi simples: validar a codificação contra a tabela mestre de planos e tratar nulos como categoria separada. O resultado mudou completamente a recomendação estratégica. Isso acontece frequentemente em big data, porque a escala mascara inconsistências que em datasets menores seriam óbvias.
Se você está começando, o caminho mais direto é dominar o ecossistema Hadoop primeiro. Não precisa implementar do zero. Use emuladores como o MiniDFSCluster ou plataformas como o Databricks Community Edition para entender como o HDFS partitiona arquivos e como o YARN aloca recursos. Depois, migre para Spark, que é o padrão da indústria para processamento distribuído. Para ingestão, Kafka ou Flume resolvem a maior parte dos problemas de streaming. Se o orçamento for apertado, comece com DuckDB em modo distribuído; ele é surpreendentemente competente para datasets de algumas centenas de gigabytes sem a complexidade do cluster completo. O principal erro que vejo é tentar modelar tudo antes de processar. Big data não perdoa modelagem prematura. Primeiro, ingira, limpe e valide. Depois, estruture conforme a necessidade. Um dataset mal estruturado mas limpo vale mais que um modelo elegante alimentado por lixo. Eu já vi equipes gastarem semanas projetando schemas star complexos para dados que depois se mostraram inutilizáveis porque as fontes mudaram de formato duas vezes. A lição é simples: mantenha os dados brutos intactos em armazenamento barato e construa camadas de processamento sob demanda. Outro detalhe técnico que faz diferença: a escolha do formato de arquivo. Parquet é quase sempre superior a CSV para leitura analítica. No meu último benchmark, a leitura de 500GB em Parquet com predicates levou 3 minutos, enquanto o mesmo conjunto em CSV levou 47 minutos. A diferença está na partição de colunas e na compressão. Se o dado é extremamente grande e não muda muito, considere também ORC para ambientes Hive. Se é streaming puro, Avro pode ser mais adequado pela esquema evolutivo.

Monitoramento é outro ponto subestimado. Em ambientes distribuídos, um job que falha pode deixar metadados inconsistentes sem aviso. Configure alertas para task failures, memory spills e stragglers no Spark History Server. Um pipeline que roda há semanas sem supervisão pode acumular erros silenciosos que distorcem análises downstream. Eu aprendi isso na pior forma, quando um job de agregação diária começou a retornar valores zerados em uma coluna chave por causa de um partition skew não detectado. Levei três dias para identificar porque os dashboards pareciam normais até cruzar com a fonte original. Se o seu caso é menor, não force big data. Dados de algumas dezenas de gigabytes com estrutura clara rodam perfeitamente em PostgreSQL com partições ou em ClickHouse para queries analíticas. Big data é sobre escalar donde as ferramentas convencionais falham, não sobre usar tecnologia pesada para problemas leves. A definição correta é essa: é a resposta para um problema de escala que ferramentas tradicionais não resolvem, e não um selo de modernidade. Para quem quer praticar, o conjunto de dados do NYC Taxi & Limousine Commission é um ponto de partida sólido. São cerca de 1 terabyte de trips com geolocalização, timestamps e valores. Baixe os dados brutos, experimente ingerir com Spark, faça agregações por zona e horário, e compare o desempenho entre formatos. A curva de aprendizado é íngreme nos primeiros dois meses, mas depois o raciocínio distribuído vira instinto. O importante é não pular etapas nem achar que o problema é só técnico. Big data é tanto sobre pessoas e processos quanto sobre código.
Galeria
-
Big Data: Conceito, História, Funções E Perspectivas – DHKCZ -

Big Data: Saiba O Que É, Seus Conceito E Características – TUBEQ -
Big Data: Saiba O Que É, Seus Conceito E Características – TUBEQ -

Big Data: O que é, conceito e para que serve | Alura
