Biologia Molecular Do Gene

Entendendo o gene na prática, não na teoria de livro didático
A biologia molecular do gene lida com algo que parece simples na primeira vista mas que se revela um saco de gatos assim que você tenta trabalhar com ele no laboratório ou na análise computacional. O gene é uma unidade funcional do DNA que codifica RNA ou proteína, isso todo mundo sabe. O problema é que essa definição é uma simplificação confortável que não sobrevive ao primeiro contato com dados reais. Eu comecei fazendo clonagem e sequenciamento de genes em vetores bacterianos há muitos anos. O que eu aprendi na marra foi que a sequência que você espera isolar raramente é a sequência que você obtém, e entender por quê é o que separa alguém que lê artigos de alguém que realmente produz dados confiáveis.
Biologia molecular do gene: os fundamentos que importam de verdade
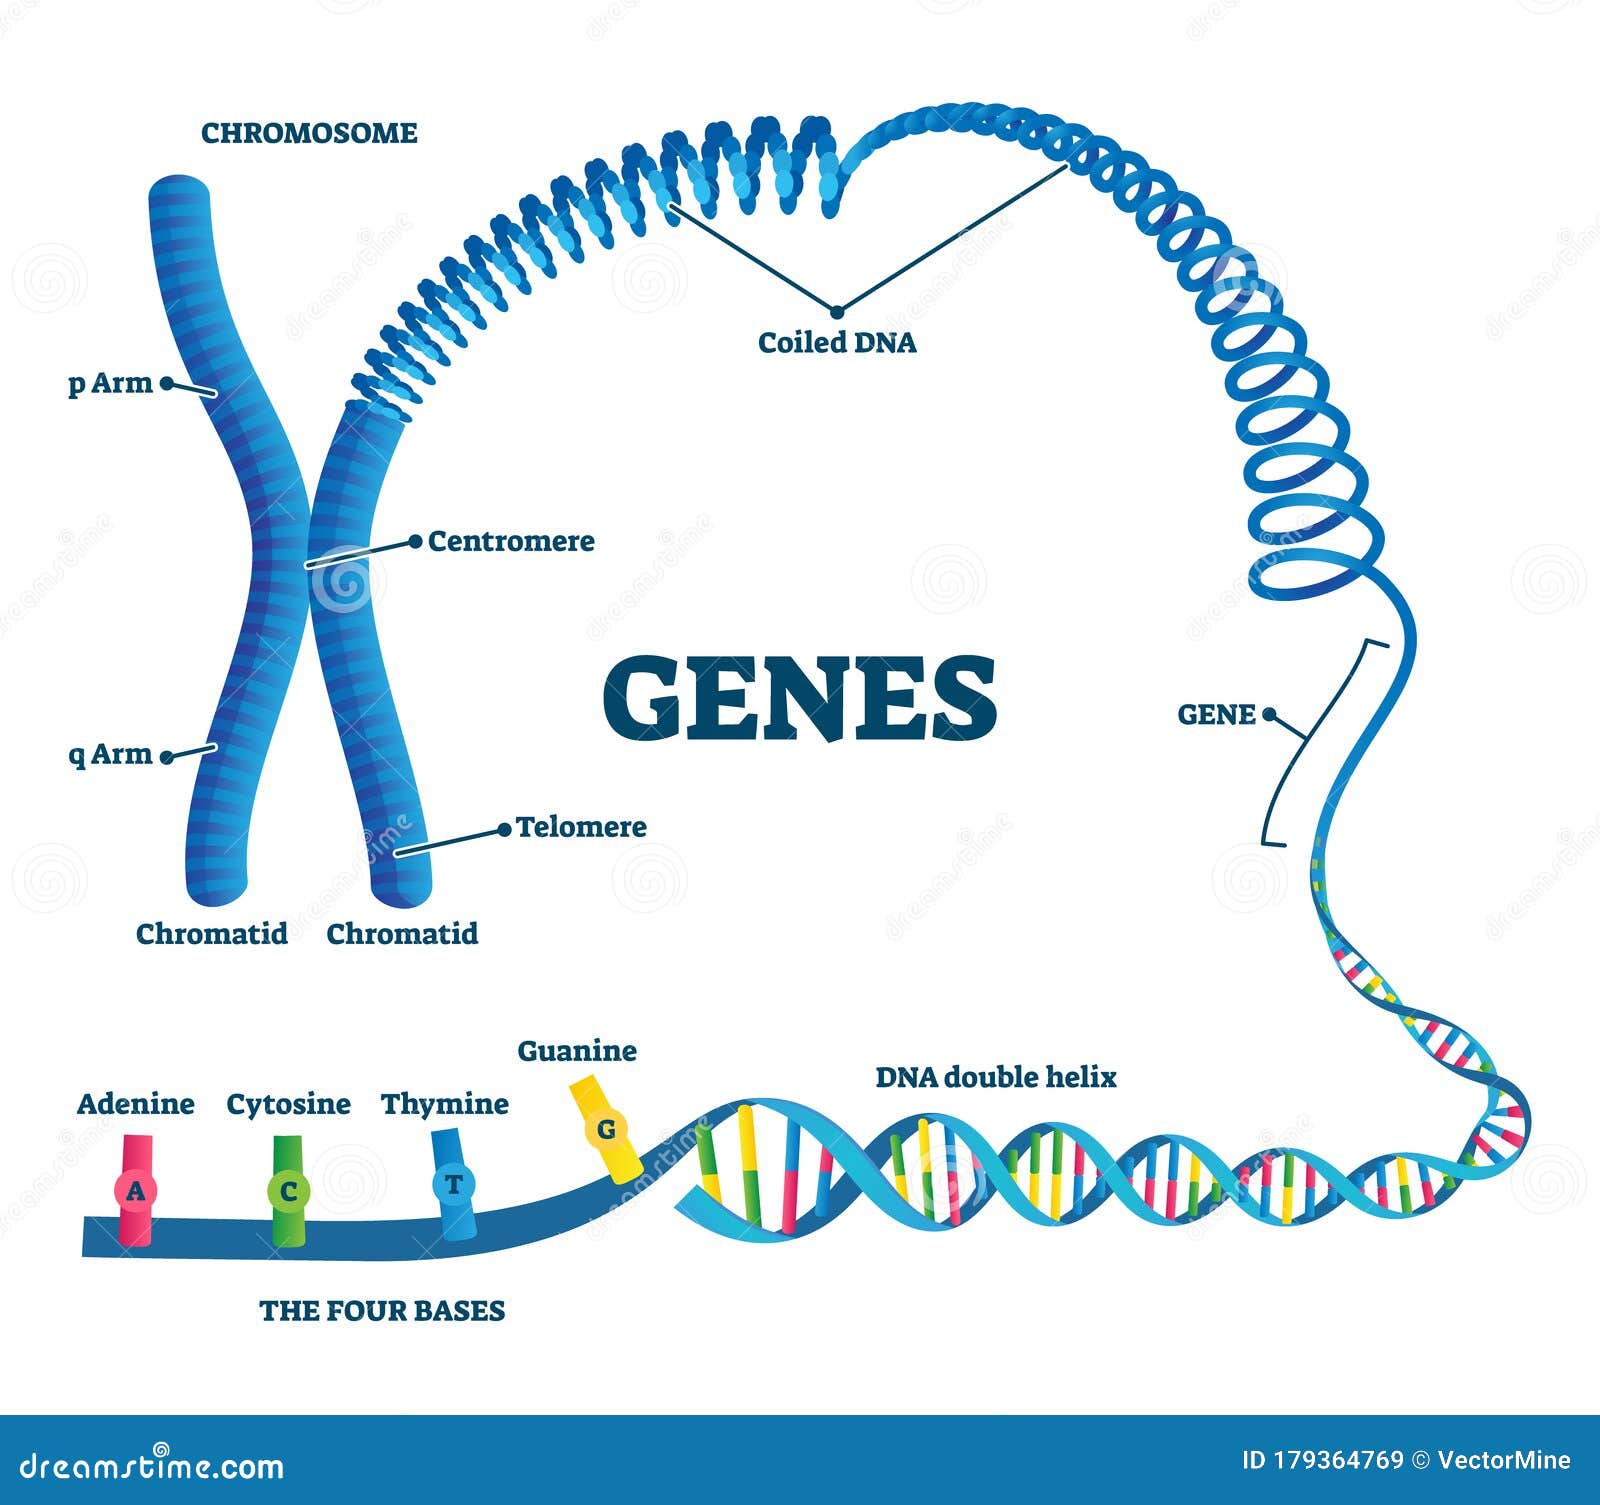
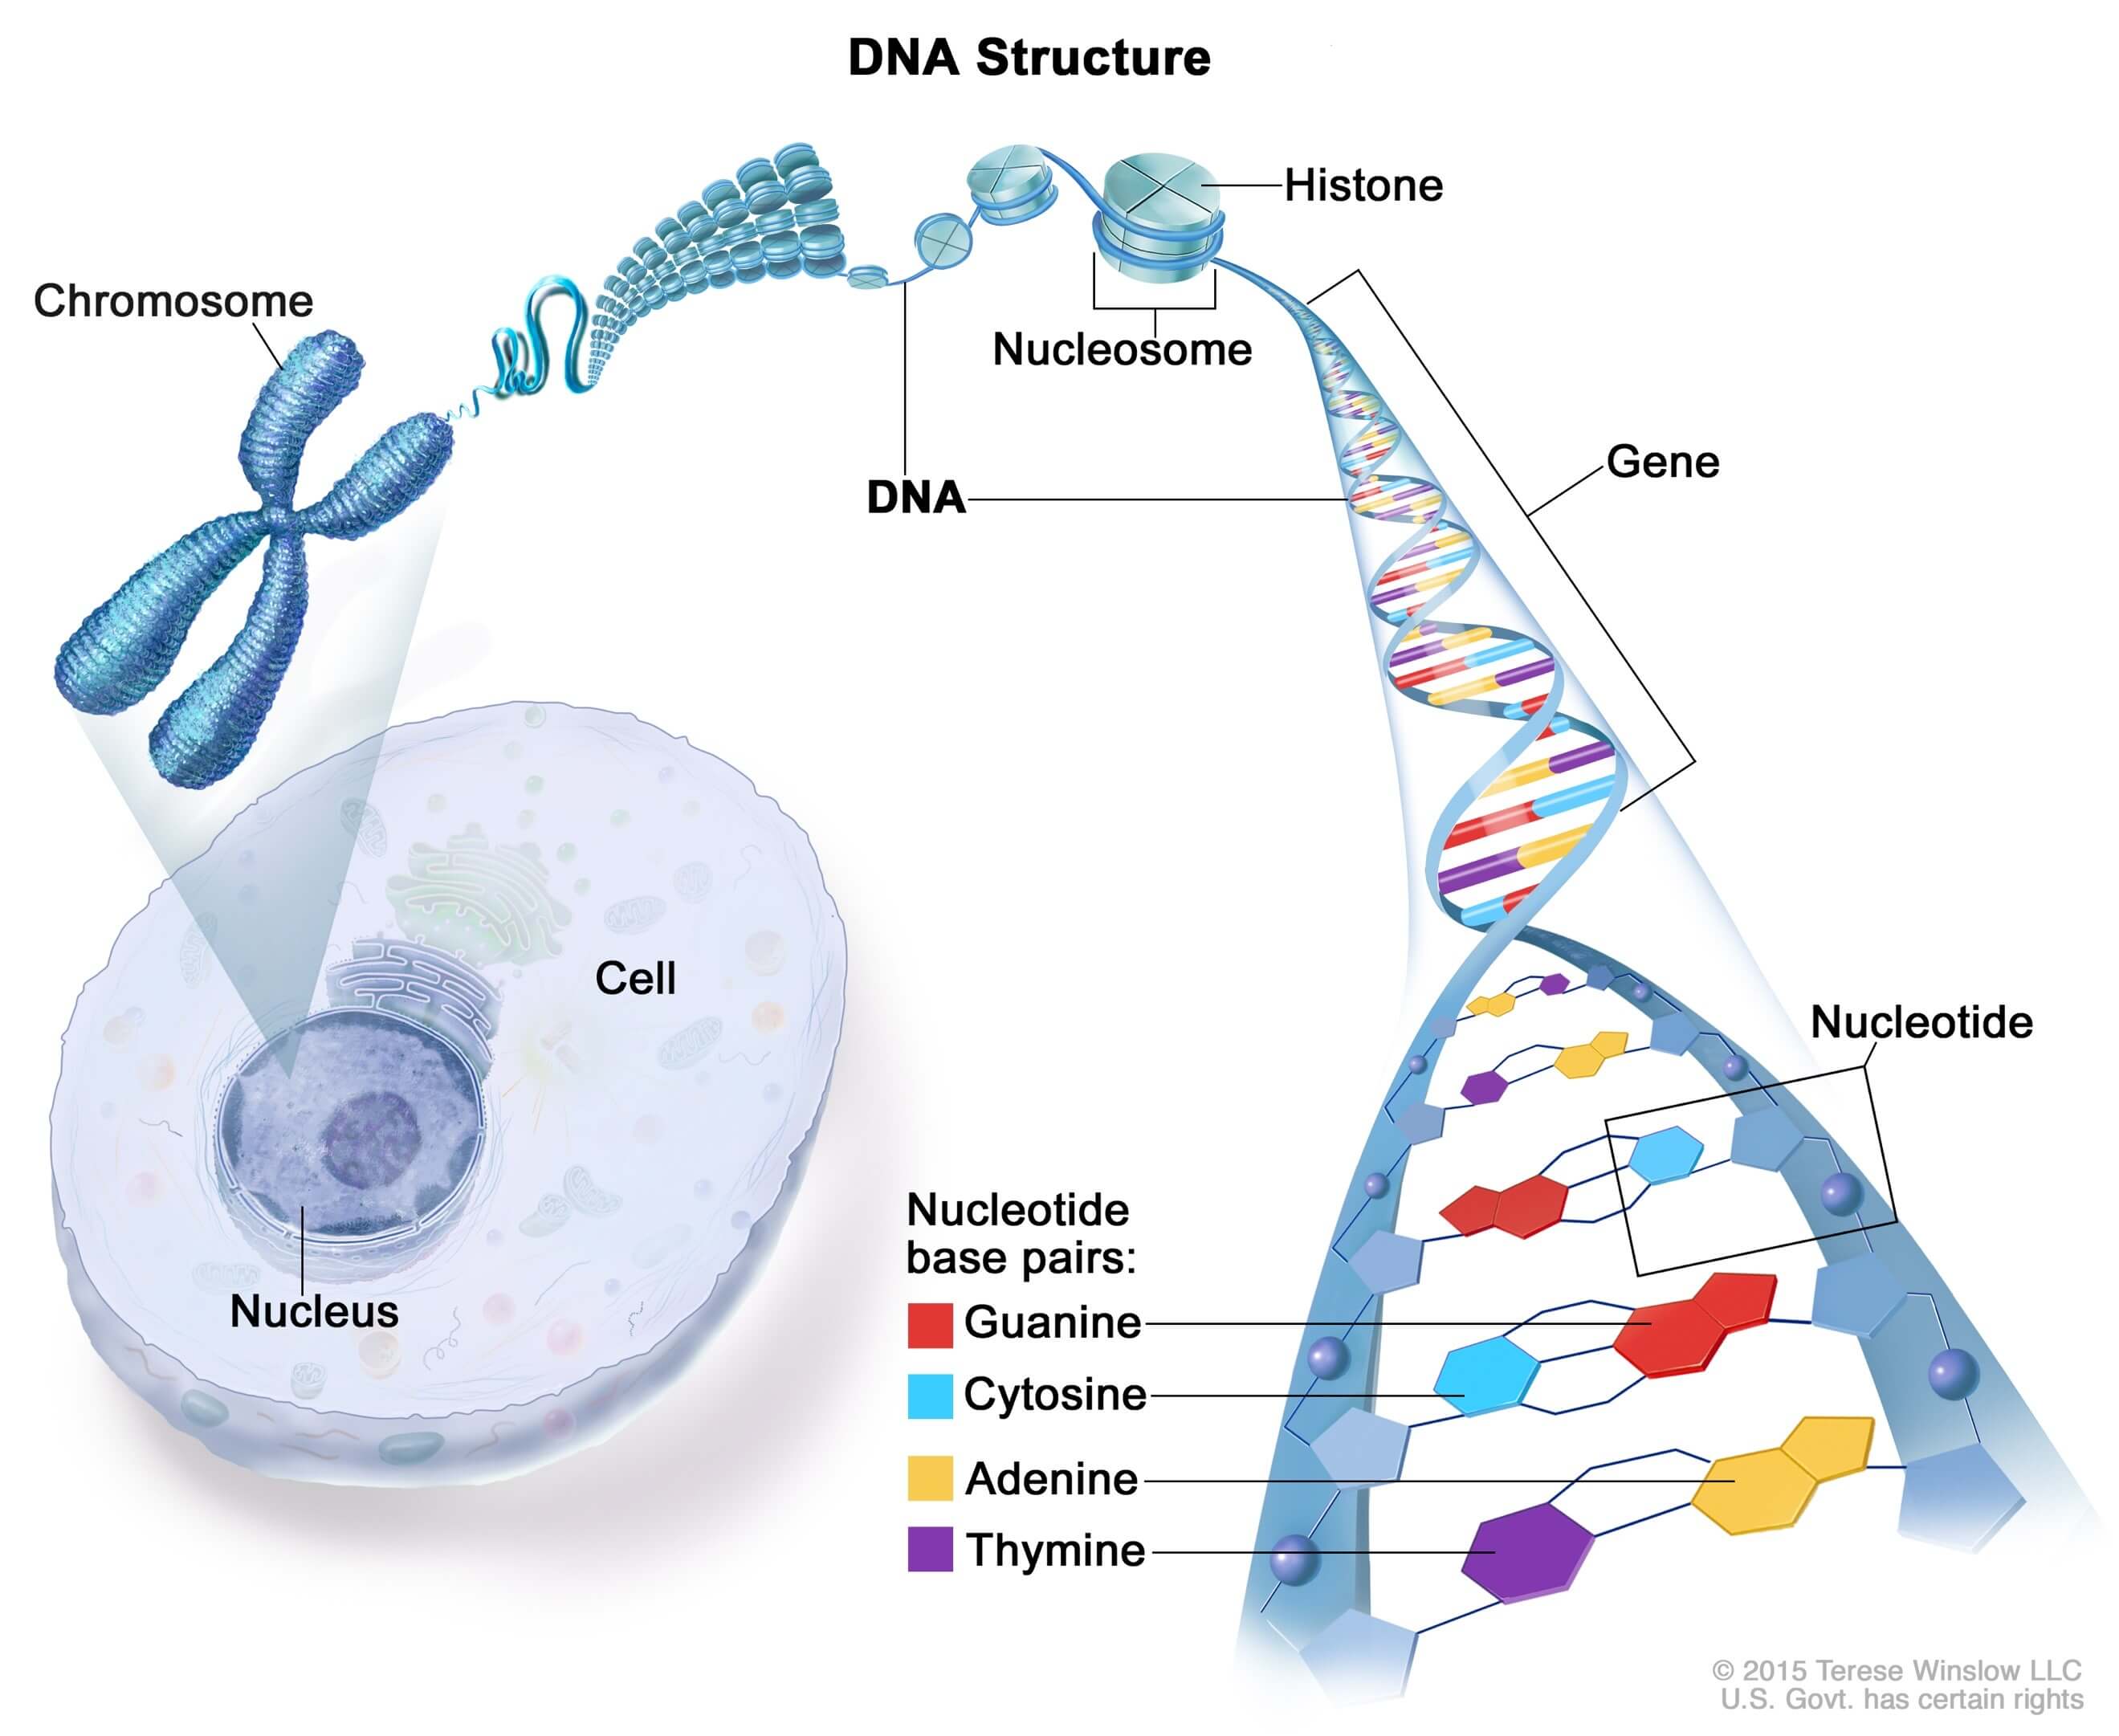
Vamos partir do princípio de que você já sabe o que é DNA, RNA e proteína. O que é relevante aqui é como essas moléculas se relacionam na prática de pesquisa. Um gene, na visão mais atual, inclui regiões codificantes (exons), regiões não codificantes internas (introns), sequências regulatórias promotoras e pós-transcripcionais que controlam quando, onde e quanto produto esse gene produz. Os prócariontes são mais fáceis porque não têm introns. Você isola o DNA, projeta primers, amplifica, clona e pronto, ou quase isso. Em eucariontes, especialmente em eucariotos superiores, o splicing alternado significa que um único gene pode gerar múltiplos transcritos com funções completamente diferentes. Se você projetar um experimento pensando em apenas uma isoforme, seus resultados vão parecer inconsistentes e você vai perder tempo tentando entender o erro que na verdade é a complexidade biológica que você ignorou. A transcrição começa com o reconhecimento do promotor por fatores de transcrição e RNA polimerase. A Regiões UTRs (não traduzidas) nas extremidades do transcrito não codificam proteína mas são essenciais para estabilidade do RNA e regulação traducional. Muitos iniciantes negligenciam as UTRs e projetam primers que ignoram essas regiões, gerando dados que parecem corretos mas que não refletem a regulação real da expressão gênica.
Metodologias práticas para estudo de genes
Existem várias abordagens e a escolha depende do que você quer responder. Sequenciamento Sanger ainda é o padrão ouro para validação de clones e verificação de mutações pontuais. É barato, rápido e confiável quando você tem uma amostra pura. O problema é que não funciona bem para amostras heterogêneas ou quando você precisa avaliar expressão relativa. PCR quantitativo (qPCR) é a ferramenta mais usada para mensurar expressão gênica. A desvantagem que poucos mencionam é a dependência crítica de genes de referência estáveis. Em muitos experimentos com tratamentos farmacológicos ou condições de estresse, genes de referência comuns como GAPDH ou actina variam significativamente. Eu já vi laboratórios inteiros publicarem dados duvidosos por causa disso. O workaround é testar pelo menos três genes de referência com softwares como GeoNorm ou NormFinder antes de confiar em qualquer resultado. Sequenciamento de nova geração (NGS), especificamente RNA-seq, mudou completamente o campo. Você consegue visualizar todos os transcritos de uma vez, identificar isoformas novas, variantes de splicing e até fusões gênicas. O ponto negativo é o custo e a complexidade analítica. Um experimento de RNA-seq bem feito custa entre 300 e 800 reais por amostra dependendo do depth de sequenciamento. A análise bioinformática exige conhecimento de pipelines como STAR para alinhamento, Salmon ou Kallisto para quantificação, e DESeq2 ou edgeR para análise diferencial. Se você não tem experiência com isso, contratar um bioinformata ou fazer parceria com um núcleo de genômica é quase obrigatório.

Para análise funcional, o CRISPR-Cas9 revolucionou o campo. Knockouts gênicos são muito mais eficientes hoje do que com técnicas antigas como RNA interference, que sofrem com silenciamento incompleto e efeitos off-target significativos. O problema do CRISPR é que knockouts completos podem ser letais em certos contextos, e knockdowns parciais com CRISPRi dão uma visão mais refinada mas são tecnicamente mais desafiadores.
Problemas reais que ninguém conta nos tutoriais
Depois de anos lidando com isso, posso listar alguns problemas que aparecem recorrentemente e que normalmente deixam iniciantes travados por horas ou dias. O primeiro é contaminação por DNA genômico em preparações de RNA. Mesmo com DNase treatment, restos de DNA genômico podem amplificar junto com o cDNA durante o qPCR, especialmente se seus primers cruzam junções de exons de forma inadequada. A solução é desenhar primers que introns de pelo menos 50 pb e incluir controles sem transcriptase reversa em cada reação. O segundo problema, e esse eu Aprendi na unha, é a presença de pseudogenes processados. Quando você tenta estudar um gene específico por PCR ou qPCR, pseudogenes processados — cópias retrotranspostas do mRNA original que se integraram aleatoriamente no genoma — podem ser amplificados junto. Eles não têm introns, então primers que deveriam ser específicos falham silenciosamente. Eu passei duas semanas tentando entender por que meus resultados de expressão não faziam sentido até sequenciar os produtos de PCR e descobrir que estava amplificando um pseudogeno a 12 Mb do locus original. A solução foi usar primers que mapeiam exclusivamente para regiões únicas do gene parental, preferencialmente em exons adjacentes a introns, e validar com BLAST contra o genoma de referência antes de qualquer experimento.
Outro problema comum é a variação genética populacional que não é considerada. Polimorfismos de nucleotídeo único (SNPs) na região de emparelhamento de primers podem reduzir drasticamente a eficiência de amplificação ou causar alelo-dropout em sequenciamento. Antes de confiar em dados de genotipagem ou expressão de populações diversas, faça um scan de SNPs na região dos primers usando bancos como dbSNP ou 1000 Genomes.
Limitações e quando as técnicas falham completamente
Nenhuma metodologia é universal. O RNA-seq não detecta bem transcripts muito raros sem depth extremamente alto, que encarece o experimento. Genes com expressão muito baixa exigem bibliotecas com mais de 50 milhões de leituras por amostra para ter confiança estatística, o que dobra ou triplica o custo. CRISPR tem taxas de off-target que variam entre 0,1% e 5% dependendo do design do gRNA. Em experimentos onde o fenótipo esperado é sutil, off-targets podem gerar falsos positivos difíceis de distinguir do efeito pretendido. O uso de versões de alta fidelidade da Cas9 como HiFi Cas9 reduz mas não elimina o problema. Controle com múltiplos gRNAs independentes e complementação com RNAi é o padrão recomendado. qPCR tem uma faixa dinâmica limitada, tipicamente 6 a 7 ordens de grandeza. Se você precisa quantificar diferenças de expressão maiores que isso, como comparação entre tecidos com expressão drasticamente diferente, os dados ficam saturados nas extremidades. NEST-qPCR ou digital PCR são alternativas quando a faixa dinâmica do qPCR convencional não basta.
O que funciona na prática
Se você está começando um projeto de biologia molecular do gene, o conselho mais honesto que posso dar é: planeje muito antes de pipetar. Desenho de primers com ferramentas como Primer3 ou IDT OligoAnalyzer, revisão de especificidade com BLAST, teste de eficiência de amplificação em curva padrão e validação com controle positivo conhecido podem economizar semanas de trabalho frustrante. Para análise de dados, use pipelines estabelecidos e documentados. Evite montar scripts do zero se você não tem familiaridade com Python ou R. Ferramentas como nf-core/rnaseq oferecem fluxos de trabalho reproducíveis e amplamente testados pela comunidade. A curva de aprendizado inicial é maior mas o custo de erros silenciosos em análises caseiras é proporcionalmente maior também. A biologia molecular do gene evoluiu muito e continua evoluindo. Técnicas como edição de base e prime editing estão se tornando viáveis para introduzir mutações precisas sem quebras de fita dupla. Spatial transcriptomics está permitindo mapear expressão gênica com resolução espacial em tecidos inteiros. O campo não para e quem trabalha com isso precisa manter atualização constante, porque o que era padrão há cinco anos já pode ser considerado obsoleto hoje.
O que resta é a paciência. Dados moleculares são barulhentos, sistemas biológicos são complexos e a diferença entre um bom resultado e uma conclusão equivocada muitas vezes está em detalhes que parecem triviais até você olhar para trás e perceber que foram exatamente esses detalhes que fizeram toda a diferença.

Galeria
-
Biologia Molecular do Gene 5a Edição | Livro Artmed Usado 57662354 | enjoei -
Biologia Molecular Do Gene - NAZAEDU