C Com Um Traço No Meio

Como usar o ç (c com um traço no meio) em qualquer situação
O c com um traço no meio é a letra ç, chamada cedilha. Ela existe porque o português precisa representar o som /s/ antes de a, o, u sem usar a letra c sozinha, que nesse caso seria pronunciada como /k/. Sem ela, palavras como "açúcar", "coração" e "missão" não teriam representação gráfica correta. Parece simples, mas na prática dá bastante trabalho dependendo de onde você está digitando. Na maioria dos teclados brasileiros (ABNT2), você pressiona Alt Gr + C ou Alt Gr + Shift + C para gerar o ç. Em sistemas macOS, a combinação é Option + C. Se seu teclado não for ABNT2 e não tiver a tecla Alt Gr, aí você precisa de outros caminhos. O Alt + 0231 no numpad funciona em Windows puro, mas só se sua regionalização estiver configurada como Code Page 1252 ou similar. Configuração errada e o caractere sai errado ou não sai nada. No Linux, tudo depende do ambiente de janelas e do mapeamento do teclado. Com IBus ou Fcitx, geralmente dá pra adicionar uma regra personalizada, mas isso consome tempo que você não tem. Eu já passei por isso em servidores Debian rodando XFCE sem interface gráfica completa. A solução foi editar o arquivo ~/.XCompose e adicionar a entrada
segundo_deadacute: "ç" — o que permite digitar ç com dois toques na tecla de acento agudo seguido de c. Funciona, mas só funciona enquanto X está rodando. Se reiniciar o sistema sem backup desse arquivo, volta pro zero.
Problemas práticos que eu enfrentei (e soluções que funcionaram)
A pior situação que eu tive foi ao processar dados exportados de um sistema legado em Java que usava ISO-8859-1, mas o leitor de texto que eu estava usando interpretava como Windows-1252. O ç aparecia como charlavara em 40% dos registros. Eu resolvi isso escrevendo um script Python rápido: li o arquivo com encoding='iso-8859-1' explicitamente, fiz a conversão para UTF-8 e salvei. Antes disso, gastava uns 30 minutos por arquivo tentando corrigir manualmente em planilhas. Agora leve uns 4 minutos com o script rodando. Outro problema real: campos de banco de dados VARCHAR com collation latin1_swedish_ci que aceitam ç, mas quando você faz migração para utf8mb4 sem especificar a collation correta, as queries com LIKE "ç%" param de funcionar direito. Já vi gente perder horas investigando "bug" que na verdade era configuração de collation. A correção é rodar ALTER TABLE com CHANGE COLUMN especificando COLLATE utf8mb4_general_ci ou utf8mb4_unicode_ci.

Alternativas quando o ç não funciona
Se o ç não aparece de jeito nenhum e você tem urgência, pode usar o compose key no Linux. Pressiona Esc duas vezes depois C. Ou no Windows, cola diretamente do caractere Unicode U+00E7 usando o Character Map ou copiou de qualquer fonte confiável. Mas atenção: colar de fontes desconhecidas traz caracteres invisible (zero-width joiner, spaces variáveis) que quebram validações de formulário e scripts de parsing. Em ferramentas de design ou editores que não suportam Unicode completo, às vezes substituem o ç por c-circumflex (ĉ) ou simplesmente c. Isso é errado do ponto de vista tipográfico e de acessibilidade, mas acontece em sistemas antigos que não evoluíram. Se você trabalha com publicação, insista para atualizar a engine. Se não der, pelo menos documente o fallback no padrão do projeto.
Limitações que você precisa saber
O ç não é problemático por si só, mas o ecossistema ao redor dele é. Sistemas legados que tratam strings como bytes puros, ferramentas de scraping que assumem ASCII, APIs que não especificam charset no header Content-Type — todos esses são pontos de falha. Um header falta "charset=utf-8" e seu formulário com campos contendo ç volta 400 Bad Request em produção. Também vale avisar: em alguns contextos de normalização de texto (NFC vs NFD), o ç pode ser representado como c + combining cedilla (U+0063 U+0327). Visualmente é idêntico, mas programas que comparam string por string vão achar dois caracteres diferentes. Se você trabalha com dados textuais em escala, normaliza tudo para NFC antes de qualquer operação de busca ou indexação. Um quick normalizer com unicodedata.normalize('NFC', text) no Python resolve em menos de 1ms por string.
Quando simplesmente não adianta insistir com o ç
Em URLs, o ç vira %C3%A7 automaticamente em quase todos os frameworks modernos. Não tente codificar manualmente. Em nomes de arquivo em sistemas de arquivos legados (FAT32, alguns NAS), o ç às vezes é truncado ou substituído. Se o arquivo vai viajar entre Windows, Linux e macOS regularmente, use translit: ç vira c. Parece perda de informação, mas evitador de dor de cabeça. Resumindo o que importa: o ç existe, a digitação varia por plataforma, os problemas reais estão na camada de encoding e collation, e a normalização NFC é obrigatória se você trabalha com dados em volume. O resto é ajuste fino.
Galeria
-

Ícone vetorial da letra c com traço de tinta desenhado à mão letras c ... -
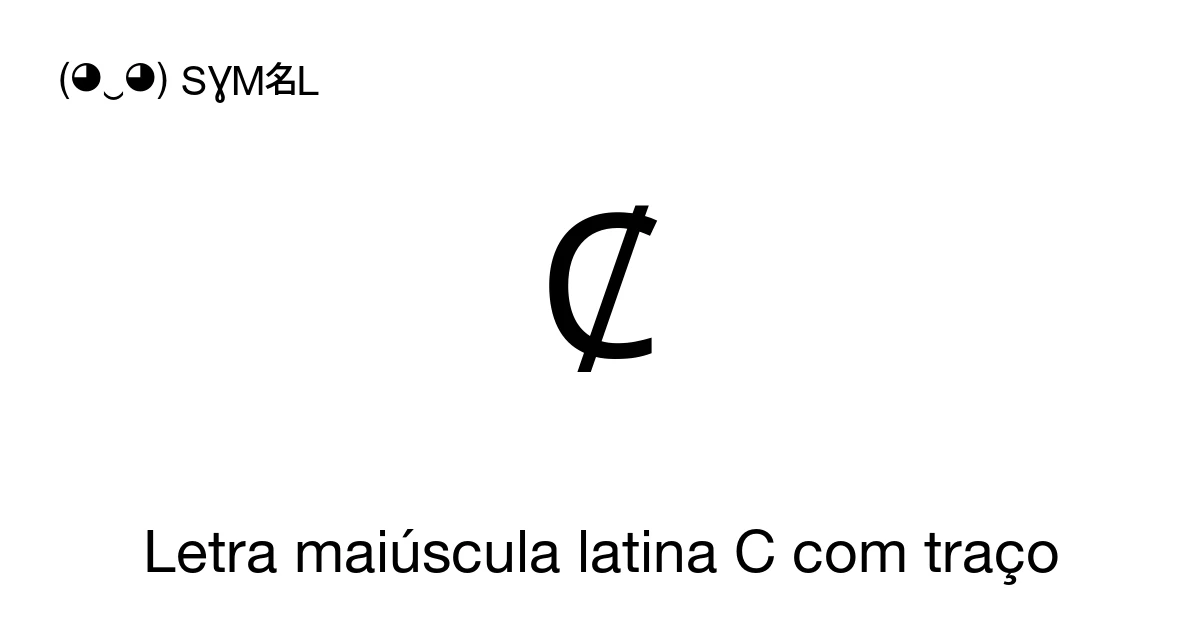
Ȼ Letra maiúscula latina C com traço (U+023B) significado do símbolo ... -

planilha de pré-escola de traço de alfabeto letra a a z com letra c ...
