Cadeia Ciclica E Acíclica

O que realmente acontece com cadeias cíclicas e acíclicas
Você já tentou construir um projeto e o compilador simplesmente travou ou o gerenciador de dependências entrou num loop infinito. A razão quase sempre é a mesma: alguma cadeia no seu grafo de dependências formou um ciclo que ninguém esperava. Entender a diferença entre cadeia ciclica e acíclica não é só teoria de grafos, é o que separa um build que funciona de um que simplesmente não resolve. Uma cadeia acíclica é um grafo onde, partindo de qualquer nó, você nunca volta ao ponto de partida seguindo as arestas direcionadas. Na prática, isso significa que existe pelo menos uma ordem linear válida para processar todos os elementos — uma topological sort existe. Cadeia cíclica, por outro lado, contém pelo menos um caminho fechado: A depende de B, B depende de C, C depende de A. Não existe ordem de execução válida. O sistema entra em contradição e precisa reportar erro ou ignorar algo.
Cadeia ciclica e acíclica: como detectar na prática
A forma mais direta de verificar se o seu grafo é acíclico é usar DFS com marcação de três estados: visitado, na pilha atual ou completamente processado. Se durante o traversal você encontrar uma aresta de retorno para um nó que ainda está na pilha atual, há um ciclo. Isso roda em tempo O(V + E), que é o melhor que dá pra fazer porque você precisa tocar todo o grafo pelo menos uma vez. Para grafos maiores, a abordagem iterativa com pilha explícita evita o estouro de stack recursivo. Eu tinha um pipeline de dados com cerca de 14 mil nós de transformação e a versão recursiva do Python caindo com RecursionError em produção. Troquei para uma implementação iterativa com uma lista de vizinhos e um dicionário de cores, e o tempo de detecção caiu de timeouts intermitentes para cerca de 3 segundos constantes. Quando o ciclo é encontrado, o algoritmo pode retornar o caminho exato que forma o loop. Isso é útil mas exige cuidado na implementação — você precisa rastrear o predecessor de cada nó visitado, não apenas marcar como visitado. Senão sabe que existe um ciclo mas não consegue dizer qual é a cadeia responsável por ele.
O problema que ninguém conta sobre dependências circulares
Aqui vai algo que eu descobri na prática e que raramente aparece em material introdutório: a maioria dos detectores de ciclo falha em identificar o problema real quando você tem módulos que se importam mutuamente mas só usam parte das funções um do outro. O ciclo existe tecnicamente, mas semanticamente pode não ser um bloqueio se as imports forem usadas de forma condicional ou em camadas diferentes do runtime. Eu perdi umas duas semanas caçando um bug de importação circular num projeto Flask com blueprints e extensões. O ciclo estava em: app.py extensions.py auth.py models.py extensions.py. O Flask não quebrou na inicialização porque o SQLAlchemy era instanciado de forma preguiçosa, mas em testes unitários tudo travava. A solução foi usar lazy imports dentro das funções que precisavam dos modelos, não no topo do arquivo. O grafo de dependência em tempo de carga continuava com ciclo, mas o grafo de dependência em tempo de execução era acíclico. Isso leva a uma distinção importante que os livros geralmente confundem: dependência estrutural versus dependência de execução. Ferramentas como o pylint ou o flake8 analisam a estrutura do código. Se o seu ciclo só aparece em cenários específicos de execução, nenhuma análise estática vai encontrá-lo. Você precisa de teste de integração ou instrumentação de runtime para capturar esses casos.

When acyclic chains actually help you
Graphs sem ciclos aparecem em todo lugar quando você pensa direito: sistemas de build (Make, Bazel), filas de tarefas (Celery workflows), esquemas de banco (foreign keys sem loops), e pipelines de dados (Airflow DAGs). A propriedade mais útil é que eles permitem ordenação topológica, que por sua vez permite processamento determinístico em uma única passagem. Se o seu grafo é acíclico e representado como matriz de adjacência, você pode fazer a ordenação topológica com o algoritmo de Kahn em O(V²). Com lista de adjacência, fica O(V + E). A diferença parece pequena no papel mas em grafos esparsos grandes — o que é comum em projetos reais — a lista de adjacência é sistematicamente mais rápida porque não processa entradas vazias. Uma armadilha comum é assumir que todo grafo de dependência no seu projeto é pequeno o suficiente para ignorar a complexidade. Eu vi gente usar ordenação por DFS recursivo em grafos com mais de 50 mil nós em JavaScript no browser. O resultado era stack overflow garantido após cerca de 8 mil níveis de profundidade. A solução foi transformar em BFS com Kahn e uma fila de nós com grau entrante zero. Processou tudo em menos de 2 segundos sem exceção.
Pontas soltas que você precisa saber
Grafos cíclicos não são sempre ruins. Em algumas situações, ciclos são a característica desejada — redes de fluxo, estados de máquinas que podem retornar a configurações anteriores, ou dependências que refletem relacionamento bidirecional legítimo. O problema não é o ciclo em si, é quando o ciclo impede algo que você precisa fazer, como determinar uma ordem de execução ou garantir terminação de um algoritmo. Se você está lidando com um grafo que tem muitos ciclos e precisa extrair uma subestrutura utilizável, uma alternativa é aplicar o algoritmo de Tarjan para encontrar os componentes fortemente conexos e colapsar cada um num único nó. O grafo resultante é necessariamente acíclico. Isso é amplamente usado em compiladores e em análise de código. O trade-off é que informações sobre a estrutura interna do ciclo são perdidas na compressão, então você precisa decidir se essa perda é aceitável para o seu caso. Outro detalhe prático: em grafos dinâmicos, onde arestas são adicionadas ou removidas frequentemente, recalcular a aciclicidade do zero a cada operação é ineficiente. Existem algoritmos incremental maintenance para detecção de ciclos, mas eles são mais complexos e raramente valem a pena salvo em contextos de alta frequência como sistemas de cache ou schedulers em tempo real. Na maioria dos casos, rodar DFS a cada rebuild é suficiente e muito mais simples de manter.
Galeria
-

A Química Orgânica: Classificação das cadeias carbônicas -
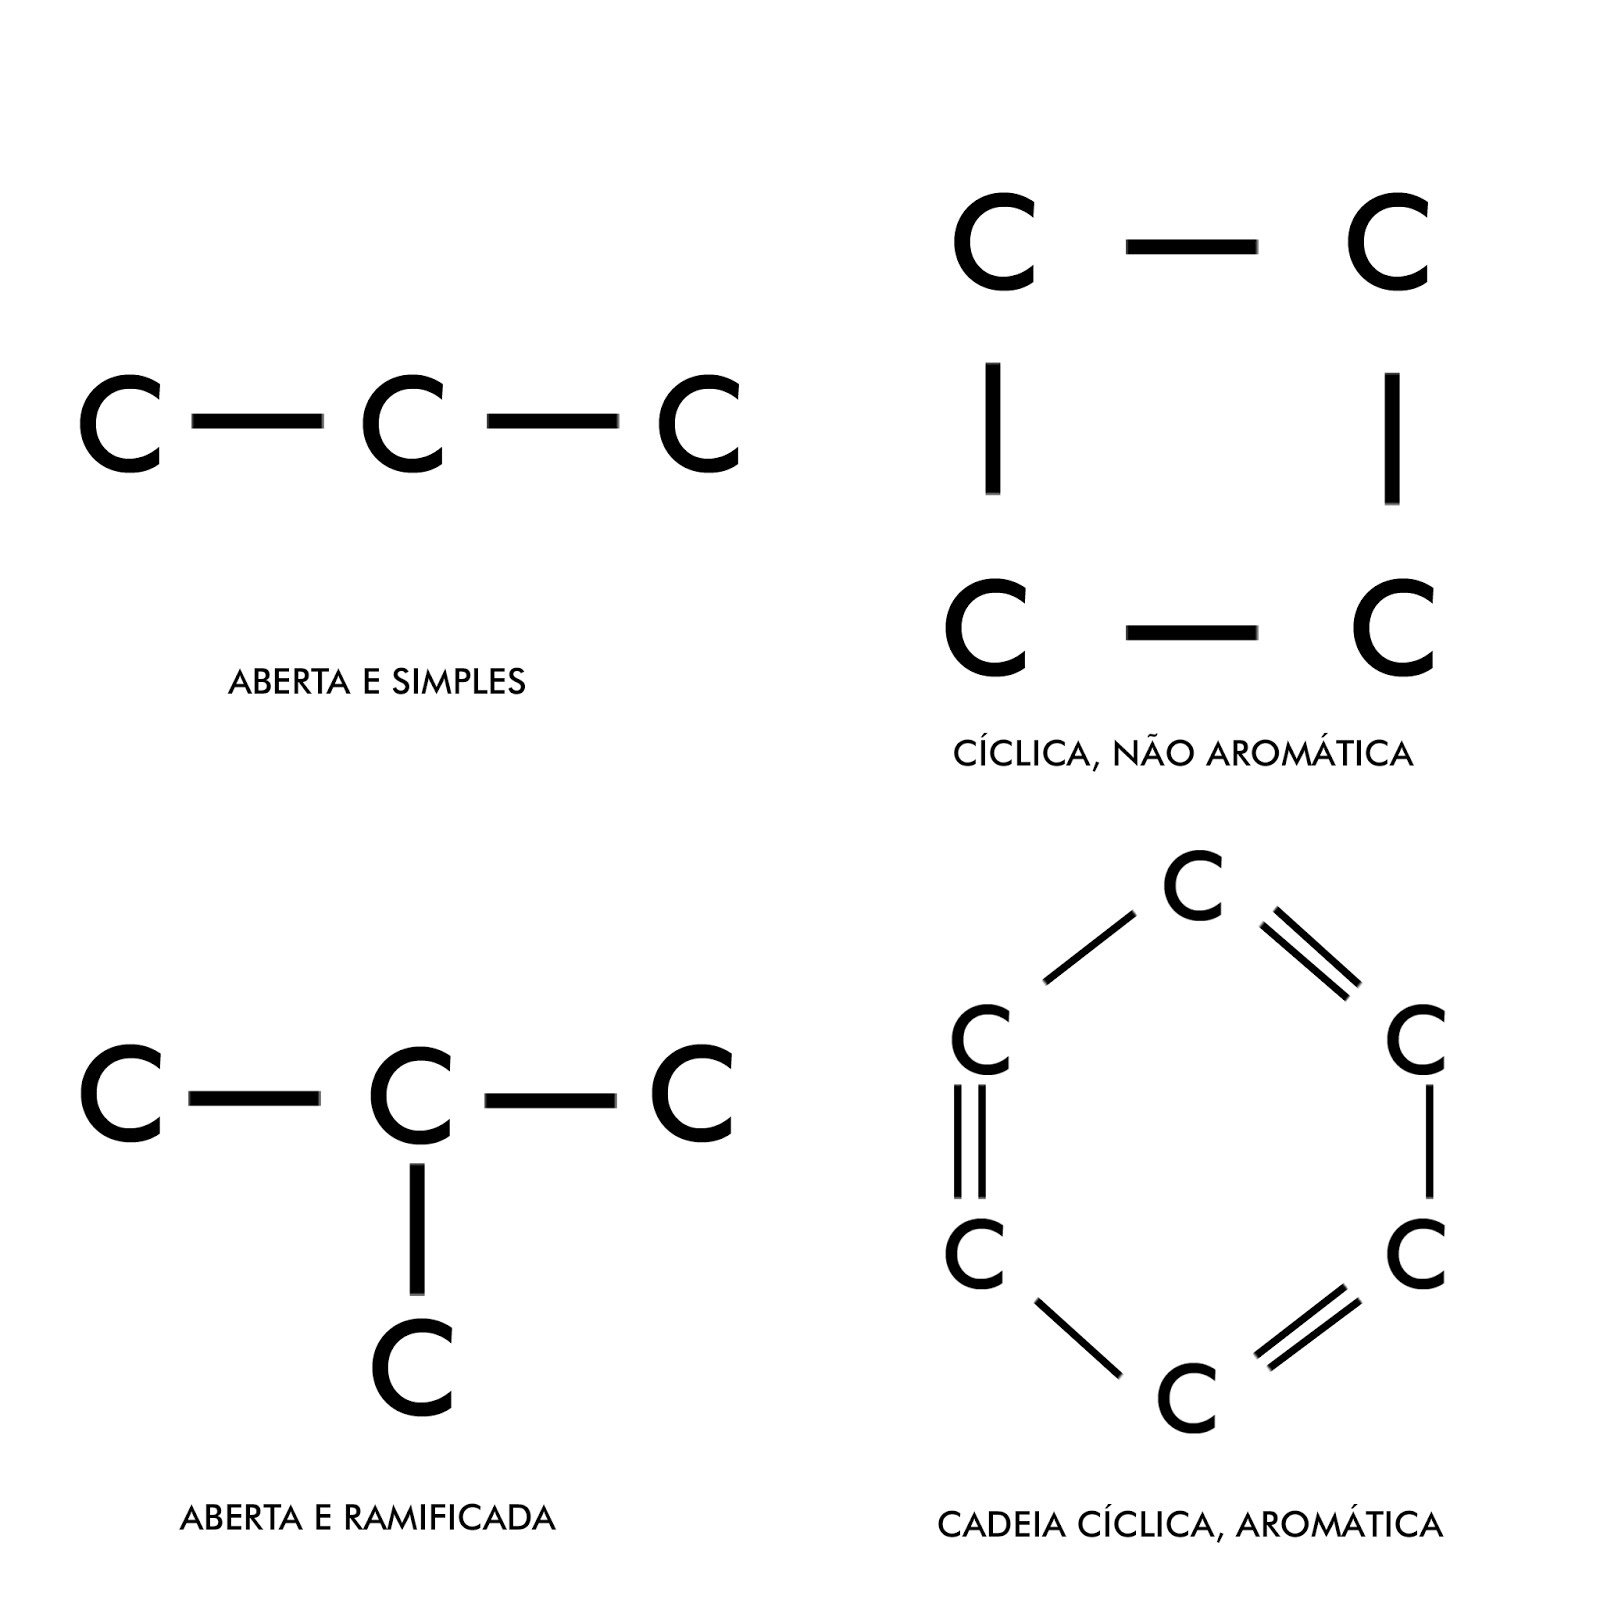
Série Química Orgânica: As Super Cadeias! -

Aprendendo quimica on-line: Cadeias Carbônicas -

Estudos das cadeias carbônicas
