Calculos De Estatistica E Probabilidade

Quando a planilha ferra seu resultado
Eu estava ajustando um modelo de regressão logística para uma equipe de marketing que queria prever conversões em um funil de vendas. O problema era simples no papel: sample size de cerca de 47 observações, variáveis categóricas com categorias muito desbalanceadas, e um dos preditores quase perfeitamente separado os grupos. O software entregou coeficientes gigantescos com erros padrão absurdos. A solução não estava em adicionar mais dados, porque o orçamento já tinha acabado. Eu usei uma correção Firth, que basicamente aplica uma penalização de Jeffreys ao verossímil. O resultado mudou de "coeficiente de 12,3 com erro de 8,7" para algo como 1,8 com erro de 0,6. Os intervalos de confiança ficaram razoáveis e o modelo passou em testes de calibração. Isso é um exemplo clássico do que acontece quando gente tenta aplicar calculos de estatistica e probabilidade sem prestar atenção nas condições de contorno. A matemática em si é direta. O problema é saber quando ela deixa de ser aplicável.
Entendendo o que realmente são calculos de estatistica e probabilidade
Estatística lida com inferência a partir de dados observados. Probabilidade lida com previsão a partir de modelos conhecidos. Os dois campos se sobrepõem, mas a direção do raciocínio é inversa. Na prática, você raramente vai precisar de uma definição formal de distribuição normal para resolver um problema do dia a dia. Você vai precisar saber quando assumir normalidade, quando não assumir, e como testar se essa suposição hold. O que a maioria das pessoas não entende é que a maior parte dos calculos de estatistica e probabilidade na vida real envolve escolher entre aproximações. Teste exato ou assintótico? Modelo linear geral ou modelo misto? Inferência frequentista ou bayesiana? Não existe resposta única. Existe resposta que funciona para o seu caso específico.
Abordagens práticas
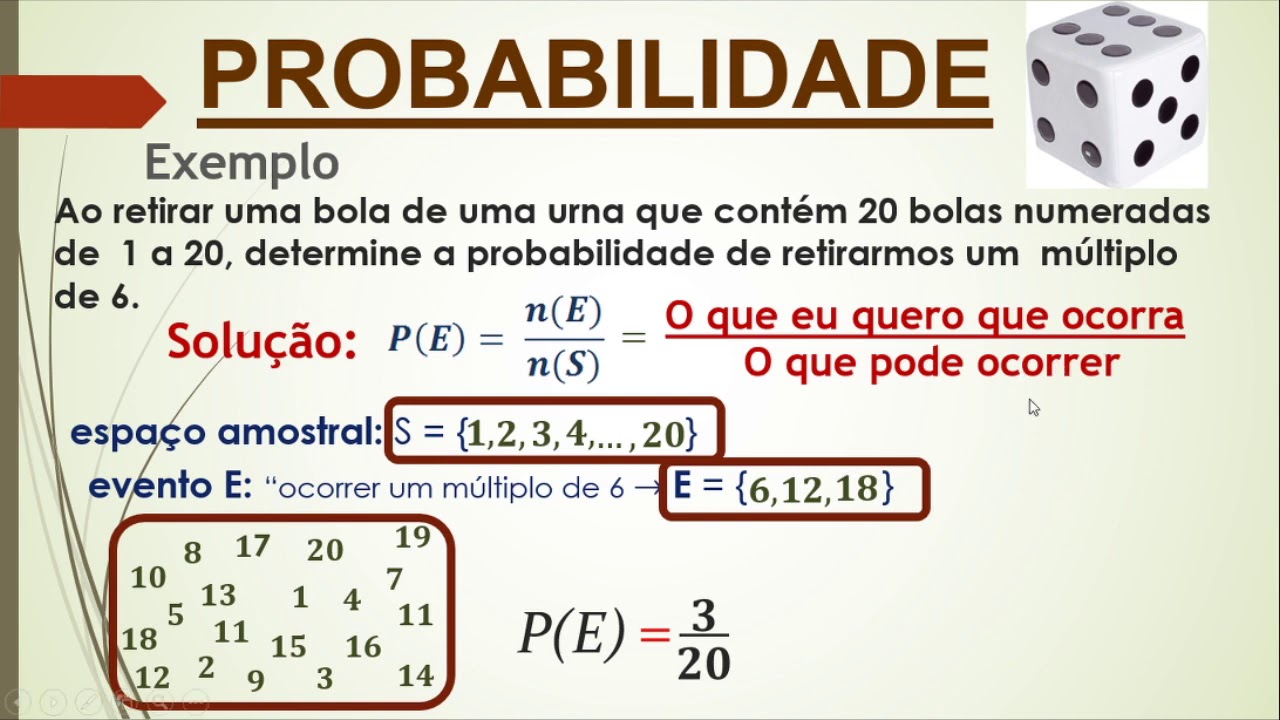
A primeira coisa que eu faria antes de qualquer calculo é verificar a estrutura dos seus dados. Distribuição das variáveis, presença de outliers, missing data mechanism, e se as suposições do método que você pretende usar são plausíveis. Muitas pessoas pulam essa etapa e vão direto para a fórmula. Vou exemplificar com um cenário comum: comparar médias de dois grupos independentes. O teste t de Student parece a escolha óbvia. Mas ele exige normalidade dentro de cada grupo e homogeneidade de variâncias. Se seus dados são discretos e pequenos, o teste t pode ter poder praticamente zero. Nesse caso, um teste exato de Fisher ou uma permutation test resolvem com muito mais precisão. A permutation test é basicamente isso: você embaralha os rótulos dos grupos milhares de vezes, recalcula a estatística de teste em cada embaralhamento, e vê quantas vezes o resultado embaralhado é tão extremo quanto o observado. O valor-p que sai daí não depende de nenhuma suposição de distribuição. Para probabilidade, o jogo é diferente. Você precisa definir o espaço amostral e as probabilidades associadas a cada evento. Em problemas reais, o espaço amostral muitas vezes é infinito ou tão complexo que você não consegue enumerá-lo. Aí entra simulação de Monte Carlo. Gera-se um número grande de cenários aleatórios a partir do modelo assumido e se observa a frequência dos eventos de interesse. É impreciso por natureza — a precisão melhora com a raiz quadrada do número de simulações — mas é muitas vezes a única saída viável.

Ferramentas que eu realmente uso
Para calculos de estatistica e probabilidade no dia a dia, eu dependo principalmente de R e Python. O R tem pacotes como lme4 para modelos mistos, brms para inferência bayesiana, e exact2x2 para testes exatos em tabelas 2x2. O Python oferece scipy.stats para testes clássicos, statsmodels para modelos mais elaborados, e PyMC para modelos bayesianos. Ambas as abordagens exigem que você saiba escrever código, o que é uma barreira para algumas pessoas, mas é exatamente o que permite controle fino sobre o que está acontecendo. Existem calculadoras online, é claro. Mas elas geralmente escondem as suposições. Você insere números e recebe um valor-p sem saber se o método foi escolhido corretamente para seus dados. Eu recomendo usar essas ferramentas apenas para exploração inicial ou conferência rápida, nunca como decisão final.
Erros que eu vejo todo dia
O erro mais frequente é confundir significância estatística com relevância prática. Um estudo com N=10.000 pode encontrar uma diferença "estatisticamente significativa" de 0,3 pontos percentuais em uma taxa de conversão. Significativo é, mas inútil na prática. O inverso também ocorre: efeitos substanciais que não atingem significância porque a amostra é pequena demais. Outro erro comum é o problema da comparação múltipla. Você testa 20 hipóteses com alfa=0,05 e espera que uma delas dê p
0,05 por acaso. A correção de Bonferroni é conservadora demais na maioria dos casos. A correção de Benjamini-Hochberg controla a taxa de descobertas falsas e é mais adequada para análises exploratórias. Para estudos confirmatórios, prefira pré-registrar suas hipóteses e ajustar o nível de significância apenas nos testes principais. Um terceiro erro recorrente é ignorar a incerteza na estimação dos parâmetros quando se faz propagação de erro. Se você tem uma média com desvio padrão e quer calcular uma função não-linear desses valores, simplesmente derivar e aplicar a fórmula de propagação do primeiro ordem pode subestimar a variância resultante. Use bootstrap paramétrico nesse caso: gera dados a partir da distribuição estimada, aplica a função em cada replicado, e observa a variabilidade empírica.
Quando os calculos de estatistica e probabilidade simplesmente não funcionam
Há situações em que nenhum método estatístico convencional resolve o problema. Dados extremamente esparsos, como eventos raros em grandes populações, podem exigir modelos hierárquicos com pooling parcial. Séries temporais com mudanças estruturais abruptas precisam de modelos de quebra de regime. Dados de rede com dependência espacial exigem técnicas como Gaussian random fields ou modelos autoregressivos espaciais. Nesses casos, o calculo em si é simples. O difícil é especificar o modelo certo e validar se ele captura a estrutura relevante dos dados. Uma limitação importante que pouca gente menciona: métodos bayesianos modernos, apesar de poderosos, dependem criticamente da especificação das priors. Se sua prior é muito informativa e errada, o posterior vai herdar esse erro. Se é muito difusa, o modelo pode não convergir ou dar resultados instáveis. Sempre faça sensibilidade analisando como o posterior muda sob diferentes escolhas de prior.

Um caminho para começar
Se você está estudando calculos de estatistica e probabilidade do zero, não comece decorando fórmulas. Comece entendendo o que cada métrica representa na prática. Saber que o intervalo de confiança de 95% significa "95% dos intervalos construídos desse modo conterão o parâmetro verdadeiro" é diferente de saber que a fórmula é média ± 1,96 × erro padrão. A primeira interpretação evita erros de leitura que cometemos frequentemente. Use datasets reais. O dataset de iris é bom para exemplos didáticos, mas não reflete a sujeira de dados reais. Procure bases como o CPS do Bureau of Labor Statistics dos EUA, dados do DATASUS no Brasil, ou open data de prefeituras. Você vai encontrar missing values, medidas inconsistentes, outliers legítimos e problemas de codificação. Resolver isso faz parte do processo. Para materiais, o livro "Statistical Rethinking" do Richard McElreath é um dos mais claros para quem quer entender modelos bayesianos de verdade. Para frequentistas, "Applied Linear Statistical Models" de Kutner et al. ainda é referência sólida. Online, o site R-bloggers e o repositório do GitHub com pacotes R têm tutoriais práticos que muitas vezes explicam melhor do que documentação oficial.
A parte mais importante é pratique com problemas reais. Um calculo de probabilidade condicional bem-feito pode salvar uma decisão de negócio. Um teste de hipótese mal aplicado pode levar a uma decisão errada com alta confiança. A diferença entre os dois costuma ser pouco mais do que prestar atenção nas suposições e nos limites do método escolhido.
Galeria
-

Estatística E Probabilidade Resumo – XWJDMB -
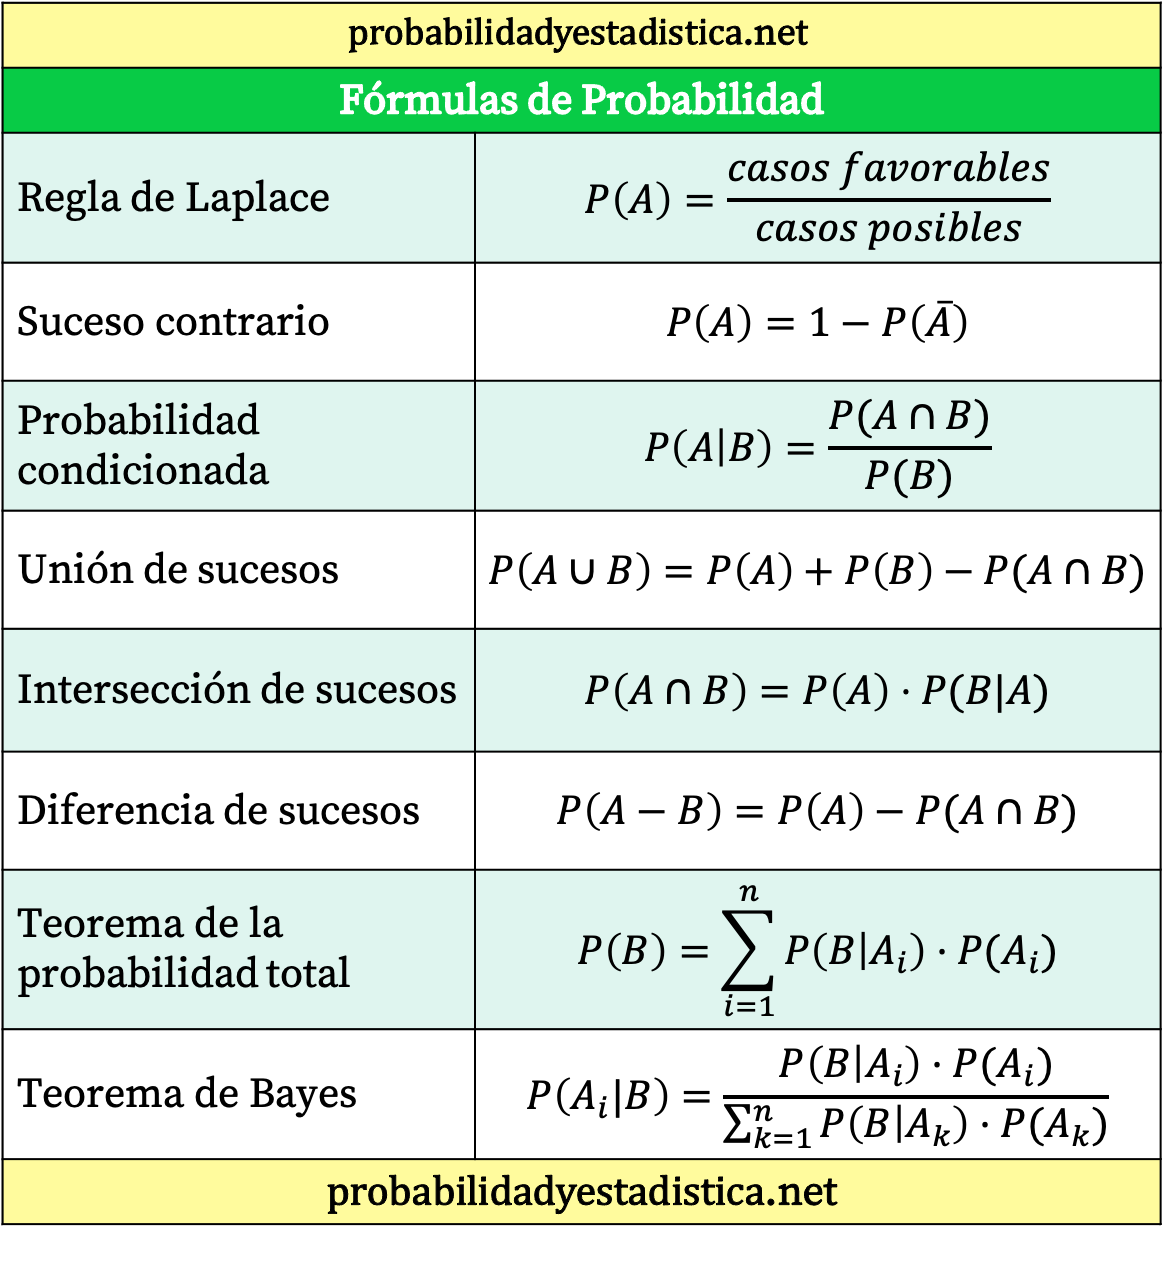
Fórmulas de probabilidade
