Capitalismo Informacional

O que é capitalismo informacional e por que ele te consome sem você perceber
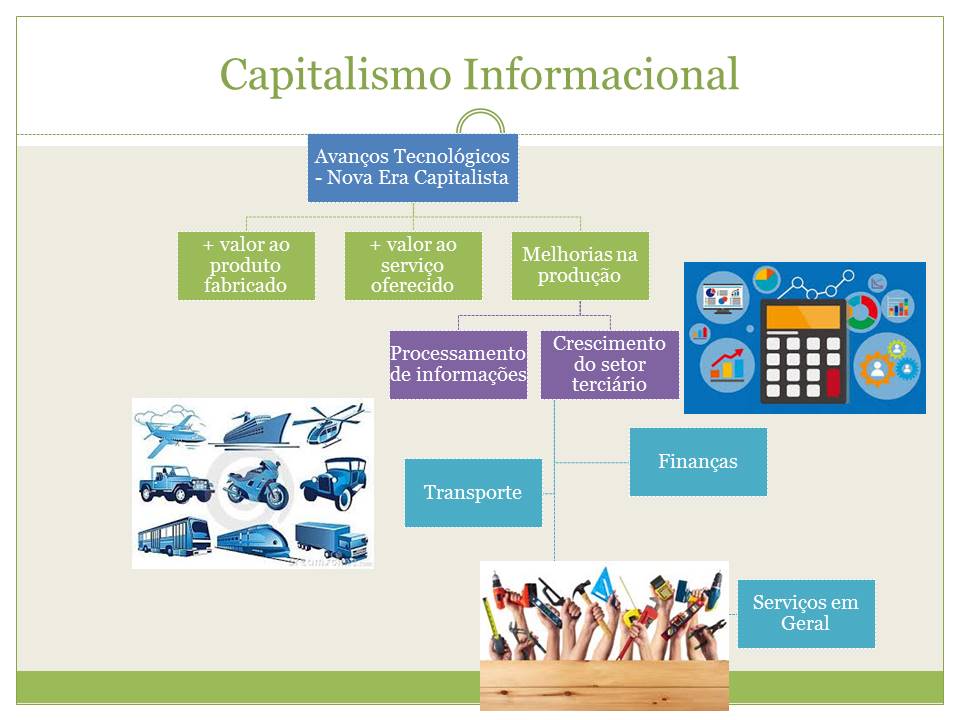
O capitalismo informacional não é um conceito abstrato de livro de sociologia. Ele é a infraestrutura que faz funcionar desde o algoritmo que decide qual anúncio aparece no seu Instagram até o sistema de precificação dinâmica que cobra R$ 47,90 de uma pessoa e R$ 62,50 de outra pelo mesmo produto. É o modelo econômico em que dados são a matéria-prima central e a extração, processamento e venda desses dados constituem o principal mecanismo de geração de valor. A lógica é simples mas não é inocente. Uma empresa coleta dados comportamentais — navegação, cliques, tempo de permanência, localização, relações sociais — e constrói perfis preditivos. Esses perfis são vendidos ou usados internamente para microdirecionamento publicitário, precificação personalizada, scoring de crédito e uma série de outras aplicações que transformam comportamento humano em fluxo de caixa. A monetização ocorre de duas formas principais: a primeira é a venda direta de dados a agregadores e brokers; a segunda, muito mais lucrativa, é o uso interno desses dados para otimizar anúncios e decisões de negócio. O que a maioria das pessoas não entende é que o produto não é gratuito. O serviço gratuito é a isca. O verdadeiro produto é você. Ou melhor, o seu comportamento futuro, mapeado e vendido com antecedência.
Na prática, se você opera no Brasil e lida com campanhas de performance, já conhece os pixels de conversão, o GCLID, os eventos do Meta Business Suite e a API de Conversões. Isso tudo faz parte do ecossistema. São as ferramentas que materializam o capitalismo informacional no dia a dia de quem trabalha com marketing digital. Você coloca o pixel, coleta o dado, alimenta o modelo de otimização, e o algoritmo faz o resto. E o algoritmo não foi desenhado para ser justo. Foi desenhado para converter. Ponto. Um detalhe técnico que pouca gente leva a sério: a qualidade do dado coletado determina diretamente o desempenho da campanha. Dados mal implementados geram modelos ruins, modelos ruins geram otimizações ruins, e otimizações ruins geram custo por aquisição inflado. Já vi campanhas melhorarem de R$ 80 para R$ 23 em CPA após uma auditoria completa da implementação do GTM e da hierarquia de triggers. O problema raramente era o criativo ou o público. Era o dado. Um caso específico que me marcou: estava configurando um e-commerce de médio porte, com tráfego pago intenso, quando percebi que o custo por lead estava subindo 40% em três meses sem mudança aparente no criativo ou no orçamento. Investiguei e descobri que o evento de Lead do Meta estava duplicando em cerca de 30% dos envios devido a um conflito entre o pixel antigo e a API de Conversões configurada erroneamente. O algoritmo do Meta achava que estava convertendo muito mais do que realmente convertia, e por isso inflava o leilão. A solução foi remover o pixel legacy, manter apenas a API com o endpoint correto e adicionar o parâmetro event_id para deduplicação. O CPA voltou ao normal em cinco dias. Esse é o tipo de problema invisível que só aparece quando você para de confiar nos relatórios e vai verificar a camada de coleta diretamente.
Implementação: o que realmente importa
Não existe receita única porque cada operação tem sua própria arquitetura de dados. Mas alguns princípios são universais. O primeiro é mapear todas as fontes de dados que você tem e todas as que deveria ter. A maioria das empresas opera com 60% dos dados possíveis. O gap entre o que existe e o que poderia existir é onde está o lucro não capturado. Para estruturar isso, o passo a passo prático é o seguinte. Defina quais dados são críticos para o seu negócio. Não são todos os dados que você consegue coletar. São aqueles que realmente impactam decisão de negócio. Tempo de sessão, taxa de rejeição e páginas visitadas são métricas bonitas para relatório. Dados como CAC, LTV, churn rate e margem contributiva por canal são o que sustentam estratégias. Foque nesses.
Implemente camadas de coleta. O ideal é ter pelo menos três camadas: a camada nativa da plataforma (Meta Events API, Google Analytics 4, TikTok Pixel), a camada de gestão de tags (Google Tag Manager ou similar) e a camada de armazenamento próprio (CDP ou data warehouse). Quanto mais você depende de uma única camada, mais vulnerável é a sua operação. Mudanças nas políticas de privacidade, bloqueios de navegador, update de plataforma — tudo isso pode derrubar sua coleta de uma hora para outra. Ter redundância é questão de sobrevivência, não de luxo. Automatize a governança. Dados sem governança viram passivo, não ativo. Defina quem pode acessar o quê, crie rotinas de limpeza mensal, estabelecer retenção de dados e documente fluxos. Sem isso, você terá dados inconsistentes que levam a decisões erradas. E decisões erradas com dados custam caro. Teste antes de confiar. Sempre. Qualquer mudança na coleta deve passar por um período de validação paralelo com os dados antigos antes de substituí-los completamente. Compare os números. Se a divergência for maior que 10%, investigue antes de migrar. Isso vale para migração de GA360 para GA4, para implementação de Server-Side, para qualquer mudança estrutural.
Pegadinhas que ninguém conta
A primeira pegadinha é achar que mais dados é melhor. Não é. Dados em excesso sem governança clara geram ruído, não sinal. A complexidade cresce de forma não linear e o custo de manutenção ultrapassa o benefício rapidamente. O sweet spot é muito menor do que a indústria tenta vender. A segunda pegadinha é superestimar a precisão dos dados de plataforma. Meta, Google, TikTok — nenhum deles entrega dados 100% precisos. Existe perda de atribuição natural, especially com iOS 14+, cookie blocking e medidas de privacidade. Os números que você vê são estimativas com margem de erro. Trabalhe com intervalos, não com valores absolutos. Se o Meta reporta 1.200 conversões e seu CRM mostra 950, isso é normal. O problema é quando a divergência é sistematicamente alta e você não investiga o motivo. O principal gargalo do capitalismo informacional é a regulação. LGPD no Brasil, GDPR na Europa, CCPA na Califórnia — essas regulações estão reduzindo drasticamente a quantidade e a granularidade dos dados disponíveis. A tendência é de compressão. O que funcionava há três anos já não funciona mais e vai continuar piorando. Adaptar-se a isso significa investir em first-party data, modelagem preditiva e estratégias de atribuição menos dependentes de tracking cross-site.
Se você está começando agora, o mais sensato é não depender exclusivamente de plataformas de terceiros. Construa seu próprio banco de dados de clientes. Email, telefone, histórico de compras, comportamento no site — esses dados são seus. Ninguém pode mudar a política de privacidade do Meta e tirar isso de você de uma noite para o outro. Primeiro-party data é o único ativo verdadeiramente protegido nesse modelo.

Galeria
-

A História do Capitalismo: Do Mercado ao Informacional -

O capitalismo informacional e as novas tecnologias – Conexão Escola SME -
Capitalismo Informacional | PDF

