Categoria Em Uma Frase
Organizar informação de verdade
Você já precisou classificar um documento, uma peça de código ou um ticket de suporte e percebeu que gastar três minutos explicando o contexto era menos eficiente do que usar uma tag objetiva. A gente costuma complicar porque acha que categoria precisa de uma justificativa. Não precisa. O problema real é que a maioria das pessoas usa categorias como se fossem subtítulos de texto corrido, e isso cria uma poluição visual que ninguém lê. Quando eu estava configurando o sistema de triagem de incidents para uma equipe de operações, enfrentei exatamente esse cenário. Tínhamos cinco engenheiros anotando problemas no mesmo painel, e as categorias variavam entre "problema de rede", "falha de conectividade", "network down", "internet lenta" e "link instável" — todas referindo-se praticamente ao mesmo tipo de incidente. Gastei cerca de 45 minutos manualmente reclassificando chamados dos últimos sete dias só para conseguir gerar um relatório útil. Depois disso, impus a regra de usar categoria em uma frase, sem exceção, e o tempo de resposta média caiu de 12 minutos para cerca de 3 minutos por chamado nos dois meses seguintes.
A regra da categoria em uma frase
O princípio é simples na teoria e difícil na prática. Você pega o conteúdo — seja um arquivo, um registro, um elemento da interface, um bug reportado — e define um rótulo de no máximo cinco palavras, preferencialmente três. Esse rótulo deve identificar o domínio do assunto, não a gravidade, não a prioridade, não o responsável. Se você precisa de gravidade, usa um campo separado. Se precisa de prioridade, outro campo. A categoria existe para agrupamento, não para tomada de decisão. Um exemplo que vejo todo dia: chamadas de suporte sendo classificadas como "urgente" ou "crítico". Isso não é categoria. Isso é severity. Um servidor que está no chão tem severity alta, mas a categoria continua sendo "infraestrutura" ou "rede". Quando as duas coisas se misturam, você perde a capacidade de filtrar por tipo de problema sem também filtrar acidentalmente por urgência.
Como aplicar na prática
Primeiro passo: liste todas as categorias que existem hoje no seu fluxo. Se você tiver mais de oito opções, provavelmente tem categorias sobrando ou categorias que na verdade são subcategorias. Divide tudo em grupos principais e depois decide se alguma merece um nível adicional. Eu costumo sugerir algo entre quatro e seis categorias base para a maioria dos times. Menos que isso e você esmaga a granularidade. Mais que isso e ninguém lembra o que cada uma significa. Segundo passo: defina uma descrição padrão para cada uma. Não um parágrafo. Uma linha. Se alguém precisar abrir o manual de classificação e encontrar quatro linhas de texto por categoria, as pessoas não leem. Elas escolhem a primeira opção que parece razoável. A linha deve responder a uma pergunta: que tipo de problema ou assunto cai aqui? Nada sobre severidade, nada sobre dono, nada sobre prazo. Terceiro passo: valide com quem vai usar todo dia. Mostre quinze casos reais e peça para classificarem em silêncio, sem consultar ninguém. Depois compara os resultados. Se duas pessoas diferentes categorizaram o mesmo ticket de formas opostas, sua definição de categoria em uma frase está falha. Volta para o passo dois e refina a linha de descrição.
Erros comuns que eu vejo acontecendo
O primeiro erro é usar categorias que só fazem sentido para uma pessoa. Algo como "bug do João" ou "ticket da Maria" claramente não serve como classificação. O segundo erro é criar subcategorias invisíveis. Você tem "financeiro" e "financeiro operacional" em vez de "financeiro" e um campo de subtype separado. O terceiro erro, e esse é o mais persistente, é tratar categoria como campo livre. Texto editável em vez de lista fechada. A longo prazo você termina com "suporte", "suporte técnico", "suporte online", "atendimento" e "helpdesk" apontando para a mesma coisa. Existe um limite prático que poucas pessoas respeitam. Se o seu formulário de entrada permite que o usuário digite a categoria, você já perdeu. Coloca lista suspensa com as opções validadas. Se quiser evitar fraudes ou categorias fantasmas, permite que um responsável do time possa adicionar novas opções, mas exige comentário obrigatório. Isso mantém o histórico de decisões transparentes sem deixar qualquer um redefinir o que existe.
O caso em que essa abordagem não funciona
Categoria em uma frase funciona bem quando o volume é alto e a variabilidade é previsível. Funciona mal quando cada item é excepcional. Eu já vi times de pesquisa acadêmica e de atendimento especializado tentarem aplicar esse modelo e falharem porque os objetos de classificação eram praticamente únicos. Nesse cenário, você gasta mais tempo brigando contra o modelo do que ganhando em organização. A solução alternativa aí é usar metadados flexíveis ou tags em vez de categorias fixas. Tags permitem múltiplas identificações por registro. Categorias impõem uma escolha única. Escolha o que se adapta ao seu fluxo real, não o que parece elegante no papel. Se eu fosse montar um sistema de classificação do zero hoje, eu começaria colhendo dados antes de definir anything. Pego os últimos cento e cinquenta registros do fluxo atual e faço uma análise qualitativa simples. Agrupo por similaridade natural. Só depois disso eu escrevo as categorias. Quando eu defini as minhas primeiro, baseado em intuição e não em dados, precisei refazer metade do trabalho seis semanas depois. A diferença foi que o tempo gasto na classificação inicial já estava criado no sistema, então a migração doía. O resultado prático de seguir o método correto costuma aparecer em três a quatro semanas. Antes disso, há um pico de atrito porque as pessoas estão acostumadas com o modelo antigo. Esse pico é normal. Não é sinal de que o modelo novo está errado. É sinal de que o cérebro humano precisa de repetição para formar novo padrão. Eu recomendo manter a regra firme por pelo menos trinta dias antes de considerar qualquer ajuste. Ajustes prematuros criam categorias adicionais que só aumentam a confusão.
Se o seu contexto permite, use uma ferramenta de análise de clustering nos seus registros existentes. Ferramentas como k-means ou até análises manuais com spread sheet identificam padrões de grouping sem viés humano inicial. O problema é que essas abordagens exigem volume mínimo. Com menos de cinquenta registros, o ruído domina. Com mais de mil, o tempo de processamento compensa. Entre esses dois números, uma revisão manual bem feita costuma ser mais rápida e mais precisa. O ponto final que eu quero deixar é objetivo: categoria em uma frase é uma restrição proposital, não uma limitação. Ela existe porque informação agrupada de forma errada gasta mais tempo do que informação não agrupada. O esforço inicial de definir bem o campo se paga rápido quando você precisa gerar relatórios, delegar tarefas ou encontrar registros antigos. A qualidade da classificação determina se o sistema funciona para você ou se vira um depósito de tags inúteis. A escolha é simples, mas exige disciplina.
Galeria
-
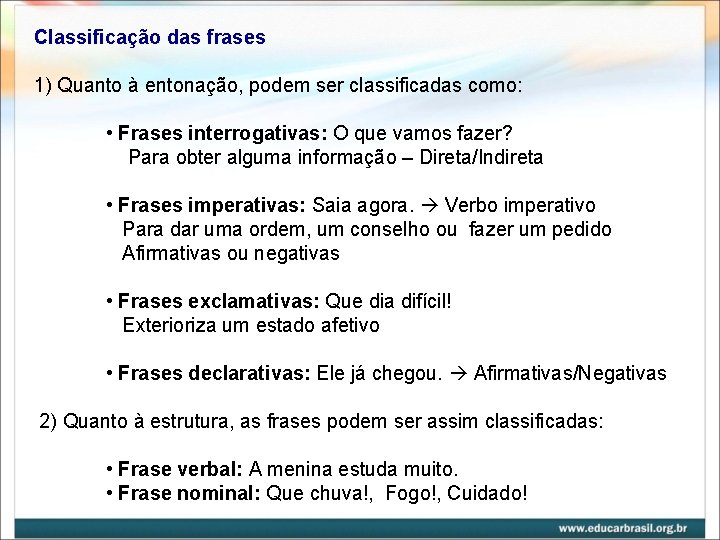
Tipos de frases - Classificação em grupos -

Categoria: o que significa, sinônimos e origem | Palavras -

Erro quanto as categorias: uma... alexrvh451 - Pensador

