Chave Tem Quantos Fonemas

Divisão de letras e sons em português
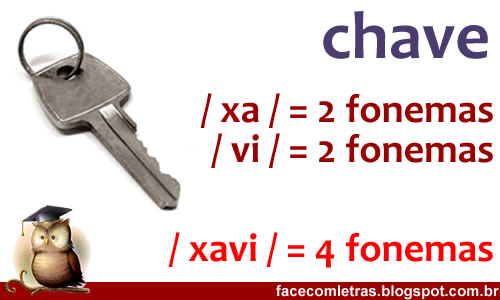
Quem trabalha com fonética ou precisa processar texto automaticamente logo se depara com uma armadilha simples: a gente confunde grafia com fala. Letras não são iguais a fonemas. Um dígrafo como "ch" ocupa duas posições no papel mas emite um único som. A palavra chave tem 4 fonemas. Eles são: // (proveniente do dígrafo "ch"), /a/, /v/ e /i/ (representado pela letra "e" mudo, que em português padrão funciona como vogal semieaberta ou i close). Se você estiver num contexto mais estritamente escolar e considerar a variação dialectal onde o "e" final soa mais como [i], a contagem continua sendo 4 fonemas. O importante é separar letra de fonema. "Chave" tem 5 letras, mas o dígrafo "ch" conta como um só fonema, reduzindo o total para 4. É um erro comum contar 5 fonemas porque a pessoa faz correspondência letra por letra.
Como contar fonemas na prática
Na minha experiência com ferramentas de processamento fonético e transcrição, o fluxo mais rápido que funciona é: 1) Escreva a palavra normalizada. 2) Identifique dígrafos conhecidos: ch, lh, nh, rr, ss, sc, sç, xc. Cada um vale 1 fonema. 3) Transforme em sequência fonêmica usando notação IPA ou equivalente. 4) Conte os elementos da sequência. Um detalhe que muita gente esquece: o "x" pode ser // ou /ks/. O "s" entre vogais vira /z/ em muitos dialectos. Contar fonemas exige saber a pronúncia-alvo, não apenas a ortografia.
Problema real que eu encontrei
Num projeto de normalização de transcrições para treinamento de TTS, eu tinha uma lista com centenas de palavras e precisei auditar a contagem fonêmica de "chave" e variações. O bug veio de um script que tratava "ch" como dois fonemas separados (/k/ + //). O resultado era uma contagem inflada e sincronia de áudio fora do lugar. A correção foi criar uma tabela de equivalência com dígrafos antes de chamar o contador, substituindo cada par por um token único durante a contagem. Depois disso, a pipeline rodou estável. Se você for automatizar isso, o fix básico é simples: normalização ortográfica reconhecimento de dígrafos tokenização fonêmica contagem. Leva cerca de 10 a 20 minutos para implementar num script pequeno, se você já tiver a tabela de dígrafos pronta.

Armadilhas comuns
A primeira é transformar tudo em letra. A segunda é ignorar variantes dialectais — em algumas falas do interior paulista ou de Minas, o "e" final pode terrealização mais aberta, o que não muda a contagem em português padrão, mas muda em transcrições fonéticas estreitas. A terceira é tratar hiatos como ditongos; em "chave" não tem hiato, mas em palavras como "saúde" a diferença importa. Contagem manual ou baseada em regras simples falha em empréstimos recentes e em grafias irregulares. Por exemplo, "xuxu" ou "xenque" podem gerar dúvidas sobre a realização de "x". Nesses casos, o ideal é consultar um dicionário fonêmico ou usar uma ferramenta com base de dados de pronúncia, em vez de depender só da regra do dígrafo. Resumo prático: para "chave", a resposta é 4 fonemas. // + /a/ + /v/ + /i/. Conte dígrafos como unidade. Verifique a variante dialetal se o contexto exigir precisão fonética estreita.
Referência rápida para autodiagnóstico
Se precisar verificar outras palavras, use este critério: transforme a palavra em IPA, identifique os segmentos fonêmicos únicos, conte-os. Para "chave", IPA padrão brasileiro: [a.ve] ou [a.vi]. Segmentos: , a, v, i 4 fonemas.
Galeria
-

Molhado Tem Quantos Fonemas - NAZAEDU -

Cabeça Tem Quantos Fonemas - FDPLEARN -

Chapeu Tem Quantos Fonemas - RETOEDU -
Face com Letras: [Aula 002] Fonologia: identificando os fonemas
