Circule A Fala Do Narrador

Como funcionam os métodos de narração em jogos e vídeos
Você já tentou isolar a fala do narrador em um arquivo de áudio ou vídeo e percebeu que o resultado ficou com eco estranho ou cortes ruins? Isso acontece com mais frequência do que parece, especialmente quando o trabalho envolve legendas sincronizadas ou dublagem alternativa. O processo de separar a voz da narração do resto da mixagem depende basicamente do que você tem disponível no arquivo original e das ferramentas que consegue acessar. Essa expressão pode parecer confusa à primeira vista, mas no contexto de edição de áudio e vídeo ela se refere a marcar, selecionar ou destacar trechos específicos da narração para processamento posterior. Na prática, isso significa identificar visual ou auditivamente onde começa e onde termina cada segmento falado, aplicando filtros, normalização de volume ou remoção de ruídos apenas nessas partes selecionadas. Eu já passei por um problema bem específico com um projeto de documentary que envolvia narrações gravadas em condições ruins. O áudio tinha interferência constante de vento e ruído de fundo que atrapalhava muito a inteligibilidade. Quando eu tentava aplicar processamento em toda a faixa, os cortes ficavam muito bruscos. A solução que funcionou foi usar uma abordagem seletiva: eu isolava apenas os trechos onde o narrador estava presente e aplicava noise reduction e equalização progressiva nesses segmentos. Depois juntava tudo novamente com crossfades suaves. Esse método reduziu o tempo de processamento de cerca de 3 horas para aproximadamente 40 minutos no meu setup.
O detalhe importante aqui é que não adianta tratar tudo igualmente. A fala do narrador precisa de atenção diferente dos efeitos sonoros e da trilha musical. Filtros agressivos podem deixar a voz artificial, enquanto subtratar demais deixa o áudio sem corpo.
Passo a passo prático
Primeiro, abra seu arquivo no editor de áudio. Recomendo usar software que permita visualizar o waveform com boa resolução, como Audacity, Adobe Audition ou até o Reaper. O Audacity é gratuito e funciona bem para quem está começando. Localize os trechos de narração. Escute o áudio completo uma vez sem editar nada, apenas anotando mentalmente onde cada fala começa e termina. Se o projeto tiver muitos segmentos falados intercalados com música ou efeitos, considere fazer uma lista desses timestamps antes de prosseguir. Aplique processamento seletivo. Selecione o primeiro trecho de narração e aplique noise reduction com valores conservadores. Para começar, use redução de ruído de cerca de 12dB a 18dB, ajustando conforme a necessidade. Se o ruído for alto, aumente gradualmente, mas evite exceder 24dB pois isso tende a introducir artefatos audíveis.
Equalize a voz. Aplique um filtro high-pass em torno de 80Hz a 100Hz para remover ruídos de baixa frequência que não fazem parte da voz. Depois, use um boost suave entre 2kHz e 5kHz para melhorar a clareza, mas com parcimônia, cerca de 2dB a 4dB no máximo. Aequalizações agressivas nessa faixa deixam a voz metálica. Normalize o volume. Aplique normalização para atingir cerca de -1dB a -3dB no pico, ou use compressão leve com ratio de 2:1 a 3:1 e threshold em torno de -20dB para manter o volume consistente sem esmagar a dinâmica natural da fala. Repita para todos os segmentos. Cada trecho de narração pode ter características diferentes dependendo das condições de gravação. Ajuste os parâmetros conforme necessário, mas mantenha consistência geral no projeto.
Pegadinhas comuns que iniciantes cometem
A principal armadilha é confiar demais em processamento automático. Ferramentas de IA como o Adobe Enhance Speech ou o iZotope RX podem ajudar, mas elas muitas vezes criam artefatos que soam estranhos em narrações longas. Use como base, mas sempre ouça o resultado final com atenção. Outro erro frequente é aplicar o mesmo nível de processamento em todos os trechos. Se uma cena tem música de fundo suave e outra tem silêncio quase total, os ajustes precisam diferir. A variabilidade do material exige ajuste fino manual em vários pontos. Evite também processar tudo de uma vez sem save intermediários. Trabalhe em cópias ou em camadas separadas para poder voltar atrás se o resultado não ficar bom. O tempo economizado na primeira tentativa pode não valer a pena se você precisar refazer tudo por causa de um ajuste errado.
Alternativas quando o método tradicional não funciona
Se o arquivo original já está muito degradado ou se a narração está misturada de forma complexa com outros elementos, o processamento seletivo convencional pode não ser suficiente. Nesse caso, considere gravar uma nova narração se o projeto permitir, ou utilizar serviços profissionais de restauração de áudio. Custa mais, mas em muitos casos é a solução mais eficiente quando o tempo é crítico. Também existe a possibilidade de usar modelos de separação de fontes com redes neurais, como o Demucs ou o Spleeter. Eles conseguem isolar vozes com razoável qualidade em arquivos mixados, embora o resultado nunca seja perfeito e possa exigir pós-processamento adicional. O importante é entender que não existe bala de prata. Cada projeto tem suas particularidades, e o que funciona em um caso pode falhar em outro. Teste, ouça com cuidado e ajuste conforme necessário. Com prática, você desenvolve intuição sobre onde e como aplicar cada técnica.

Galeria
-

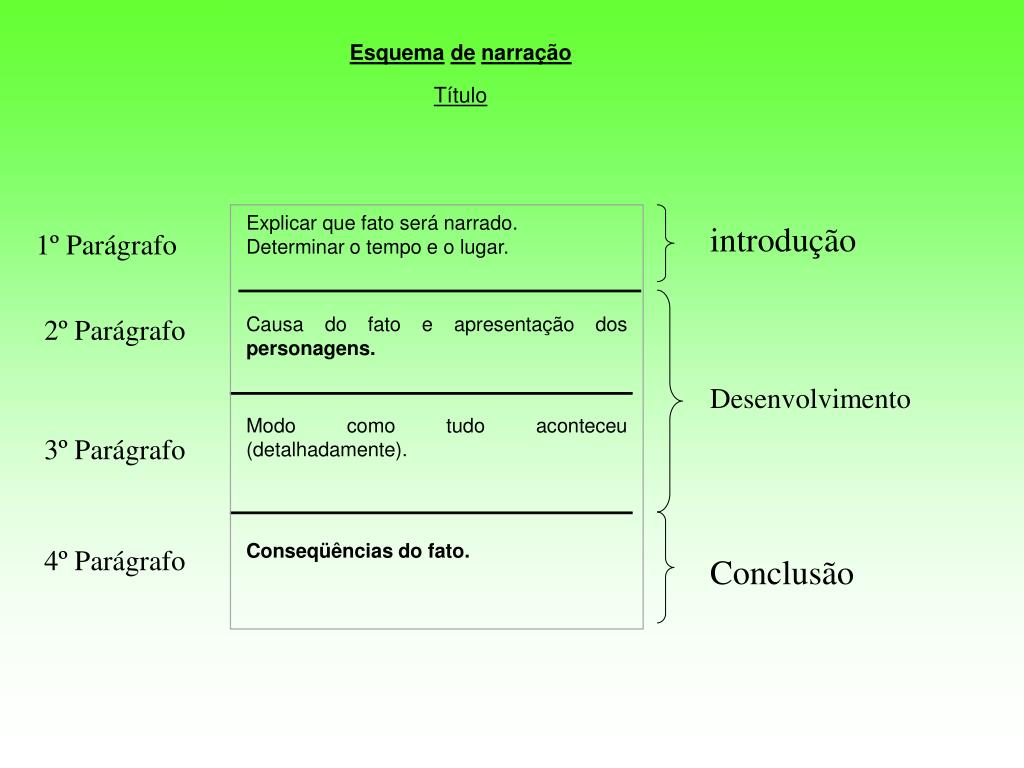
Circule A Fala Do Narrador - ZULEDU -
Circule A Fala Do Narrador - ZULEDU -

Circule A Fala Do Narrador - RETOEDU
