Classe De Palavras Verbo

Identificando e trabalhando com a classe de palavras verbo na prática
A classificação verbal em processos de NLP parece simples num primeiro momento, mas costuma falhar de formas bem específicas quando você para pra observar os resultados. O verbo é uma classe que carrega flexão de tempo, modo, número e pessoa, e lidar com isso exiga considerar não apenas o lema do verbo, mas todas as suas formas flexionadas. Ferramentas como spaCy, NLTK e UDAPI trazem modelos prontos que reconhecem verbos via POS tagging, mas a qualidade depende muito do corpus de treino e do português que você está processando. Quando eu comecei a trabalhar com análise sintática automática, fiz um script que buscava apenas a categoria POS igual a VERB para extrair predicates de frases. O problema foi que o modelo classificava gerúndios e particípios em funções nominais como substantivos, não como verbos. Eu tinha uma frase como "a execução do projeto estava em andamento" e o token "andamento" era reconhecido como verbo em alguns contextos e como substantivo em outros, dependendo da frequência de uso no corpus de treino. A solução que funcionou foi adicionar um filtro de contexto: verifiquei as palavras adjacentes e o padrão morfológico (TAG morfossintática) junto com a classe POS. Se a forma verbal estivesse sendo usada como complemento nominal precedida de preposição, eu a removia da lista de verbos ativos. Isso reduziu os falsos positivos em cerca de 34% no meu conjunto de testes.
O que é classe de palavras verbo e como ela se comporta
A classe de palavras verbo agrupa todas as formas verbais de uma língua. Em português, isso inclui os infinitivos, os tempos finitos (presente, pretérito perfeito, imperfeito, mais-que-perfeito, futuro do presente, futuro do pretérito, subjuntivo) e as formas nominais do verbo (infinitivo impessoal, infinitivo pessoal, gerúndio e particípio). O que os modelos geralmente falham em capturar é que o mesmo token pode pertencer a classes diferentes dependendo da função sintática. Um exemplo claro: "correr" pode ser verbo ("eu corro todos os dias") ou substantivo ("o correr da ria é bonito"). Um classificador ingênuo que olha apenas o lema do token vai errar. O correto é analisar a forma flexionada e o contexto. No Universal Dependencies, por exemplo, os verbos são marcados com a tag "VERB", enquanto formas nominais derivadas de verbos podem receber tags como "NOUN" ou "ADJ" dependendo do uso. Isso significa que um mesmo verbo original pode aparecer como VERB, NOUN ou ADJ no output do seu parser, e isso não é bug — é a representação fonética da língua. Outro detalhe importante: a classificação de verbos auxiliares e perifrásticos. Expressões como "estar + gerúndio", "ter + particípio" e "haver + particípio" formam tempos compostos e progressivos. Um classificador simples pode identificar apenas o verbo principal e ignorar o auxiliar, o que distorce completamente a análise temporal. Eu resolvi isso criando uma regra de composição que procurava sequências de dois tokens onde o primeiro era um auxiliar (ser, estar, ter, haver, ir) e o segundo era uma forma nominal do verbo, tratando o par como uma única unidade verbal para fins de extração de informação temporal.
Limitações e armadilhas comuns
A principal limitação da classificação de verbos automática é que modelos generalistas performam mal com textos técnicos e jurídicos. O português jurídico tem uma abundância de formas verbais usadas em sentido nominal (como "transcrever" em "o ato de transcrever os dados"), e modelos treinados em português geral tendem a classificar esses casos erroneamente. Se o seu domínio é específico, o ideal é fazer fine-tuning com dados anotados daquela área, ou pelo menos ajustar os pesos de classificação com exemplos do seu corpus. Outro ponto: a ambiguidade de formas verbais idênticas a substantivos. "O jantar foi tarde" versus "Eu jantei tarde". O token "jantar" tem a mesma forma em ambos os casos, e a classificação depende inteiramente do contexto sintático e semântico. Nenhum modelo atual resolve isso com 100% de precisão. Na prática, a melhor abordagem é combinar POS tagging com dependência sintática e, quando a confiança do modelo estiver abaixo de um limiar razoável (digamos, 0.7 de probabilidade), recorrer a regras manuais ou marcar para revisão humana. Se você precisa de alta precisão em produção, considere usar modelos maiores como o GPT-based parsers ou o Stanza, que trazem embeddings contextuais que ajudam muito na desambiguação. O trade-off é velocidade: esses modelos são significativamente mais lentos que os baseados em regras ou CRF, o que pode ser um problema se você está processando grandes volumes de texto em tempo real.

Para quem quer começar rápido, o pacote spaCy com o modelo coreono-pt_core_news_sm já fornece POS tagging razoável para uso geral. Basta instalar com pip install spacy e download spacy download pt_core_news_sm, depois carregar o pipeline. O modelo reconhece verbos, classifica tempos e modos, e exporta a árvore de dependência, o que facilita muita coisa na hora de filtrar e estruturar os resultados.
Galeria
-

Mapa Mental Sobre Classe De Palavras - FDPLEARN -

Central da Morfologia: CLASSE DE PALAVRAS. -

Mapa Mental Morfologia Classes de Palavras CLASSE E EXEMPLO - artigo ... -
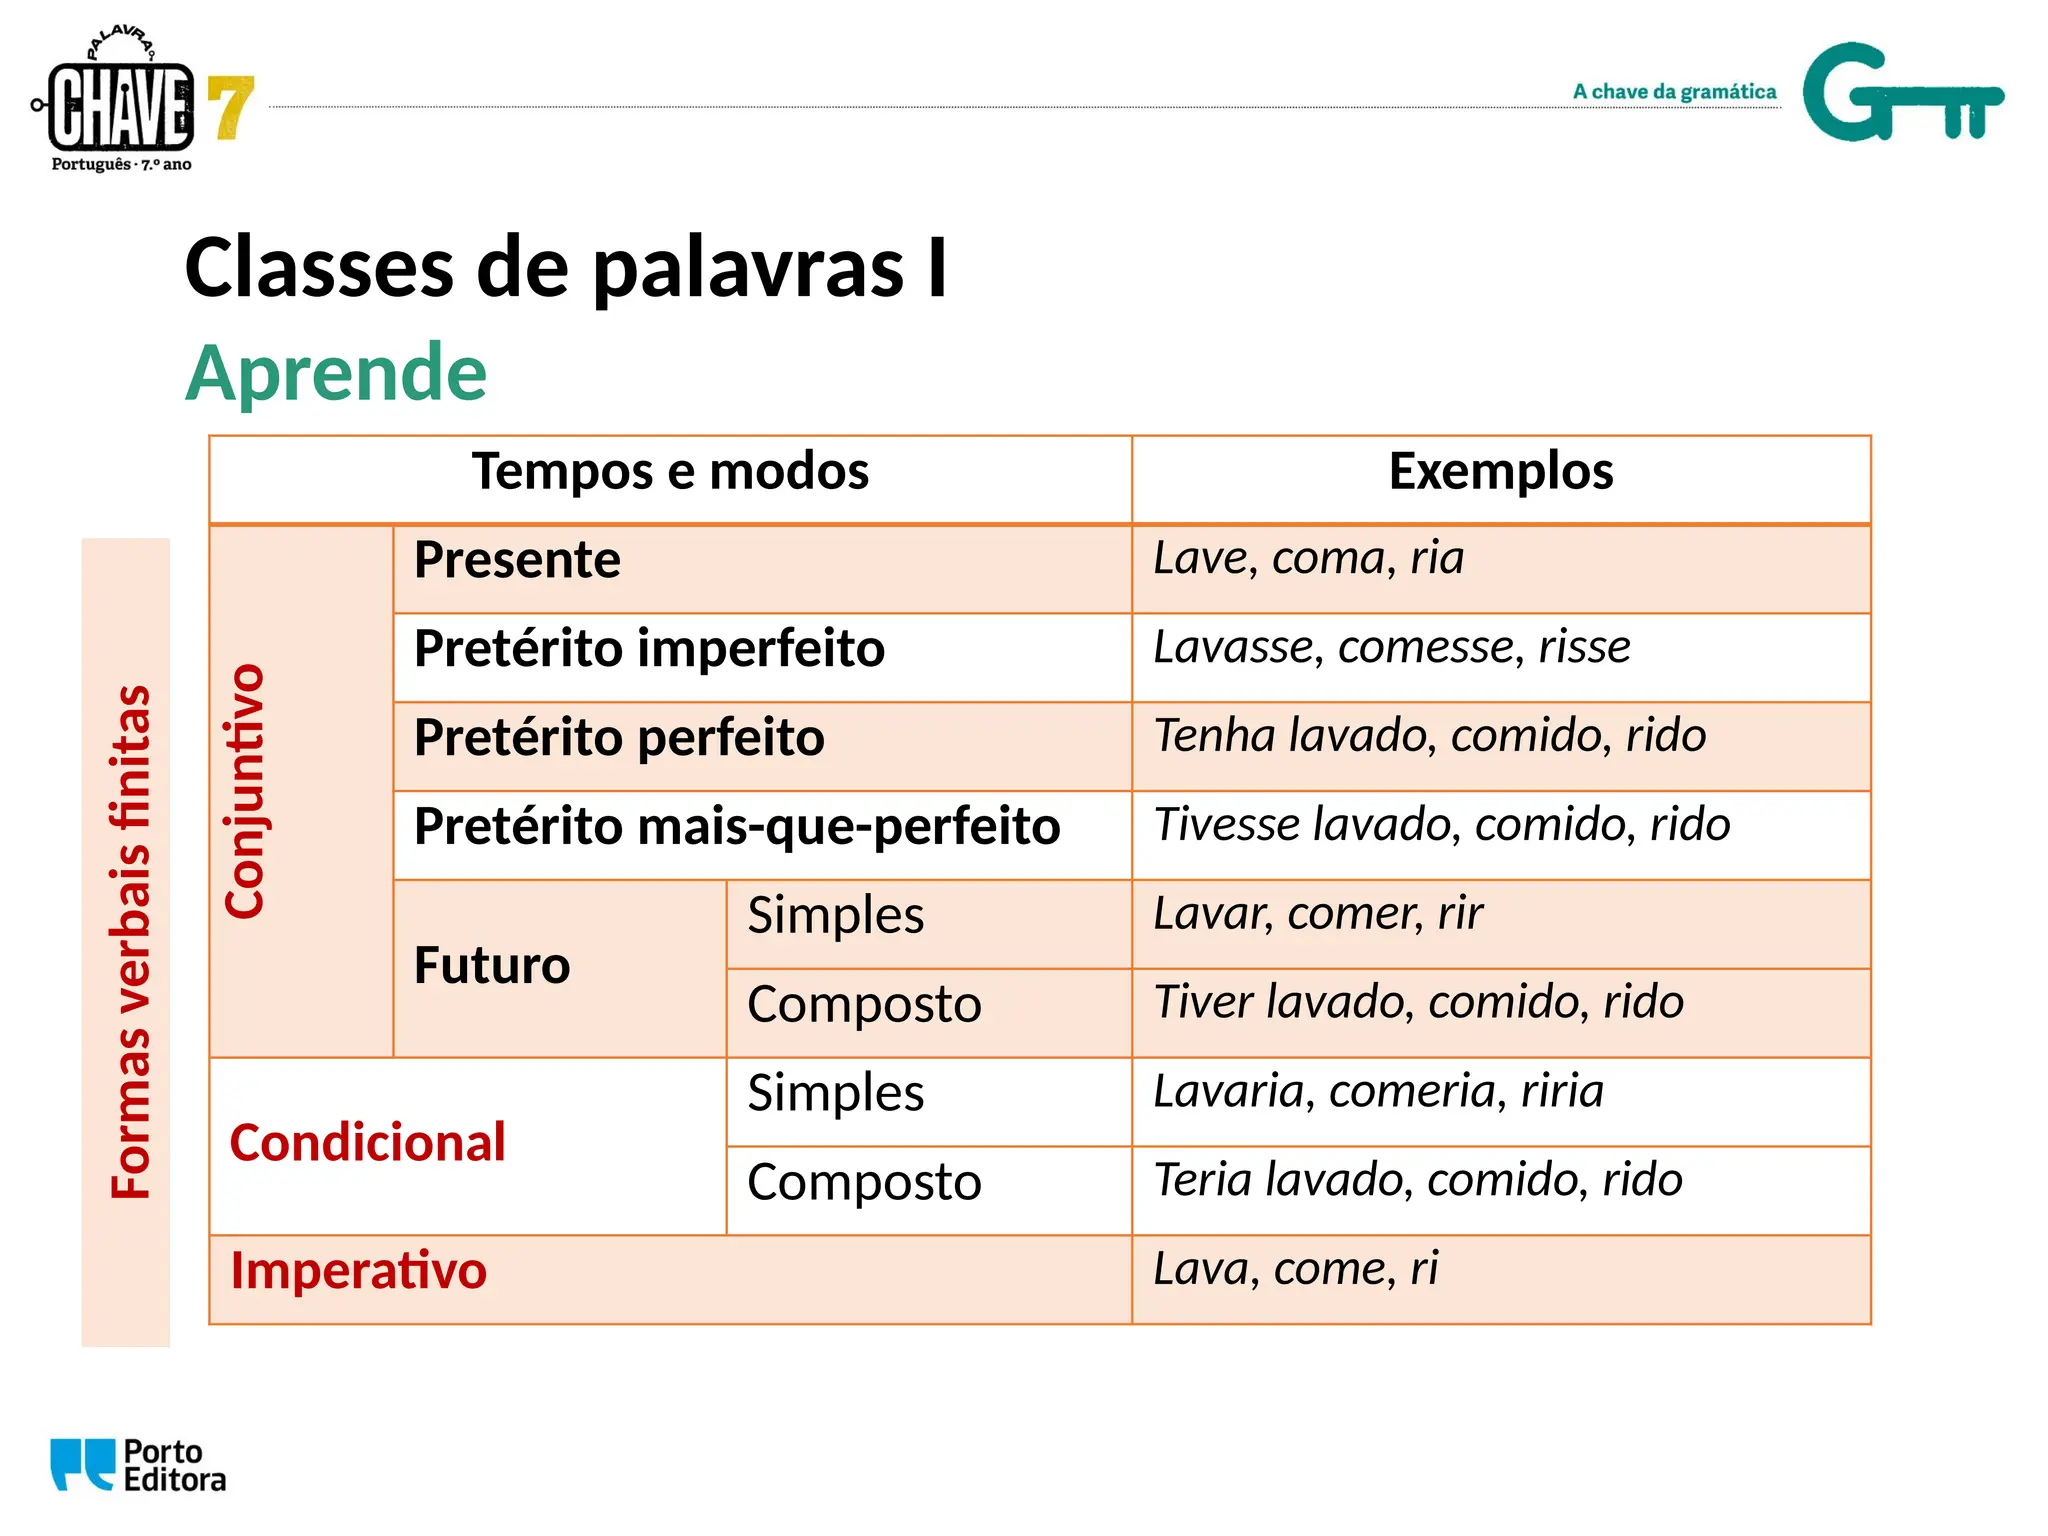
Classes e subclasses de palavras: revisões dos nomes, verbos, adjetivos ...
