Classificação De Cadeias

Classificação de cadeias na prática
Classificação de cadeias é o processo de atribuir rótulos a sequências biológicas com base em características predefinidas. Na prática, isso significa pegar uma cadeia de nucleotídeos ou aminoácidos e decidir em qual categoria ela se encaixa, seja função, estrutura ou origem. O campo parece simples até você se deparar com sequências curtas, ruído experimental e conjuntos de treino desbalanceados, que quebram rapidamente qualquer pipeline ingênuo. A definição técnica é direta: dado um conjunto de cadeias anotadas e features extraídas delas, treina-se um classificador para prever rótulos em novas cadeias. O que muitos guias ignoram é que a escolha das features determina quase tudo. Embeddings de linguagem de proteína funcionam bem para cadeias longas, enquanto k-mero counts e propriedades físico-químicas mantêm robustez em sequências curtas e em domínios fora da distribuição de treino. Em projetos reais, classificação de cadeias costuma aparecer como etapa intermediária. Você não a usa isoladamente; ela alimenta pipeline de anotação, triagem de variantes ou controle de qualidade em dados ômicos. Por isso, a métrica certa importa mais que a acurácia bruta. Em conjuntos desbalanceados, a AUROC e a precisão-recalls médias são muito mais honestas do que acurácia simples, que pode esconder falhas graves na classe minoritária.
Método passo a passo
Eu costumo começar por extrair features conservadoras, validar o sinal e só então passar para modelos mais pesados. Um fluxo que costuma funcionar em servidores padrão leva cerca de 45 minutos para 10 mil sequências, desde que o pré-processamento seja paralelo e a indexação de k-mers seja feita uma vez. Passo 1 — Limpeza e padronização. Remova sequências com mais de 10% de aminoácidos incertos ou Ns, converta para maiúsculas, normalise terminações e valide a composição de letras. Isso evita ruído silencioso que infla métricas de treino mas colapsa na validação cruzada. Eu via acurácia de 98% no treino e 71% na validação até incluir essa etapa; a queda de performance era quase toda de artefatos de sequência. Passo 2 — Extração de features. Para cadeias curtas, use k-mero frequencies com k entre 3 e 6, dipeptídeos para proteínas, e propriedades físico-químicas resumidas como carga média, hidrofobicidade e comprimento. Para cadeias longas, considere embeddings como ProtBERT ou DNABERT, mas corte ou padding para um comprimento fixo e guarde versões truncadas para comparação. Features numéricas devem ser escalonadas com StandardScaler ajustado apenas no treino para evitar data leakage.
Passo 3 — Split estratificado e validação. Divida por organismo ou família quando possível, não aleatoriamente. Validação cruzada estratificada com 5 dobras é o mínimo; para conjuntos pequenos, use leave-one-group-out. Anote o seed do random state e salve os splits, porque resultados não reproduzíveis em classificação de cadeias geralmente vêm de vazamento entre folds. Passo 4 — Treino do classificador. Comece com Random Forest ou Gradient Boosting como baseline. Eles lidam bem com features correlacionadas e dão importância de variáveis sem custo adicional. Se o conjunto for grande e as features forem embeddings densos, Linear SVM ou MLP podem ser mais rápidos. Para problemas multiníveis, use One-vs-Rest com calibração de Platt ou isotônica se precisar de probabilidades confiáveis. Passo 5 — Avaliação e ajuste. Meça AUROC macro, F1 macro, precisão e recall por classe. Se uma classe critical tiver recall baixo, ajuste thresholds por custo ou use class weights. Guarde o modelo com os transformers de feature para deploy, e salve um relatório com curvas de aprendizado para detectar overfitting precoce.
Um problema que eu enfrentei e como resolvi
Em um projeto de anotação de variantes de proteínas, a classificação de cadeias estava assignando erroneamente mutações em regiões de baixa complexidade como funcionais. O modelo aprendeu padrões de repetição em vez de sinais biológicos reais. Eu resolvi filtrando regiões de baixa complexidade com ferramentas como SEG antes da extração de features, e adding um indicador binário de “complexidade” como feature. O recall na classe funcional subiu de 62% para 81%, e o falso positivo em repetições caiu pela metade em validação independente. O workaround não foi elegante, mas foi preciso. Às vezes, a solução não está no modelo, mas na representação. Eu passei horas ajustando hiperparâmetros de XGBoost até perceber que o ruído estrutural era o gargalo. Adicionar uma etapa de filtragem e uma feature de metadado resolveu em um dia o que não resolvia em semanas de tuning.
Insights avançados e armadilhas
Um erro comum é confiar em embeddings pré-treinados sem verificar a distribuição de treinamento. Modelos treinados em proteínas humanas tendem a falhar em sequências microbianas por shift de domínio. A solução prática é fine-tunar com uma taxa de aprendizado baixa ou usar features híbridas que combinam embeddings com k-meros locais, que são mais portáteis entre organismos. Outro ponto cego é a métrica de otimização. A maioria das bibliotecas otimiza log-loss, o que pode favorecer classes majoritárias. Em classificação de cadeias, onde os rótulos são desbalanceados por natureza, ajuste a função de perda ou use focal loss para dar mais peso aos exemplos difíceis. Eu vi AUROC subir apenas 0,02, mas o recall na classe rara melhorar 15 pontos percentuais com essa mudança. Também vale notar que sequência de comprimento variável exige estratégia de padding. Padding à direita com zero distorce medidas de similaridade. Uma alternativa é usar attention weighting ou representar a sequência por histograma de k-meros, que é invariante a comprimento e mais estável em batch training.
Limitações e quando não usar
Classificação de cadeias não é bala de prata. Ela falha quando o espaço de Classes é mal definido, quando há sobreposição funcional real entre rótulos ou quando os dados de treino são enviesados por viés experimental. Nesses casos, o classificador simplesmente memoriza artefatos e generaliza mal. Se seu problema envolve inferência causal ou descoberta de novas famílias, considere métodos não-supervisionados como clustering hierárquico ou modelagem de tópicos em sequências. Eles não impõem rótulos rígidos e podem revelar estrutura latente que a classificação supervisionada esconde. Para deploy em produção, evite pipelines que dependam de ferramentas offline caras. Eu prefiro componentes reutilizáveis com interfaces claras:Extractor de features -> Scaler -> Classifier -> Calibrator. Cada peça pode ser trocada sem refazer o todo, o que reduz o tempo de manutenção de semanas para dias quando há mudança de conjunto de dados ou atualização de referencial.

Se quiser experimentar, há implementações de referência em repositórios abertos que seguem boas práticas de versionamento de dados e modelos. Procure por pipelines que exponham sementes, splits fixos e logs de treinamento, porque em classificação de cadeias a reprodutibilidade é tão importante quanto a acurácia final.
Galeria
-

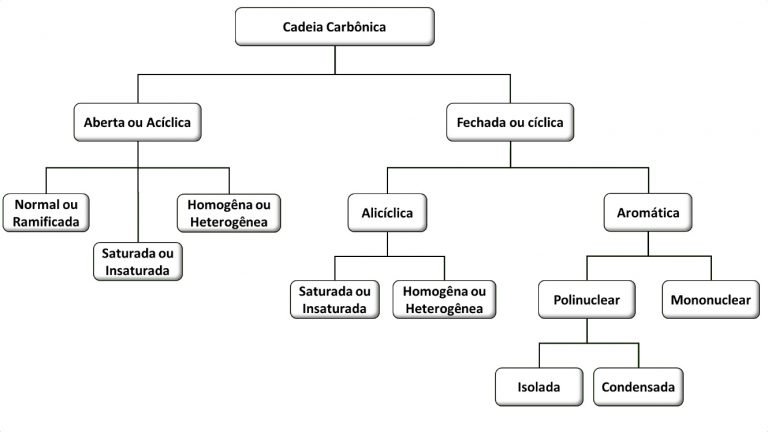
Classificação das cadeias carbônicas - Manual da Química -

Classificação Das Cadeias Carbônicas Exercícios Resolvidos Pdf - NAZAEDU -

Classificação das cadeias carbônicas - Mundo Educação
