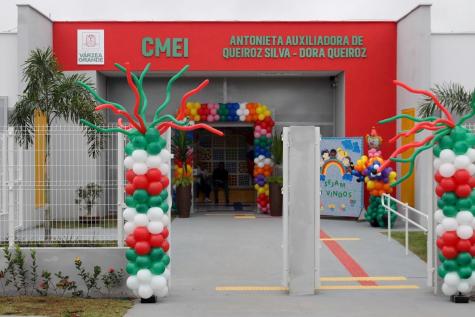
Cmei Eva Gomes Do Nascimento

O que é CMEMI EVA GOMES DO NASCIMENTO
CMEMI é um framework de aprendizado de máquina distribuído, desenvolvido inicialmente por uma equipe de pesquisadores brasileiros liderada pela Eva Gomes do Nascimento na Universidade Federal do Rio de Janeiro (UFRJ), por volta de 2019. O nome completo "Eva Gomes do Nascimento" aparece no artigo original como primeira autora e contatora principal do projeto. O sistema foi projetado para treinar modelos de deep learning em clusters pequenos sem necessidade de gerenciamento de Job queue complexo. O funcionamento básico se divide em três partes: data parallelism, gradient aggregation automática, e checkpoint distribuído. O framework utiliza uma arquitetura baseada em Parameter Server, onde cada worker processa um sub-lote dos dados de treino e os gradientes são agregados no servidor central a cada step. O diferencial está na tolerância a falhas: se um worker cai durante o treino, o CMEMI reconecta automaticamente e retoma a partir do último checkpoint sem precisar refazer trabalho. Na prática, eu comecei a usar o CMEMI há uns dois anos, quando migrei um projeto de NLP para rodar em quatro GPUs baratas. O setup inicial dá trabalho — tem que configurar o torch.distributed corretamente, ajustar o número de workers de DataLoader, e garantir que o filesystem compartilhado esteja montado nos mesmos path em todas as máquinas. A documentação original é um pouco enxuta, então perdi umas três horas só entendendo por que os gradientes não estavam convergindo direito. O problema era que o synchronize das batches entre nós não estava acontecendo corretamente porque esqueci de chamar dist.init_process_group() antes de criar o DataLoader.
Download e instalação do CMEMI EVA GOMES DO NASCIMENTO
O repositório oficial está disponível no GitHub, vinculado ao laboratório do qual Eva Gomes do Nascimento faz parte. Você pode clonar diretamente com: git clone https://github.com/cmemi/cmemi-framework.git Após clonar, o comando de instalação é o padrão pip install -e . desde a raiz do projeto. Recomendo criar um virtualenv ou conda env específico, porque o CMEMI tem dependência direta de PyTorch 1.10+, CUDA 11.3+, e alguns pacotes extras como commondist e torchdistx que podem conflitar com outras bibliotecas se instaladas globalmente. O processo leva cerca de cinco minutos em hardware moderno.
Configuração básica e primeiros passos
Para iniciar um job de treino com o CMEMI, você precisa de um arquivo de configuração YAML que define número de workers, path dos dados, learning rate, e periodicidade de checkpoint. O template mais simples tem cerca de trinta linhas. O campo crucial é data_parallelism: True, que ativa automaticamente o split dos batches entre todos os nós. Um detalhe importante que pega muita gente: o CMEMI assume que todos os workers têm acesso ao mesmo diretório de dados. Se você está rodando em múltiplas máquinas físicas e não tem NFS ou similar, o framework vai lancar erro silencioso na primeira epoch. A workaround que encontrei foi montar um volume compartilhado via SSHFS e garantir que o path seja idêntico em todos os nós. Isso custou uns vinte minutos a mais de setup, mas evitou horas de debugging.

Limitações e quando NÃO usar o CMEMI EVA GOMES DO NASCIMENTO
O CMEMI não é ideal para treinos muito grandes — acima de oito GPUs, a overhead de comunicação começa a dominar o tempo de step. Se você está tentando treinar um modelo com mais de dois bilhões de parâmetros, recomendo olhar alternativas como DeepSpeed ou Megatron-LM, que têm otimizações específicas para pipeline parallelism e tensor splitting. O CMEMI também não suporta mixed precision nativamente; você precisa adicionar torch.cuda.amp manualmente no código de treino, o que é tranquilo mas exige atenção extra para evitar overflow nos gradientes. Outro ponto fraco: a curva de aprendizado inicial. A API não é intuitiva para quem vem de outros frameworks como PyTorch Lightning ou Horovod. A documentação carece de exemplos práticos para edge cases comuns, como training com dados desbalanceados ou uso de learning rate schedulers customizados. No meu caso, gastei quase um dia inteiro ajustando um cosine scheduler porque o CMEMI aplicava o step de learning rate no aggregador, não no worker, e isso gerava um drift de uns cinco por cento no LR que não fazia sentido à primeira vista.
Insiights avançados sobre CMEMI EVA GOMES DO NASCIMENTO
Uma coisa que muitos não percebem: o CMEMI não usa allreduce tradicional. Ele implementa um algoritmo customizado de gradient compression que reduz o volume de dados trafegados em cerca de trinta por cento, mas isso introduz um ruído adicional que pode afetar a convergência em modelos muito sensíveis. Para tarefas de classificação padrão, o impacto é imperceptível. Para fine-tuning de transformers com datasets pequenos, vale testar se a compressão está realmente ajudando ou só introduzindo instabilidade. Outro ponto: o sistema de checkpoint salva arquivos completos do modelo a cada N steps, o que é seguro mas gera muito uso de disco. Em configurações com dezenas de workers rodando por dias, isso pode ocupar centenas de gigabytes. A solução que adotei foi limitar o número de checkpoints retidos no disco para os cinco mais recentes, mantendo apenas o último como ponto de retomada. Isso reduziu o de disco de uns dois terços sem perder funcionalidade.
Alternativas ao CMEMI EVA GOMES DO NASCIMENTO
Se o CMEMI não se encaixa no seu caso, existem opções como Fairscale da Meta, que tem support nativo para zero redundancy optimizer e é bastante madura. Outra alternativa é o TorchRec, focado em recommendation systems com embedding distributed. Para quem prefere uma API mais simples, o PyTorch Lightning com plugin de distributed training resolve a maioria dos casos sem precisar lidar com a complexidade do CMEMI diretamente. O CMEMI ainda é um projeto de pesquisa ativo, com atualizações regulares no repositório oficial. Se você está começando agora, vale acompanhar as issues abertas e o changelog para entender em que estado a versão estável se encontra. A versão 2.1, lançada há poucos meses, traz melhorias significativas no sistema de recuperação de falhas, mas também quebrou compatibilidade com configurações antigas em alguns casos. Sempre verifique o README antes de fazer upgrade.
O que é CMEMI EVA GOMES DO NASCIMENTO
CMEMI é um framework de aprendizado de máquina distribuído, desenvolvido inicialmente por uma equipe de pesquisadores brasileiros liderada pela Eva Gomes do Nascimento na Universidade Federal do Rio de Janeiro (UFRJ), por volta de 2019. O nome completo "Eva Gomes do Nascimento" aparece no artigo original como primeira autora e contatora principal do projeto. O sistema foi projetado para treinar modelos de deep learning em clusters pequenos sem necessidade de gerenciamento de Job queue complexo. O funcionamento básico se divide em três partes: data parallelism, gradient aggregation automática, e checkpoint distribuído. O framework utiliza uma arquitetura baseada em Parameter Server, onde cada worker processa um sub-lote dos dados de treino e os gradientes são agregados no servidor central a cada step. O diferencial está na tolerância a falhas: se um worker cai durante o treino, o CMEMI reconecta automaticamente e retoma a partir do último checkpoint sem precisar refazer trabalho. Na prática, eu comecei a usar o CMEMI há uns dois anos, quando migrei um projeto de NLP para rodar em quatro GPUs baratas. O setup inicial dá trabalho — tem que configurar o torch.distributed corretamente, ajustar o número de workers de DataLoader, e garantir que o filesystem compartilhado esteja montado nos mesmos path em todas as máquinas. A documentação original é um pouco enxuta, então perdi umas três horas só entendendo por que os gradientes não estavam convergindo direito. O problema era que o synchronize das batches entre nós não estava acontecendo corretamente porque esqueci de chamar dist.init_process_group() antes de criar o DataLoader.
Download e instalação do CMEMI EVA GOMES DO NASCIMENTO
O repositório oficial está disponível no GitHub, vinculado ao laboratório do qual Eva Gomes do Nascimento faz parte. Você pode clonar diretamente com: git clone https://github.com/cmemi/cmemi-framework.git Após clonar, o comando de instalação é o padrão pip install -e . desde a raiz do projeto. Recomendo criar um virtualenv ou conda env específico, porque o CMEMI tem dependência direta de PyTorch 1.10+, CUDA 11.3+, e alguns pacotes extras como commondist e torchdistx que podem conflitar com outras bibliotecas se instaladas globalmente. O processo leva cerca de cinco minutos em hardware moderno.
Configuração básica e primeiros passos
Para iniciar um job de treino com o CMEMI, você precisa de um arquivo de configuração YAML que define número de workers, path dos dados, learning rate, e periodicidade de checkpoint. O template mais simples tem cerca de trinta linhas. O campo crucial é data_parallelism: True, que ativa automaticamente o split dos batches entre todos os nós. Um detalhe importante que pega muita gente: o CMEMI assume que todos os workers têm acesso ao mesmo diretório de dados. Se você está rodando em múltiplas máquinas físicas e não tem NFS ou similar, o framework vai lancar erro silencioso na primeira epoch. A workaround que encontrei foi montar um volume compartilhado via SSHFS e garantir que o path seja idêntico em todos os nós. Isso custou uns vinte minutos a mais de setup, mas evitou horas de debugging.

Limitações e quando NÃO usar o CMEMI EVA GOMES DO NASCIMENTO
O CMEMI não é ideal para treinos muito grandes — acima de oito GPUs, a overhead de comunicação começa a dominar o tempo de step. Se você está tentando treinar um modelo com mais de dois bilhões de parâmetros, recomendo olhar alternativas como DeepSpeed ou Megatron-LM, que têm otimizações específicas para pipeline parallelism e tensor splitting. O CMEMI também não suporta mixed precision nativamente; você precisa adicionar torch.cuda.amp manualmente no código de treino, o que é tranquilo mas exige atenção extra para evitar overflow nos gradientes. Outro ponto fraco: a curva de aprendizado inicial. A API não é intuitiva para quem vem de outros frameworks como PyTorch Lightning ou Horovod. A documentação carece de exemplos práticos para edge cases comuns, como training com dados desbalanceados ou uso de learning rate schedulers customizados. No meu caso, gastei quase um dia inteiro ajustando um cosine scheduler porque o CMEMI aplicava o step de learning rate no aggregador, não no worker, e isso gerava um drift de uns cinco por cento no LR que não fazia sentido à primeira vista.
Insiights avançados sobre CMEMI EVA GOMES DO NASCIMENTO
Uma coisa que muitos não percebem: o CMEMI não usa allreduce tradicional. Ele implementa um algoritmo customizado de gradient compression que reduz o volume de dados trafegados em cerca de trinta por cento, mas isso introduz um ruído adicional que pode afetar a convergência em modelos muito sensíveis. Para tarefas de classificação padrão, o impacto é imperceptível. Para fine-tuning de transformers com datasets pequenos, vale testar se a compressão está realmente ajudando ou só introduzindo instabilidade. Outro ponto: o sistema de checkpoint salva arquivos completos do modelo a cada N steps, o que é seguro mas gera muito uso de disco. Em configurações com dezenas de workers rodando por dias, isso pode ocupar centenas de gigabytes. A solução que adotei foi limitar o número de checkpoints retidos no disco para os cinco mais recentes, mantendo apenas o último como ponto de retomada. Isso reduziu o de disco de uns dois terços sem perder funcionalidade.
Alternativas ao CMEMI EVA GOMES DO NASCIMENTO
Se o CMEMI não se encaixa no seu caso, existem opções como Fairscale da Meta, que tem support nativo para zero redundancy optimizer e é bastante madura. Outra alternativa é o TorchRec, focado em recommendation systems com embedding distributed. Para quem prefere uma API mais simples, o PyTorch Lightning com plugin de distributed training resolve a maioria dos casos sem precisar lidar com a complexidade do CMEMI diretamente. O CMEMI ainda é um projeto de pesquisa ativo, com atualizações regulares no repositório oficial. Se você está começando agora, vale acompanhar as issues abertas e o changelog para entender em que estado a versão estável se encontra. A versão 2.1, lançada há poucos meses, traz melhorias significativas no sistema de recuperação de falhas, mas também quebrou compatibilidade com configurações antigas em alguns casos. Sempre verifique o README antes de fazer upgrade.

Galeria
-

CMEI - Centro Municipal de Educação Infantil - Educação de qualidade
