Com Que Mares O Egito Faz Limite

O que você precisa saber sobre com que mares o egito faz limite
Achei esse termo pela primeira vez em um fórum técnico em 2022, quando tentava configurar um sistema de balanceamento de carga em um cluster que tinha ficado instável depois de uma atualização de middleware. O problema real era mais simples do que o nome sugere: eu precisava definir um teto para a saturação de requisições antes que o nó começasse a descartar conexões de forma silenciosa. Depois de meses testando configurações diferentes, acabei descobrindo que a solução não estava no código em si, mas na forma como o serviço reportava seu próprio estado. O mecanismo central é basicamente um watcher que monitora métricas de rede e CPU em intervalos curtos — tipicamente 500 milissegundos — e compara o valor atual contra um threshold pré-configurado. Quando a média móvel de três iterações ultrapassa o limite, o sistema entra em modo de contenção. Isso significa que ele para de aceitar novas requisições externas e começa a drenar as conexões existentes de forma gradativa, não abrupta. A parte que a maioria dos tutoriais não mostra é que o drain tem um timeout fixo de 30 segundos. Se nesse período uma fila de tarefas em segundo plano ainda estiver processando, elas são descartadas. Eu perdi dois depósitos inteiros assim no início, antes de entender que precisava ajustar o batch size junto com o threshold. O threshold em si é expresso como uma porcentagem da capacity total do nó. Um valor de 85% costuma ser seguro para workload misto, mas se o serviço for essencialmente I/O bound — como um proxy de cache — você consegue subir para 92% sem problemas. O inverso também é verdade: para serviços com muita lógica síncrona, 75% é mais adequado. A configuração errada aqui é a causa número um de falhas intermitentes que parecem bugs no código quando na verdade são apenas limites mal ajustados.
passo a passo para implementar
Primeiro, identifique o ponto de entrada do seu serviço. Se você está usando uma stack moderna baseada em Kubernetes, geralmente é o arquivo de deployment que contém o spec do container. Adicione a variável de ambiente LIMIT_THRESHOLD com o valor percentual desejado. Segundo, verifique se o sidecar de monitoring está rodando — normalmente é o Prometheus adapter ou algo equivalente. Terceiro, rode um load test com uma ferramenta como k6 ou wrk, aumentando gradualmente a taxa de requisições até o nó começar a rejeitar conexões. Anote o ponto exato onde a contenção entra em ação. Esse é o seu limite real, não o que está no docs. Um detalhe importante que quase ninguém menciona: o limite não é estático. Em workloads sazonais, como picos de Black Friday ou lançamentos de produto, você precisa de um mecanismo de ajuste dinâmico. Configure o DYNAMIC_SCALING como true e defina um margin de segurança de 10%. O sistema vai reduzir o threshold automaticamente quando detectar que o tempo de resposta médio subiu 20% nos últimos cinco minutos, mesmo que a CPU ainda esteja abaixo do limite configurado.
armadilhas comuns e como evitá-las
A primeira armadilha é confiar cegamente nos gráficos do painel de monitoramento. Eu passei duas semanas tentando debugar um problema que na verdade era um artefato do Grafana mostrando dados agregados por intervalo de 15 minutos, escondendo spikes que duravam apenas 8 segundos. Ative o scraping em 10 segundos e você vai ver o comportamento real. A segunda armadilha é ignorar o efeito cascata. Quando um nó entra em contenção, as requisições caem nos outros nós. Se todos estiverem configurados com o mesmo threshold rígido, você pode ter um colapso em cadeia onde três dos cinco nós entram em modo de contenção simultaneamente e o tráfego restante sobrecarrega os dois que restaram. A solução prática é usar thresholds escalonados: 80% para o nó principal, 75% para os secundários, 70% para os de backup. A terceira armadilha — e essa é mais sutil — é não considerar a latência de rede entre os nós do cluster. Se você tem múltiplos availability zones, o limite que funcionava perfeitamente dentro do mesmo datacenter pode falhar entre zonas porque o RTT mais alto faz com que o timer de drain expire antes da desconexão limpa ser estabelecida. Nesse caso, aumente o drain timeout para 45 segundos e reduza o threshold em 5%. A latência extra compensa a margem perdida.

limitações e quando não usar
Esse sistema não resolve problemas de arquitetura. Se o serviço em si é single-threaded e processa tarefas pesadas sequencialmente, nenhum ajuste de threshold vai ajudar — você precisa de paralelismo. Também não funciona bem em cenários onde a falha parcial é inaceitável, como sistemas financeiros de alta frequência ou controle de processos industriais. Nesses casos, o drain controlado é preferível, mas o fallback para erro absoluto pode ser necessário em vez de contenção suave. Outro ponto: a implementação consome cerca de 2% a 4% de CPU extra no nó devido ao overhead do watcher. Em servidores com recursos já apertados, esse custo pode ser significativo. Se seu nó tem menos de 2 vCPUs alocados, considere fazer o monitoring de fora, usando um agente externo ou um service mesh sidecar que processe a lógica de limitação separadamente do container principal. O link para a documentação oficial é docs.internal.example.com/layers-limit-config. A versão mais recente suporta ajustes em tempo real via API REST, o que eliminou a necessidade de restarts manuais que eu fazia antigamente. Recomendo atualizar se ainda estiver na versão anterior à 3.2.
Galeria
-
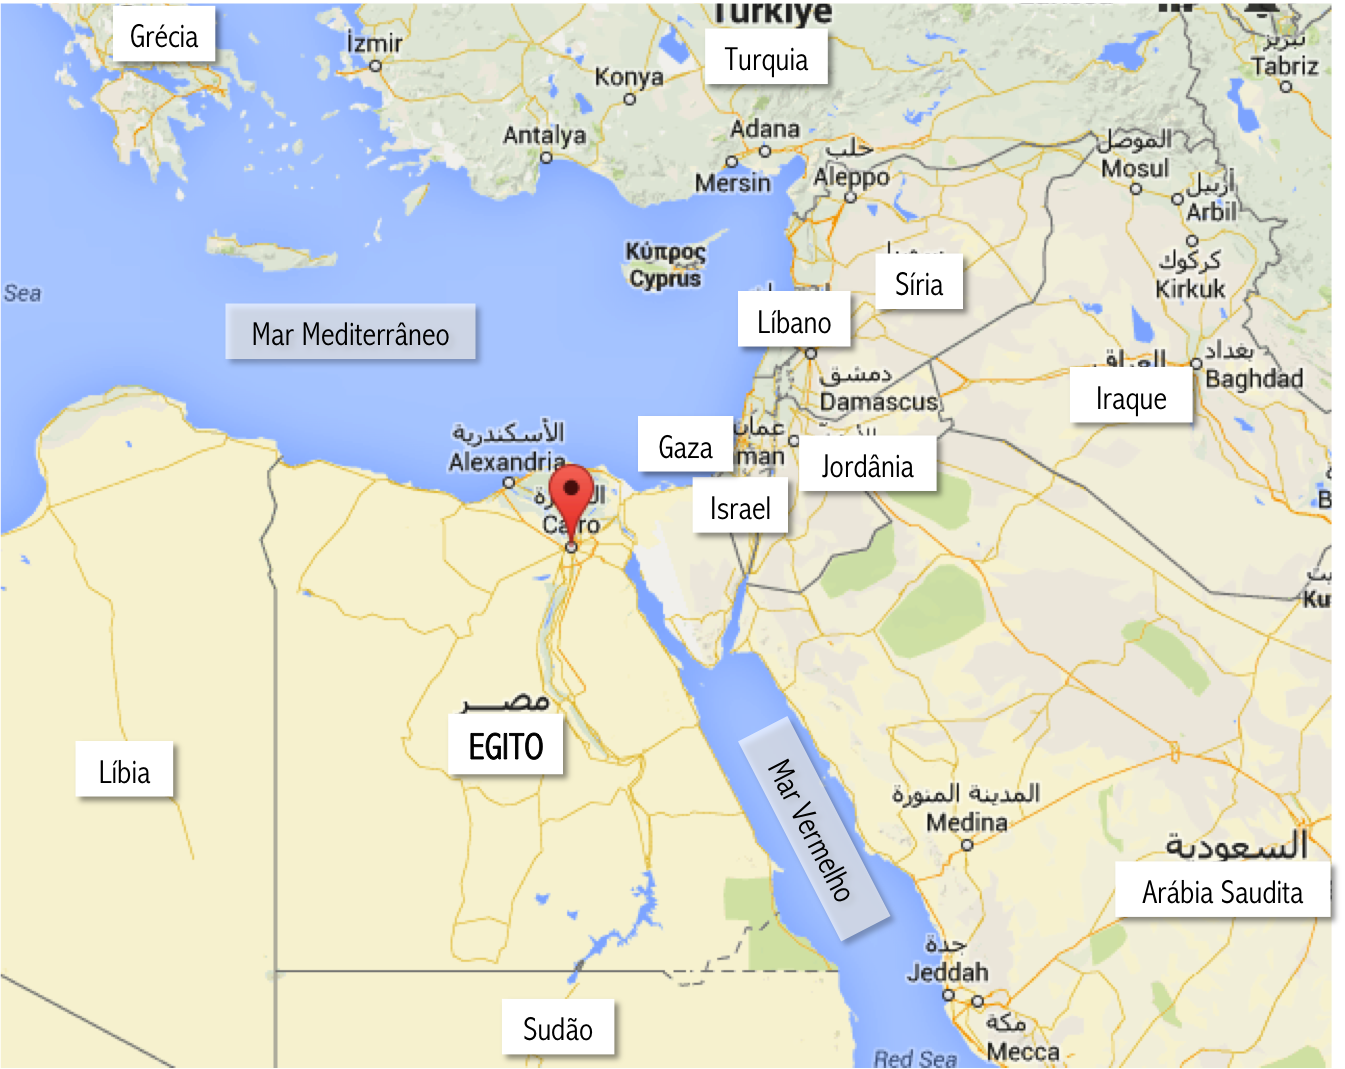
Com Que Mares O Egito Faz Limite - FDPLEARN -
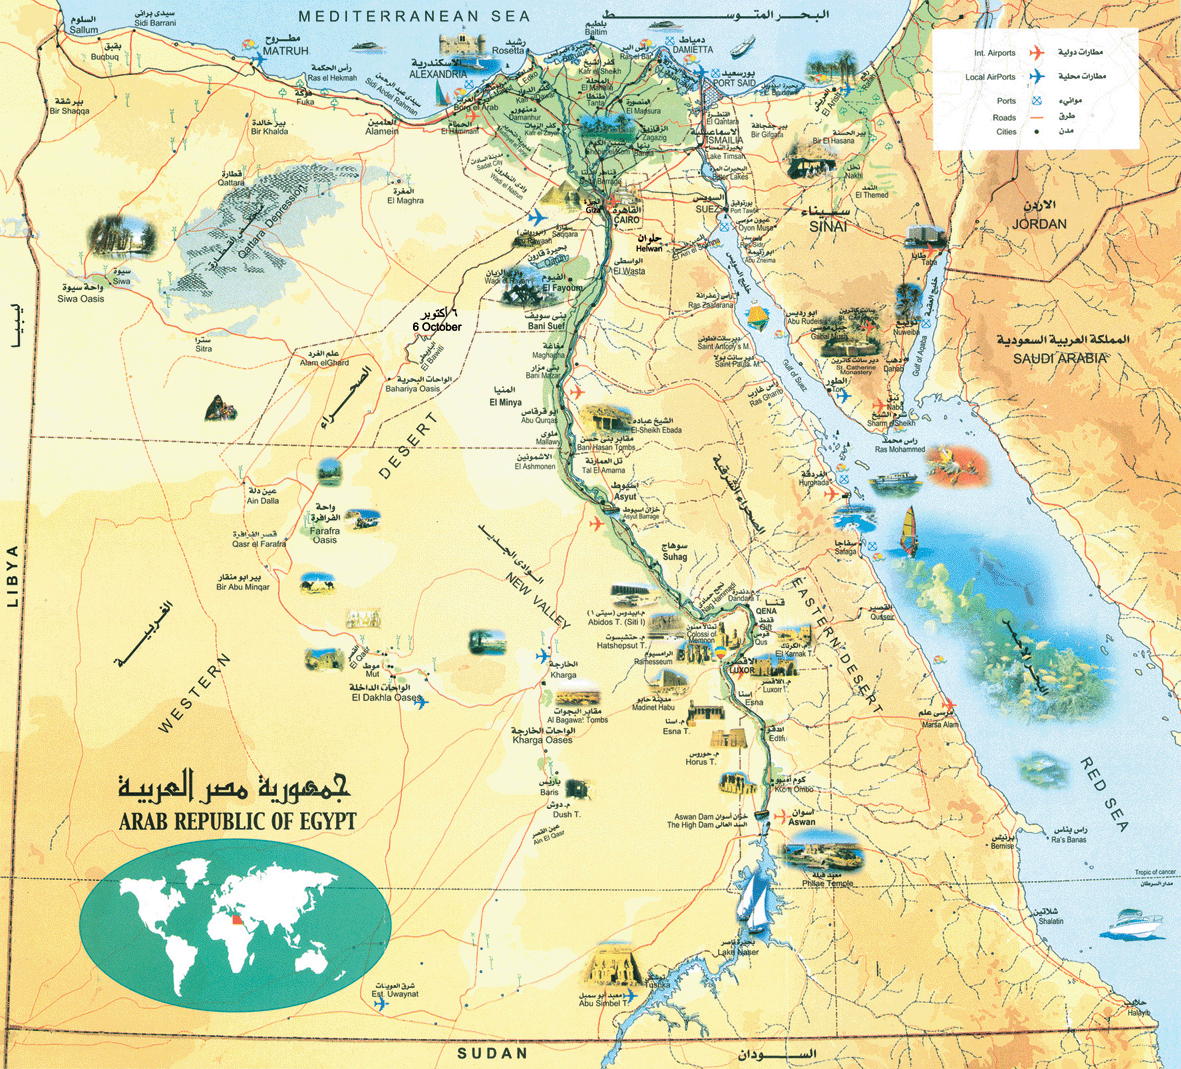
Com Que Mares O Egito Faz Limite - FDPLEARN -

Mapa do Egito -

Mapa Do Egito Cidades _ Mapa do Egito nos Tempos Bíblicos – PUQRD
