Como Copiar O Codigo Html De Uma Pagina

Como extrair código-fonte de uma página web
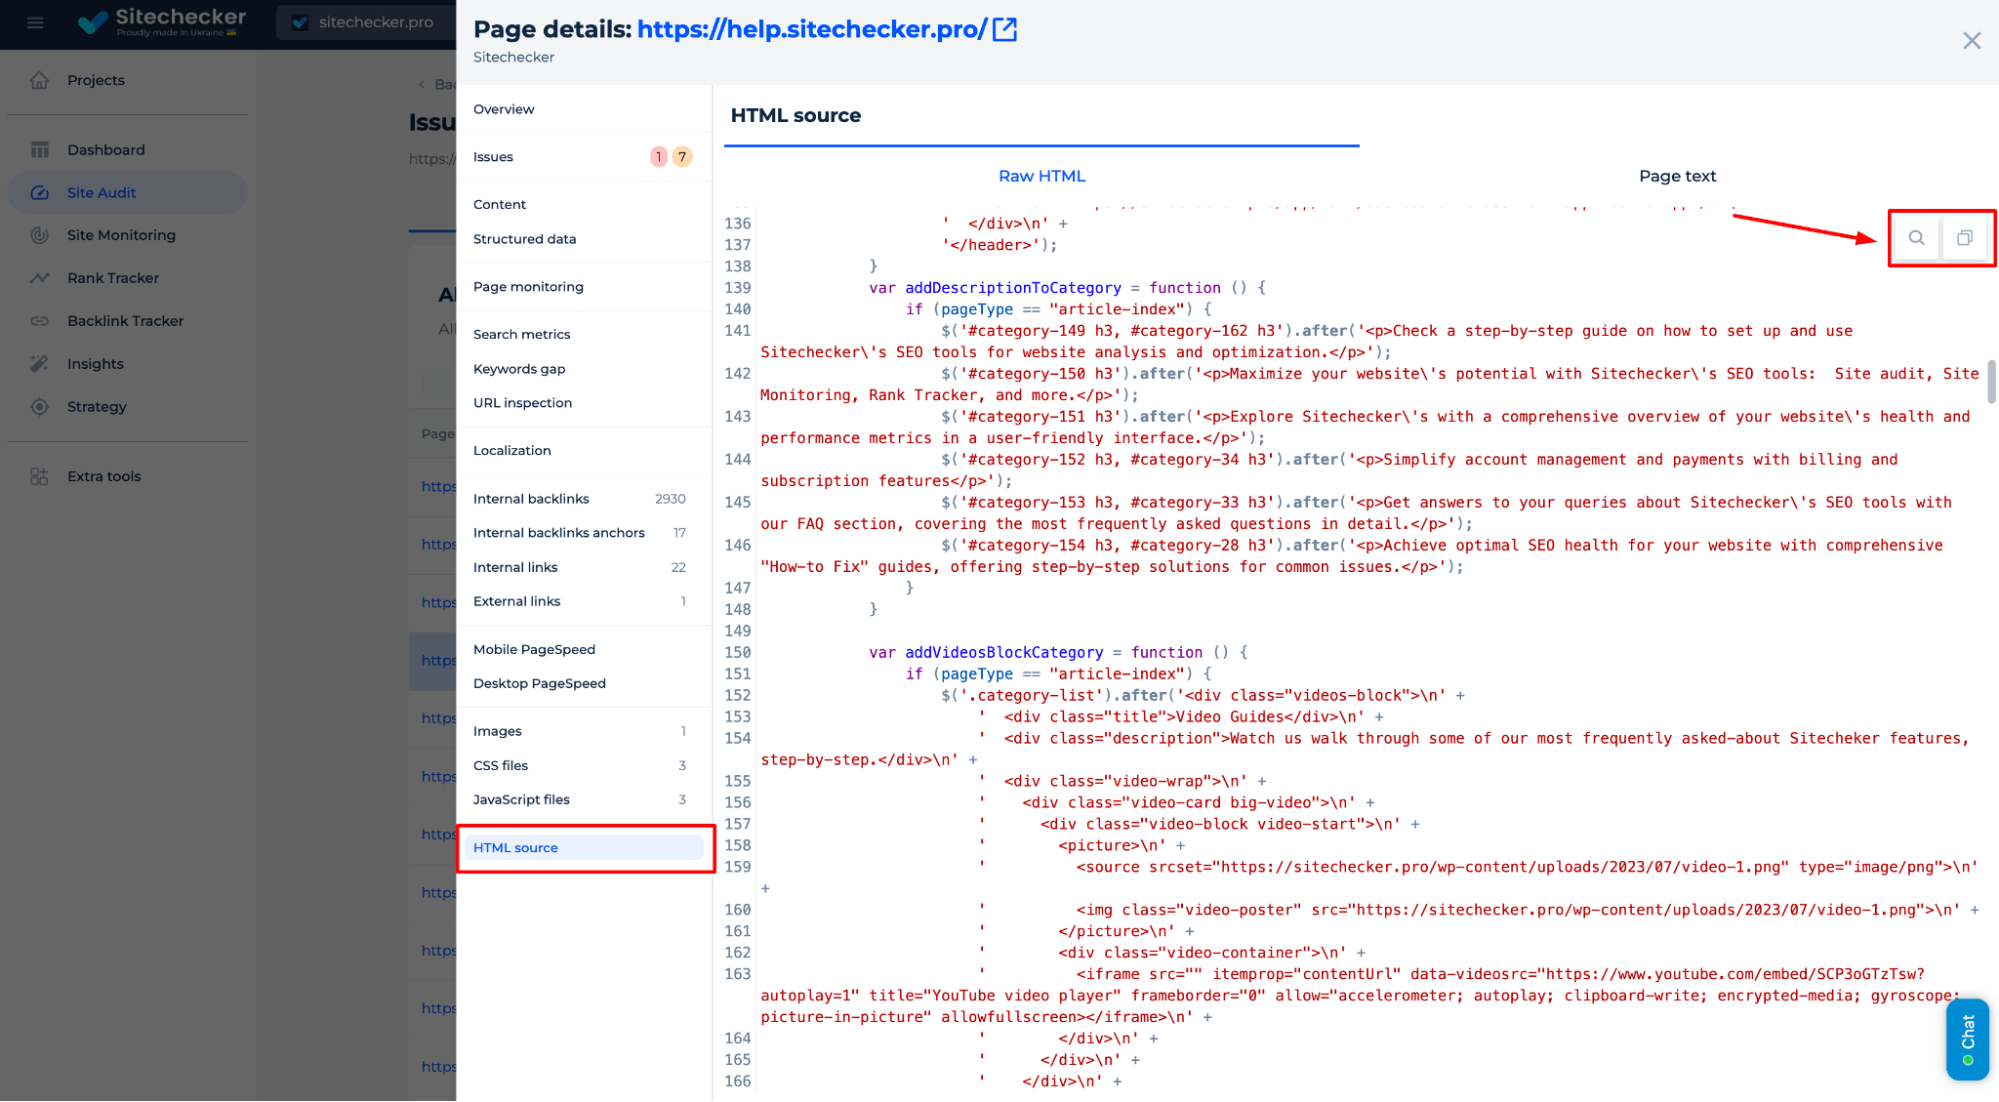
A maioria das pessoas não sabe que tem o código HTML de qualquer site aberto no navegador agora mesmo. O processo é simples, mas existem detalhes que fazem diferença quando você precisa fazer isso com frequência ou lidar com sites mal estruturados. O método mais direto é abrir a página, clicar com o botão direito em qualquer lugar vazio e selecionar "Exibir código-fonte da página". Isso abre uma nova aba com o HTML puro, sem CSS nem JavaScript embutido visualmente. Você pode dar Ctrl+A para selecionar tudo, Ctrl+C para copiar e colar onde precisar. Existe uma alternativa mais prática: acessar Ferramentas do Desenvolvedor com F12 ou Ctrl+Shift+I. A aba Elements mostra o DOM renderizado pelo navegador, o que é diferente do código-fonte original. Sites modernos frequentemente injetam conteúdo via JavaScript, então o que aparece no código-fonte pode não corresponder ao que você vê na tela.
Se você precisa salvar o arquivo completo para análise offline, existe a opção "Salvar como" no menu do navegador. Ele cria um arquivo .html com todos os recursos relacionados (imagens, CSS, scripts) em uma pasta adjacente. O problema é que links relativos muitas vezes quebram quando você abre o arquivo localmente. Já enfrentei um caso específico em que o HTML de uma página de e-commerce estava sendo construído quase inteiramente por JavaScript. O código-fonte exibia apenas um esqueleto vazio com divs sem conteúdo significativo. A solução foi usar o DevTools na aba Network, filtrar por Fetch/XHR, e capturar as requisições que traziam os dados reais. Dessa forma, consegui reconstruir a estrutura HTML com o conteúdo correto.
Alternativas e ferramentas
Para extrações pontuais, o método manual funciona. Quando você precisa processar múltiplas páginas repetidamente, ferramentas como wget ou curl com a flag -O economizam tempo. Um comando como wget -O pagina.html https://exemplo.com baixa o HTML diretamente para o disco. A desvantagem é que esse método não executa JavaScript, então páginas single-page applications retornarão apenas o template vazio. Extensões de navegador como "SourceGraph" ou "Web Scraper" oferecem interfaces mais amigáveis e permitem extração seletiva. Há também a opção de usar bibliotecas como Puppeteer ou Selenium, que carregam a página completamente antes de expor o DOM. Isso resolve o problema de conteúdo dinâmico, mas adiciona complexidade e tempo de execução considerável. Uma armadilha comum é confundir HTML bruto com markup limpo. Páginas modernas frequentemente contêm thousands de linhas de código gerado por frameworks, com classes utilitárias, atributos data e elementos redundantes. Se seu objetivo é estudar a estrutura ou reutilizar trechos, considere usar uma ferramenta de formatação ou um depurador de HTML para simplificar o que você extraiu.
Galeria
-

Guía Para Crear Una Página Html De Hola Mundo Paso A Paso – MNQJCP -
Ver Codigo HTML Fuente Pagina Web | Inspeccione su código e identifique ... -
Como Criar uma Página Web Simples com HTML e CSS -

Cómo hacer una página web en HTML (paso a paso)
