Como Fazer Um Commit No Git
O que acontece quando você dá um commit
Um commit no Git é basicamente uma foto do estado dos seus arquivos num determinado momento. Você diz ao Git "quero guardar isso agora" e ele cria um registro permanente com um hash único. É isso. Nada de mágica, só um snapshot que ocupa espaço no seu repositório local até você fazer push. Muita gente trava na primeira vez porque acha que precisa entender tudo antes de começar. A verdade é que você consegue fazer 90% do trabalho com três comandos. O resto é refinamento que vem com o tempo e com os erros que você comete.
como fazer um commit no git passo a passo
Vamos direto ao que funciona. Abra o terminal na pasta do seu projeto. Se for o primeiro commit, inicialize o repositório com git init. Se já tiver um repositório criado, basta entrar na pasta. O Git vai criar uma pasta escondida chamada .git que armazena todo o histórico. Antes de qualquer coisa, verifique o status com git status. Esse comando mostra tudo que mudou desde o último commit, arquivos novos, modificados e ignorados. Parece desnecessário no começo, mas pular esse passo é o erro mais comum de quem tá aprendendo. Você já vai ver por que isso importa. Para colocar arquivos na área de staging, use git add. Se quiser adicionar um arquivo específico, digite git add nome-do-arquivo. Se quiser adicionar todos os arquivos modificados de uma vez, git add . funciona, mas tome cuidado com essa abordagem. O ponto adiciona literalmente tudo, inclusive arquivos que talvez você não queira versionar. Deixa eu te contar algo que aprendi na marra: uma vez eu fiz um commit acidental com credenciais de banco de dados porque o git add . pegou um arquivo .env que estava numa lista de exclusão mal configurada. Eu tava desenvolvendo um sistema de autenticação para um cliente e o arquivo tinha senhas em texto puro. O commit já tinha sido feito, com push pra branch principal do repositório. A solução que funcionou foi reescrever o histórico localmente com git rebase -i na última semana de commits, removendo aquele arquivo do histórico inteiro. Levou cerca de 40 minutos pra ajustar tudo certinho sem quebrar o trabalho dos outros dois desenvolvedores que já tinham puxado os commits anteriores.
Depois de adicionar os arquivos que deseja, faça o commit com git commit -m "descrição clara do que mudou". A mensagem do commit é importante. Evite coisas como "atualização" ou "mudanças". Descreva o quê e por quê. Um commit bem descrito economiza horas de investigação depois. Se quiser confirmar que o commit foi criado, rode git log e você vai ver o histórico com hash, autor, data e mensagem. Cada commit recebe um hash SHA-1 de 40 caracteres que é sua identificação única e imutável. Por fim, se o repositório estiver conectado a um remoto, use git push para enviar os commits para o servidor. Sem o push, os commits ficam só no seu computador.

Nuances que ninguém explica no tutorial rápido
O Git tem um conceito chamado staging area que separa o que está pronto para virar commit do que ainda tá em desenvolvimento. Esse recurso é o que diferencia o Git de sistemas de versionamento mais simples. Você pode ter cinco arquivos modificados, adicionar só três deles ao staging, e commitar apenas aqueles três. Os outros dois continuam lá, modificados mas não versionados, esperando você decidir o que fazer com eles. Outro detalhe importante: commits no Git são atomáticos e imutáveis. Uma vez criado, o commit nunca muda. Se você precisa corrigir algo, não edita o commit antigo. Você cria um novo commit que sobrescreve ou corrige o anterior. Isso é fundamental para entender como o Git funciona por dentro e evitar frustrações quando tentar "voltar no tempo" e descobrir que não dá pra fazer isso da forma que você esperava. Existe também a diferença entre git commit --amend e criar um novo commit. O amend modifica o commit mais recente, adicionando arquivos ou mudando a mensagem. Mas usar amend em commits que já foram enviados pra um repositório remoto compartilhado é perigoso. Isso altera o hash do commit e qualquer pessoa que já tenha puxado aquele commit vai ter conflito na hora de sincronizar. Em times pequenos isso pode ser resolvido com git push --force, mas em times maiores ou em repositórios públicos, o melhor é sempre criar um novo commit de correção em vez de reescrever o histórico.
Uma limitação prática que muita gente não leva em conta: commits pesados. Se você commitar arquivos grandes, como vídeos, binários compilados ou datasets, o repositório cresce rapidamente e o clone fica lento. O Git não foi projetado pra isso. A solução é usar Git LFS (Large File Storage) ou simplesmente adicionar esses arquivos na lista de exclusões do .gitignore. Eu já vi repositórios chegarem a 2GB porque alguém havia commitado um arquivo de backup de banco de dados inteiro sem perceber. O tempo de clone passava de 20 minutos pra rodar só pra abrir o projeto. Para evitar confusão com arquivos que não devem ser versionados, configure o .gitignore antes de começar a dar commits. Arquivos de node_modules, pastas de build, logs de execução e variáveis de ambiente entram aí. Se deixar pro final, você vai passar tempo demais desfazendo commits errados.
Galeria
-
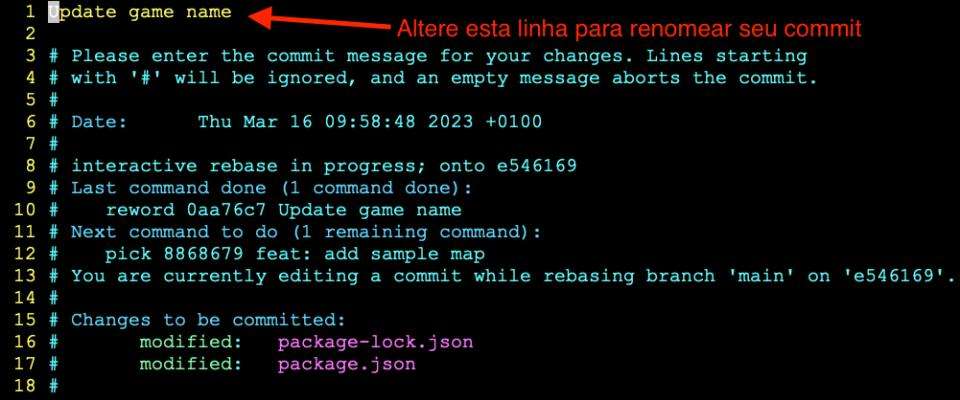
GIT: Como renomear mensagens de commit em um repositório - codamos.com.br -

Nomenclaturas de Commits no Git | ARIOSTO LEAL | GitHub | Git | GitHub ... -

[pt-BR] Fundamentos do Git, um guia completo - DEV Community -
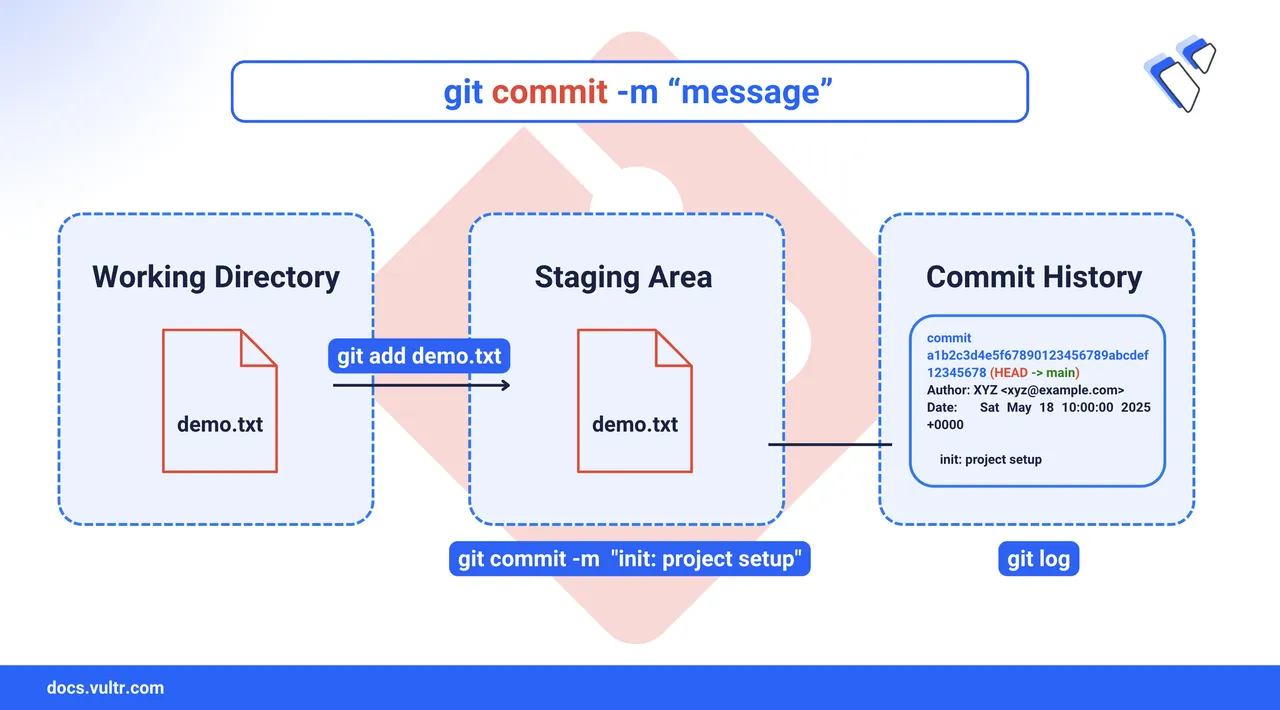
How to Commit Changes in Git: A Complete Guide | Vultr Docs
