Como Funciona O Adc Noturno

O que é um ADC Noturno
Um ADC noturno é basicamente um processo de transformação de dados agendado para rodar fora do horário comercial. A sigla ADC vem de Agregate-Derive-Change, e o conceito por trás dele é simples: você junta tabelas de fontes diferentes, aplica regras de negócio pra transformar esses dados e carrega o resultado num data warehouse ou num banco de destino. A parte "noturna" entra porque essas cargas geralmente rodam entre 23h e 6h da manhã, quando o tráfego nos sistemas fonte tá baixo. Se você tentar rodar essas consultas pesadas no horário de pico, vai travar as operações do negócio inteiro. Já vi pipeline de ETL derrubar uma plataforma de vendas por alguém ter colocado um join pesado pra executar às 14h.
como funciona o adc noturno na prática
Vou explicar do jeito que eu vejo funcionar nos projetos que acompanho. O fluxo básico segue essas etapas: O job noturno começa buscando os dados nos sistemas transacionais — ERP, CRM, bancos operacionais. Isso é feito via consulta SQL direta, API ou file share, dependendo da fonte. O importante aqui é controlar o watermark, que é o registro mais recente processado. Sem isso, você vai perder dados ou duplicar registros em cada execução. Aqui é onde a maioria dos problemas acontece. Você precisa aplicar regras como normalização de campos, tratamento de nulos, conversão de tipos e joins entre tabelas. Regras de negócio como cálculo de margem, aggregação por período e deduplication entram nessa fase. Um detalhe que muita gente subestima: a ordem das transformações importa. Se você faz agregação antes de limpar os dados, os números vão sair errados e ninguém vai perceber até rodar o relatório final.
Os dados transformados são escritos nas tabelas de destino. Pode ser insert direto, merge (upsert) ou troca de partições. A estratégia de carga define muito a performance. Partição por data costuma ser a mais eficiente pra cargas grandes — você joga os dados novos numa partição separada e depois faz o merge, em vez de atualizar linha por linha numa tabela gigante. Num projeto recente, o ADC noturno estava faltando dados de uma tabela fonte específica porque o sistema de origem tinha mudado o formato do arquivo XML sem avisar ninguém. O job rodava sem erro — o log mostrava sucesso — mas os dados simplesmente não entravam. O problema era que o parser estava caindo em silent mode, ignorando linhas que não batiam com o schema esperado. A solução foi adicionar validação de contagem de registros entre o source e o destino, com threshold mínimo configurable. Se a variação entre execuções passasse de 15%, o job disparava um alert e parava. Isso reduziu incidents do tipo de algo como quatro por mês para praticamente zero em dois meses.

Pegadinhas que iniciantes não percebem
Dependências ocultas: muitos jobs parecem independentes mas na verdade dependem de processos que rodam mais tarde no dia. Se o job A precisa dos dados do job B, e B tá agendado pra rodar depois de A, você vai ter dados incompletos toda vez. Mapear o DAG de dependências antes de configurar os horários é essencial. Fundo de mesa vs. produção: ambiente de desenvolvimento quase nunca reflete o volume real. Testar com dados reduzidos funciona pra validar a lógica, mas quando o job pega o volume completo, queries que levavam 30 segundos podem levar 40 minutos. Sempre faça teste de carga com data real antes de colocar em produção. Logging insuficiente: a maior causa de dor de cabeça não é o job falhar — é ele falhar de forma silenciosa. Se o seu log não mostra timestamp, quantidade de registros processados, tempo de execução e status de cada etapa, você vai perder horas só pra descobrir que o job não rodou direito.
QuANDO o ADC noturno NÃO funciona bem
Se o seu negócio depende de dados em tempo real pra tomada de decisão, um ADC noturno vai te decepcionar. Dados que só estão disponíveis de manhã pra decisões que precisam ser tomadas à tarde são inúteis. Nesse caso, considere uma arquitetura lambda ou pelo menos um pipeline streamming que atualize dashboards a cada hora ou em near-real-time. Também não faz sentido se o volume de dados for pequeno e as fontes forem poucas. Um job noturno com orquestração complexa, monitoramento e retry logic é overkill pra algo que poderia ser resolvido com um script simples rodando uma vez ao dia. Às vezes o problema não é a ferramenta, é a complexidade desnecessária que a gente impõe.
Ferramentas comuns do mercado
As opções mais usadas no Brasil incluem Apache Airflow pra orquestração, Talend e Informatica pra integração, e soluções cloud como AWS Glue, Azure Data Factory e Google Cloud Dataflow. Pra quem tá começando e quer algo mais leve, existem scripts Python com Apache Spark ou até mesmo jobs agendados no Windows Task Scheduler com PowerShell, dependendo da complexidade necessária. Não existe uma ferramenta única que resolva tudo. A escolha certa depende do volume de dados, da complexidade das transformações, da stack existente na empresa e da equipe disponível pra manter. Um ADC noturno mal implementado é pior que não ter ADC nenhum — gera confiança falsa nos dados e leigos acreditam que tá tudo certo até descobrirem que os números não fecham há semanas.

checklist rapido antes de colocar pra rodar
Watermark configurado corretamente? Schema validation no source? Triggers de alert configurados? Rollback ou retry logic testados? Documentação das transformações atualizada? Contagem de registros validada entre source e destino? Isso evita uns 80% dos problemas que aparecem depois. O resto é questão de experiência mesmo — e experiência, no fim das contas, é o que sobra depois que todo mundo já erraram.
Galeria
-

Saiba como funciona o ADICIONAL NOTURNO + como calcular! - YouTube -
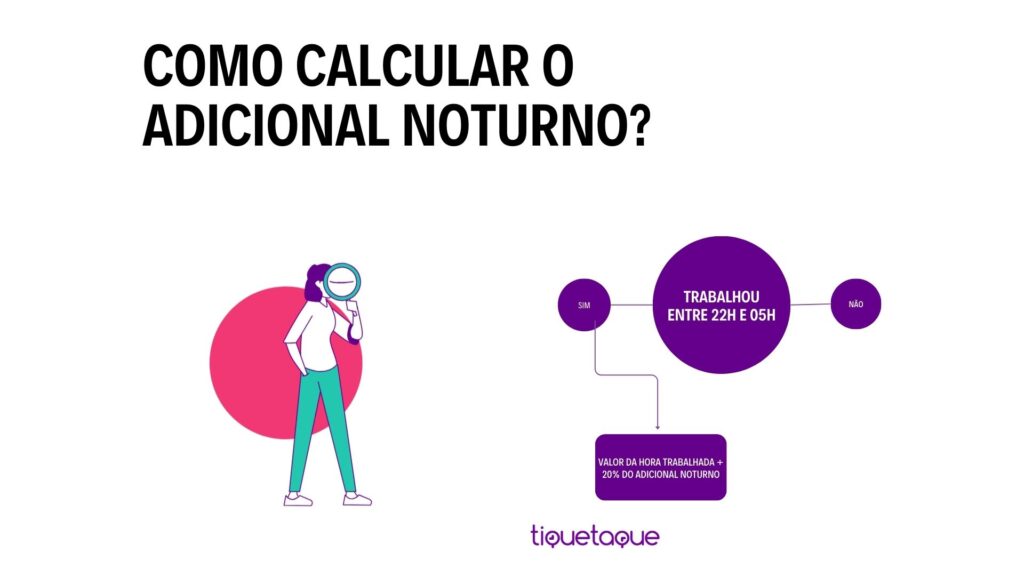
Entenda Como Funciona O Adicional Noturno E A Forma Como Calcular – KUETRV -

Adicional noturno: como funciona? | Ativa Assessoria Contábil
