Como Funciona O Transformador

O que você precisa saber antes de começar
A maioria dos tutoriais sobre como funciona o transformador começa com a analogia do tradutor atencioso olhando palavra por palavra. Isso é bonito, mas não ajuda quando você vai treinar o seu primeiro modelo e recebe loss indo para infinito no segundo epoch. O transformador é, na prática, uma máquina que aprende a pesquisar informações em si mesma, e isso tem implicações muito concretas de implementação. O transformador não usa recorrência. Esse é o ponto central que diferencia ele de LSTMs e GRUs. Em vez de processar tokens sequencialmente, ele processa todos os tokens ao mesmo tempo usando um mecanismo chamado self-attention. Isso significa que cada token no seu input consegue "ver" todos os outros tokens diretamente, sem passar por camadas recorrentes intermediárias. O mecanismo de attention calcula três vetores para cada token: query, key e value. A query representa o que o token atual está buscando. A key representa o que o token pode oferecer. O value é a informação real que será agregada. O modelo faz um produto escalar entre a query de um token e as keys de todos os outrostokens, aplica softmax nessa distribuição de scores, e usa esses pesos para fazer uma soma ponderada dos values. O token que você está analisando termina recebendo uma representação que é uma mistura informada de todo o contexto disponível.
Dentro do paper original, eles usam multi-head attention, que basicamente repete esse processo várias vezes em paralelo com projeções lineares diferentes. Cada head aprende a prestar atenção a padrões distintos. Um head pode aprender a rastrear referência pronome-antecedente. Outro pode capturar relações sintáticas. Um terceiro pode focar em dependências de longo alcance. Os resultados de todos os heads são concatenados e projetados novamente. Depois da attention vem uma feed-forward network aplicada posicionalmente, ou seja, a mesma FFN é aplicada independentemente a cada posição. Aí entra a parte posicional: como o transformador não tem ordem inerente nos tokens, eles adicionam embeddings posicionais. Originalmente, o paper usava funções senoidais. Na prática, a maioria dos modelos modernos aprende esses embeddings diretamente durante o treino. Isso é importante porque posições aprendidas tendem a funcionar melhor para downstream tasks.
A arquitetura na prática
Um transformador completo tem um encoder e opcionalmente um decoder. O encoder é empilhado com camadas idênticas, cada uma contendo multi-head self-attention e uma subcamada feed-forward, ambas com residual connections e layer normalization. O decoder adiciona uma camada extra de attention sobre a saída do encoder, o que permite que ele consulte a representação completa do input enquanto gera cada token de saída. Para tarefas de geração de texto, você usa apenas o decoder, com causal masking na attention para garantir que o token na posição i só possa ver os tokens nas posições 1 até i. Isso previene data leakage durante o treino e simula a condição de inference onde o modelo não pode ver o futuro. O training em si usa teacher forcing na maior parte do tempo: você alimenta o decoder com a sequência alvo deslocada de uma posição e treina o modelo a prever o próximo token certo. Cross-entropy loss é o padrão. O Adam optimizer com warmup linear no learning rate e decay cosine depois disso se tornou o padrão de facto para a maioria das implementações.

Problemas reais que ninguém conta
Quando eu estava configurando o treino de um modelo de linguagem médio, algo interessante aconteceu. A loss caía normalmente durante as primeiras centenas de steps, mas quando eu aumentei o tamanho do batch e habilitei gradient checkpointing para economizar memória, comecei a ver oscilações estranhas no loss que pareciam correlacionar com o tamanho do sequence length. O problema era que as posições posicionais estavam sendo normalizadas de forma inconsistente entre o treino e a inferência devido a um bug na minha implementação de causal masking — o mask não estava sendo aplicado corretamente nas posições mais distantes quando o batch size era grande o suficiente para entrar em tileamento dentro do kernel de atenção. A solução foi mais simples do que eu esperava. Eu estava usando uma implementation otimizada de flash attention que corta o sequence length em chunks, mas o código de posição absoluta não estava sendo recalibrado corretamente para cada chunk. Reescrevi a parte de embedding posicional para calcular offsets baseados no tile index e no offset global da sequência, e as oscilações desapareceram. Perdi dois dias com isso. Outro ponto que poucas pessoas mencionam: o transformador padrão é quadrático em complexidade de atenção em relação ao comprimento da sequência. Para textos longos, isso vira um problema real. Um modelo com 4096 tokens de contexto gasta 16 milhões de operações só na atenção. Existem alternativas como Linformer, Longformer e performant transformers que aproximam essa complexidade para linear, mas elas introduzem trade-offs de qualidade que vale a pena medir empiricamente no seu dataset específico.
O que funciona e o que não funciona
Transformadores funcionam excepcionalmente bem quando você tem dados suficientes. Abaixo de certas quantidades — digamos, menos de milhões de parágrafos de texto diversificado — modelos recorrentes menores podem superar transformers em accuracy absoluta porque a inductive bias de recorrencia age como regularizador. O transformador puro não tem essa vantagem. Também não funcionam bem em cenários onde a latência de inferência precisa ser extremamente baixa e o hardware é limitado. A passagem completa de attention sobre todos os tokens criados durante o treinamento precisa ser refeita em cada passo de geração durante a inference autoregressiva. Para dispositivos edge com menos de 8GB de RAM e sem GPU dedicada, isso é proibitivo. Nesses casos, modelos como DistilBERT ou TinyLlama são opções mais viáveis, ou você pode considerar arquiteturas state-space como Mamba que mantêm complexidade linear. Se o seu objetivo é entender como implementar um transformador do zero para estudo, recomendo começar com uma implementação mínima que processe apenas vocabulary de 1000 tokens e sequência de comprimento 64. Você consegue rodar isso em uma CPU em minutos. A partir daí, vá adicionando componentes: multi-head attention, positional encoding, layer norm, residual connections. Cada adição deve mostrar diferença mensurável no loss. Se algo não mostrar mudança, você provavelmente implementou errado.
Para quem quer pular direto para modelos pré-treinados, o Hugging Face Transformers library é o padrão. A API abstrai a maior parte da complexidade de implementação. Mas entenda que quando você chama model.generate(), por trás estão múltiplas rodadas de forward pass com kv-cache sendo construído incrementalmente. Sem kv-cache, a geração fica exponencialmente mais cara a cada token produzido. Ative sempre o cache de chaves e valores se for fazer geração de texto.

Galeria
-
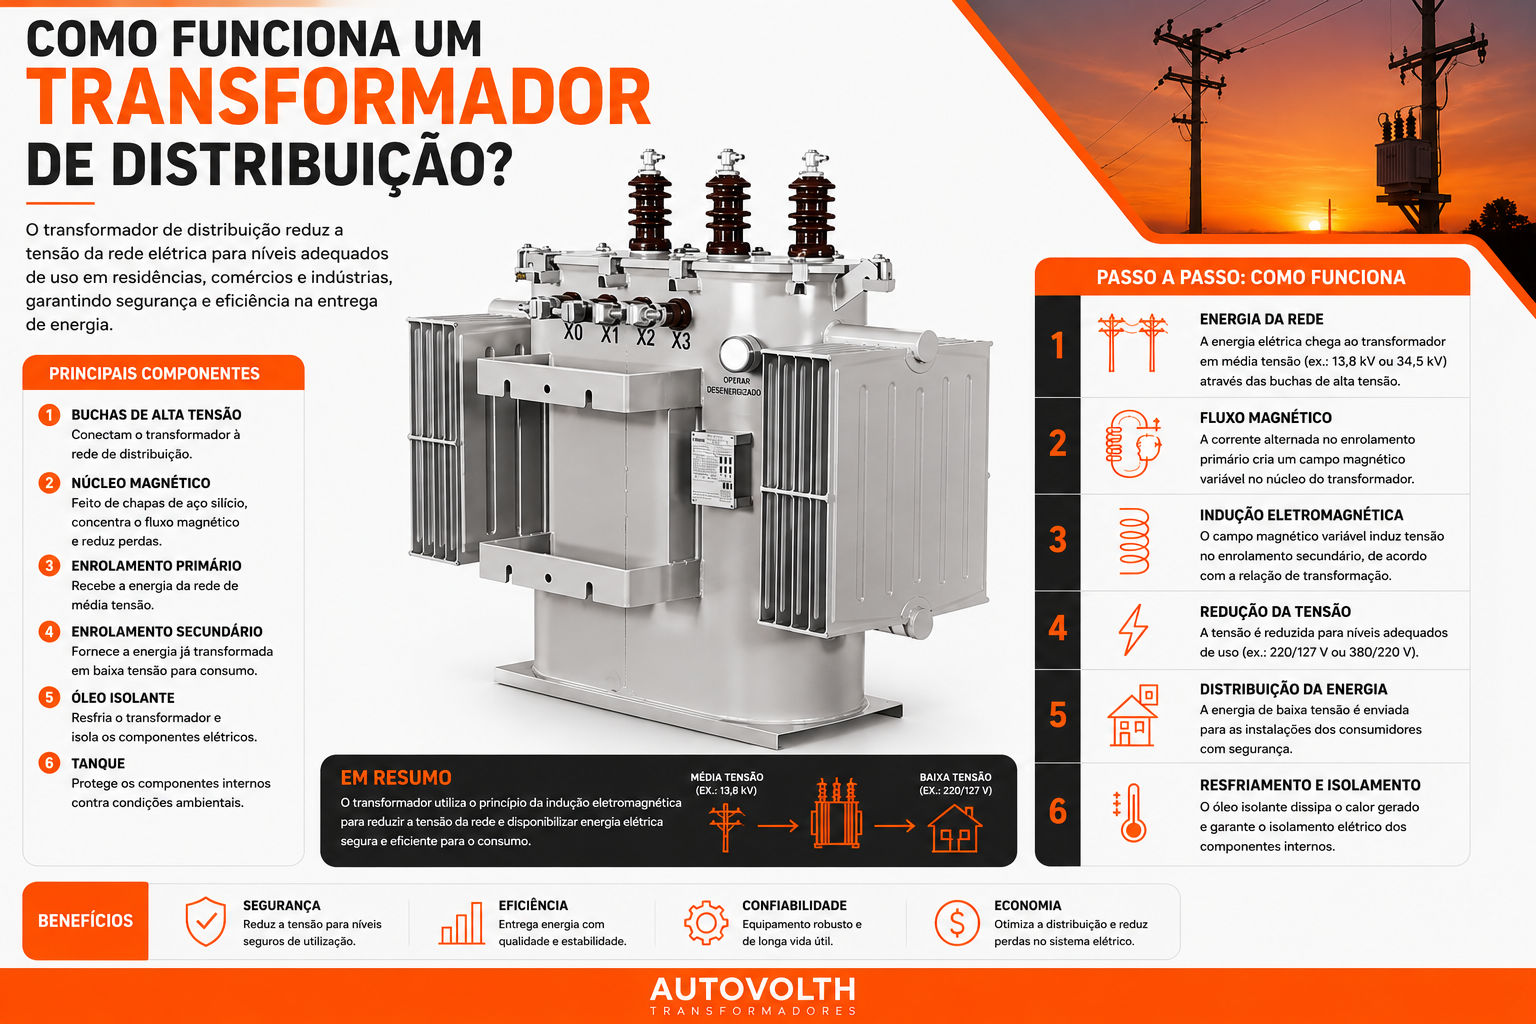
Como funciona um transformador de distribuição? -

Diagrama Rotulado Que Mostra Como Um Transformador Funciona Ilustração ... -

Diagrama De Fisica Do Transformador Bobina De Tesla: Funcionamento,
