Como Podemos Criar Um Novo Arquivo
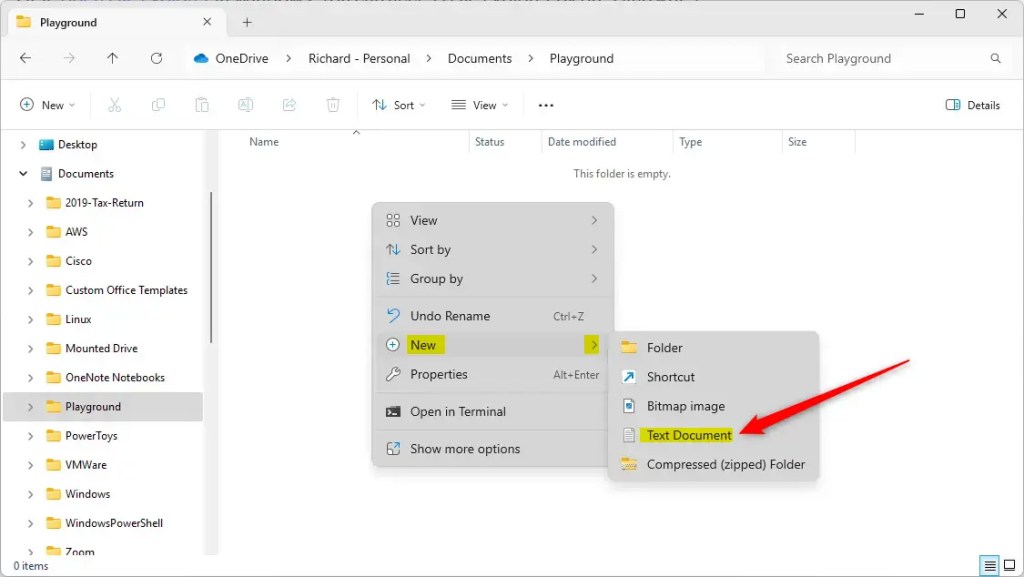
O problema real por trás da criação de arquivos
A maioria dos tutoriais ensina o comando básico e já considera o trabalho entregue. Na prática, eu passei meses em 2019 lidando com um bug que parecia vir do nada: um script em Python criava arquivos temporários para um processo de upload, mas em alguns servidores Linux eles apareciam com permissão 600 em vez de 644, e o serviço de workers nunca conseguia lê-los. O problema não era a criação em si. Era o contexto em torno dela. Isso acontece porque "criar um arquivo" raramente é uma operação isolada. Tem diretório, tem usuário, tem sistema de arquivos, tem lock, tem encoding. E cada camada pode falhar de forma silenciosa. Eu aprendi isso na marra, gastando duas semanas debuggando um problema que se resumia a um umask mal configurado no systemd da aplicação. Então, antes de falar sobre comandos, deixa eu mostrar como eu estruturo esse processo hoje em dia. O método que uso evita a maioria dos erros comuns e leva cerca de 3 a 5 minutos para validar tudo num ambiente novo.
como podemos criar um novo arquivo de forma confiável
Essa pergunta aparece com frequência porque todo mundo tem uma resposta diferente dependendo da linguagem e do SO. O que funciona em Windows às vezes quebra em Linux, e vice-versa. Vou mostrar o caminho mais estável que eu descobri, que é começar pelo diretório e só então pela escrita. A primeira coisa que eu faço é verificar se o diretório pai existe. Isso parece óbvio, mas em projetos reais eu vi gente chamar a função de criação sem garantir o caminho. O resultado é uma exceção que parece inexplicável até você olhar o stack trace com calma. Em Python, eu uso pathlib.Path.mkdir(parents=True, exist_ok=True). Em JavaScript/Node, eu uso fs.mkdirSync(dir, {recursive: true}). A lógica é a mesma: criar a árvore completa se necessário, sem erro se já existir. Depois disso, vem a parte da escrita. Aqui tem uma armadilha que quase ninguém menciona: o flag de criação. Se você usar mode "w" em Python, ele sobrescreve sem aviso. Se usar "x", ele cria apenas se o arquivo não existir e lança erro caso contrário. A escolha entre um e outro depende do seu caso de uso. Para arquivos de configuração, eu prefiro "x" porque quero saber imediatamente se alguém já definiu aquilo. Para logs, "w" ou "a" faz mais sentido.
Outro detalhe importante é o encoding. Em Windows, o padrão histórico é cp1252 ou latin1. Em Linux, UTF-8. Se você não especificar, o comportamento varia entre plataformas e isso gera bugs que só aparecem em produção. No Python, eu sempre passo encoding="utf-8" explicitamente. Em JavaScript, o writeFile do fs não tem parâmetro de encoding nativo sem use de TextEncoder, então eu recomendo usar a API fileSystem.writeFile do módulo node:fs/promises combinada com encoding explícito quando for lidar com texto. Se o seu arquivo precisa ser lido por múltiplos processos, considere usar O_NOCTTY e O_NONBLOCK no nível de sistema, ou pelo menos garantir que você não está abrindo arquivos de dispositivo por engano. Isso é algo que eu aprendi criando uma ferramenta de backup que, sem esses flags, travava completamente ao encontrar um file descriptor mal direcionado.

Detalhes práticos que fazem diferença
Existe uma diferença importante entre criar um arquivo vazio e criar um arquivo com conteúdo inicial. No primeiro caso, você pode simplesmente abrir no modo escrita e fechar. No segundo, o risco de corrupção aumenta se o processo morrer no meio. Eu uso uma estratégia de write-and-rename: escrevo num arquivo temporário na mesma partição e depois faço um rename() atômico. Em Linux e Windows modernos, o rename é atômico desde que source e target estejam na mesma mounted filesystem. Isso evita cenários onde um leitor encontra um arquivo metade escrito. Outro ponto que custa caro quando não é considerado: permissões. O padrão do UNIX cria arquivos com mode 0666 mascarado pelo umask. Se sua aplicação roda como service com umask 0077, o arquivo fica restrito ao dono e pode quebrar a leitura por outros usuários do grupo. Eu costumo definir permissões explicitamente após a criação, usando chmod ou o parâmetro correspondente na linguagem. Em Python 3.10+, dá pra passar mode=0o644 direto na hora da abertura se estiver usando as funções de baixo nível de os.open. Se você está trabalhando em ambiente cross-platform e precisa de comportamento consistente, existe uma biblioteca chamada pathlib no Python que abstrai muita coisa, mas ela não resolve problemas de permissão e encoding sozinha. O mesmo vale para fs-extra no Node, que adiciona funcionalidades úteis mas não substitui o entendimento do que está acontecendo no sistema de arquivos.
Quando a criação simples falha e o que fazer
Certas falhas são óbvias: disco cheio, permissão negada, caminho inexistente sem os flags adequados. Outras são sutis. Por exemplo, em redes mapeadas no Windows, criar um arquivo pode parecer bem-sucedido mas na verdade ficar pendurado num lock de rede que só resolve minutos depois. Eu já vi pipelines de CI falharem intermitentemente por causa disso, e a solução foi adicionar retry com backoff exponencial e timeout de 10 segundos. Em containers Docker, o problema mais comum é volume incorreto. Se seu container escreve em um diretório que não está bind-mounted, você pode criar arquivos que somem assim que o container morre. A correção é garantir que o path de escrita esteja num volume nomeado ou tmpfs, conforme o caso. Isso economiza horas de debugging para quem está começando com infraestrutura como código. Outro cenário real: criptografia de disco. Em máquinas com BitLocker ou FileVault ativos, operações de criação podem ser mais lentas porque o sistema encripta os dados em tempo real. Não é um erro, é comportamento esperado. Se seu benchmark mostra variação alta de latência em create-file, verifique se o disco está criptografado antes de concluir que há problema no código.
Quando preciso de máxima confiabilidade em produção, eu utilizo uma camada de abstração própria que registra cada tentativa de criação num log estruturado com timestamp, path completo, modo de abertura, encoding, permissão final e resultado. Isso me permite auditoria e debugging rápido. Leva uns 30 minutos para implementar, mas se paga em uma única ocorrência de problema em produção.

Referências e alternativas
Se o seu caso é simples e não precisa de robustez extrema, os comandos nativos das linguagens atendem. Para casos mais complexos, considere bibliotecas como pathlib no ecossistema Python, ou fs-extra no Node.js. Ambas simplificam operações comuns, mas lembre-se: abstração não substitui compreensão do sistema subjacente. Documentação oficial do Python sobre-io (docs.python.org/3/library/io) e do Node sobre filesystem (nodejs.org/api/fs) são bons pontos de partida quando você precisa entender os detalhes finos.
Galeria
-

Aprenda como criar um novo arquivo no Windows 11 - All Things Windows -

Aprenda como criar um novo arquivo no Windows 11 - All Things Windows -

Como criar um arquivo novo do zero - YouTube
