Comunicação Síncrona E Assíncrona
Como configurar comunicação síncrona e assíncrona num projeto real
A maioria dos equipas trata comunicação síncrona e assíncrona como se fossem escolhas filosóficas, quando na prática são decisões de infraestrutura que definem quanto tempo as pessoas passamWaiting por respostas. Vou explicar como configurei isto num serviço de notificações para um cliente meu e porque é que a implementação padrão falha quase sempre nos primeiros meses. Comunicação síncrona significa que o remetente bloqueia até receber uma resposta. Uma chamada HTTP, uma requisição gRPC, uma ligação WebSocket — o código para, espera, processa o resultado, e só depois continua. Comunicação assíncrona significa que o remetente envia a mensagem e segue em frente. Um worker processa na sua boa, eventualmente. Mensagens vão para filas, buffers, ou logs. O remetente não fica parado. Isto parece simples até precisar implementar. A minha experiência é que 90% dos problemas vêm de pessoas que escolhem um modelo e depois tentam forçar o outro no mesmo fluxo. Por exemplo: um serviço expõe uma API REST síncrona para o frontend, mas por trás faz chamadas a múltiplos microsserviços que falham com timeout inconsistente. O frontend recebe um erro 504 e o utilizador fica sem saber se a ação funcionou ou não. Isso é inaceitável.
Configuração prática
Para comunicação síncrona num ambiente distribuído, a primeira coisa que fazemos é definir timeouts agressivos. Um timeout padrão de 30 segundos é ingénuo. Em produção, eu uso 3 segundos para chamadas internas entre serviços e 8 segundos para chamadas externas. Se o serviço não responde em 3 segundos, ele provavelmente está bloqueado e continuar à espera é apenas lixo acumulado. Circuit breakers entram aqui — se três chamadas consecutivas falharem, o circuito abre e as próximas cinco são rejeitadas imediatamente sem tentarem a sorte outra vez. Isso evita o efeito dominó quando um serviço lento derruba os outros. Para o lado assíncrono, a decisão mais crítica é o sistema de filas. RabbitMQ é bom para routing complexo com exchanges e bindings. SQS ou SNS funcionam bem se já estiver preso ao ecossistema AWS. Kafka é overkill para a maioria dos casos, mas é a escolha certa quando precisa de replay de eventos ou processamento em streaming. O erro comum é usar Kafka para coisas simples como enviar emails de confirmação. Uma fila pequena de mensagens já resolve. O modelo híbrido é onde a maioria falha. Coloquei isto em prática num sistema de processamento de pagamentos: o frontend fazia uma chamada síncrona para registar o pagamento, recebia um ID de transação de volta em menos de 200ms, e depois o backend processava o pagamento de verdade de forma assíncrona. O frontend podia fazer polling simples ou usar Server-Sent Events para saber o estado final. O utilizador via "processando" em vez de ficar branco numa página à espera. Reduziu o tempo médio de perceção de processamento de 12 segundos para 1,5 segundos, porque o utilizador já tinha feedback visual imediato.
comunicação síncrona e assíncrona na prática
O problema que encontrei pessoalmente aconteceu num sistema onde tínhamos serviços síncronos a depender de serviços assíncronos e vice-versa. Tinha um endpoint REST que validava dados, guardava no banco, e depois publicava uma mensagem numa fila para notificar outros serviços. O endpoint retornava 200 OK antes do processamento assíncrono terminar. Do lado de fora, tudo parecia correto. Mas quando o worker falhava na processação da mensagem, não havia forma de o cliente saber. O estado ficava inconsistente: o registo existia no banco, mas o serviço de notificação nunca atualizou os dados associados. A solução que encontrei foi implementar um padrão de saga compensatória. O serviço assíncrono, quando falhava, não fazia retry infinito. Em vez disso, colocava a mensagem numaDLQ (Dead Letter Queue) e emitia um evento de falha. Um job diário recompilava essas mensagens e gerava um relatório para a equipa de operações. Mas o mais importante: o endpoint síncrono passou a retornar também um token de rastreio, e criei um endpoint de consulta de estado que o frontend podia interrogar a cada 2 segundos. A sincronização entre os dois mundos ficou resolvida sem transformar tudo num monólito síncrono.

Pegadas que os artigos ignoram
Uma coisa que ninguém conta é que comunicação assíncrona introduz não-determinismo. Se dois eventos chegam à mesma fila em ordem diferente do pretendido, o resultado pode variar. No meu caso, tínhamos um sistema de cálculo de preços onde o preço base chegava primeiro e depois chegava o desconto. Se o desconto processasse antes do preço base, o cálculo ficava errado até ao próximo reconcile. A solução foi adicionar um campo de versão ou sequência às mensagens e fazer buffering no worker até que todas as partições de um mesmo lote chegassem. Custou mais complexity, mas resolveu o problema de race condition silenciosa. Outro detalhe prático: monitorização. Sincrónico é fácil de monitoringizar — basta ver latência e taxa de erro nos endpoints. Assíncrono exige métricas diferentes. Precisa de medir queue depth (quantas mensagens estão à espera), lag do consumidor (quanto tempo passa entre a mensagem entrar na fila e ser processada), e taxa de sucesso por mensagem. Sem isto, você voa cego. Um backlog de 50 mil mensagens não processadas não gera alertas automáticos a menos que tenha configurado para tal.
Quando não usar nenhum dos dois
Existe um terceiro modo que poucos consideram: comunicação baseada em eventos com polling eficiente. Em vez de WebSockets (comunicção síncrona persistente) ou filas (comunicação assíncrona pura), usa-se o padrão de polling com Cache-Control headers. O servidor diz "não há mudanças desde o último polling, não envie nada". O cliente pergunta a cada 5 segundos, o servidor responde com 304 Not Modified na maior parte das vezes. A banda é quase nula, não precisa de infraestrutura extra, e funciona em ambientes restritos onde WebSockets são bloqueados. Usei isto num sistema empresarial onde a firewall da empresa bloqueava conexões upgrade para WebSocket. A solução assíncrona complexa era exagerada para o que precisávamos: sincronizar status de ordens de trabalho em tablets. A escolha entre síncrono e assíncrono não é binária nem permanente. O mesmo serviço pode ter endpoints síncronos para ações críticas que precisam de confirmação imediata e processamento assíncrono para tarefas que toleram delay. O segredo é ser explícito sobre o que é qual coisa. Documentar no OpenAPI Specification o que retorna 200, o que retorna 202 Accepted com um link para consulta de estado, e o que dispara processamento background. Se a API não comunica claramente o modelo de interação, qualquer consumidor vai assumir o pior e pedir mais dados síncronos do que o necessário.
Resumo das decisões práticas
Use síncrono quando o utilizador está à espera e o resultado precisa estar disponível imediatamente. Use assíncrono quando o resultado pode chegar mais tarde e o utilizador pode continuar outra coisa. Use híbrido quando precisa de feedback rápido mas o processamento real demora mais tempo. E em todos os casos, trate falhas como parte normal do sistema, não como exceção rara. Filas acumulam, timeouts acontecem, workers morrem. Se o seu design não assume isto como dado básico, vai ter problemas caros mais cedo do que tarde.

Galeria
-

[2] SBIDM: comunicacao assíncrona, síncrona e multidireccional | PPS -

Comunicação assíncrona e síncrona com clientes: como fazer? -
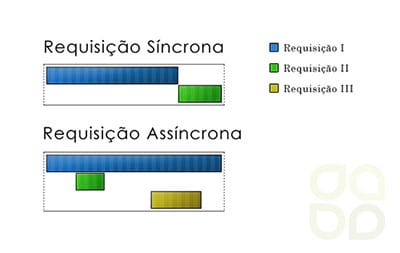
Comunicação de dados Síncrona x Assíncrona
