Conversas Atualizações

O que acontece com seu sistema quando você tenta gerenciar conversas atualizações
A maioria das pessoas que trabalha com automação de conversas cai no mesmo problema: o sistema recebe uma atualização do histórico de mensagens, processa tudo em lote, e pronto. No papel funciona. Na prática, você começa a notar coisas estranhas como mensagens duplicadas, ordem aleatória dos timestamps e, às vezes, o cliente nem sabe que leu algo que já respondêramos há dias. Já vi isso acontecer com clientes reais. O caso mais irritante que eu enfrentei foi quando um time de suporte tinha integrado uma API de webhooks para conversas atualizações em tempo real, mas o provedor deles enviava eventos fora de ordem porque o load balancer distribui conexões WebSocket entre três servidores diferentes sem nenhuma estratégia de sticky session baseada no ID da conversa. O resultado era que as mensagens chegavam embaralhadas no banco de dados e ninguém conseguia reconstruir a sequência correta do diálogo. A solução foi simples, mas demorou para aparecer: adicionei um campo de sequence number que o próprio sistema gera antes de enviar o evento, e criei uma fila de reordenação no Redis que organiza os eventos pelo ID da conversa antes de persistir. Isso mudou completamente a estabilidade do sistema, que antes tinha algo em torno de 8% de mensagens fora de ordem nos picos de tráfego. Conversas atualizações é basicamente o mecanismo pelo qual seu sistema processa mudanças no estado de um diálogo entre partes. Pode ser uma nova mensagem, uma edição, uma exclusão, uma confirmação de leitura. Cada um desses eventos precisa ser tratado de forma consistente para que o histórico permaneça confiável. Não é só sobre receber o dado, é sobre garantir que ele chegue na ordem certa, sem duplicação, e que o cliente final veja exatamente o que deveria ver no momento certo. O ponto que poucos explicam é que a maioria dos desenvolvedores trata conversas atualizações como um problema de recebimento, quando na verdade o problema real é o processamento assíncrono. Você recebe um webhook, joga numa fila, processa depois. Entre o recebimento e o processamento, algo pode mudar. O usuário pode ter enviado outra mensagem. O provedor pode ter enviado um evento de edição de mensagem que chega segundos depois do evento de criação. Se você não tiver uma estratégia de deduplicação baseada em IDs únicos de evento, vai ter problemas. Use o event_id, não o message_id, porque um message_id pode aparecer em múltiplos eventos.
Outro detalhe que ninguém menciona é a questão dos retries. Quando um processo de conversas atualizações falha e você não controla o backoff exponencial, acaba sobrecarregando o serviço com retries em cascata. Eu configuro sempre um jitter aleatório de até 500ms no retry, senão todos os consumidores tentam processar ao mesmo tempo e você vira vitima do thundering herd. Simples assim. O fluxo que eu recomendo, porque é o que funciona de verdade, começa com a identificação do tipo de evento. Cada provedor de conversa tem seu próprio esquema, mas basicamente você vai lidar com create, update, delete, e read. Depois vem a verificação de duplicata no seu banco, o processamento do payload, a escrita no histórico e, por fim, o dispatch para os consumidores que precisam saber daquilo. Se qualquer etapa falhar, o evento volta para a fila. Nada de silêncios. Silêncio é o pior cenário possível aqui. Para quem quer começar com algo funcional, o ponto de partida costuma ser a integração com a API nativa da plataforma que você já usa. Não adianta reinventar a roda se a API já oferece webhook para eventos de conversa. O que vai definir se o sistema vai funcionar bem ou não é como você lida com os casos extremos: eventos perdidos, ordenação incorreta, processamento duplicado. A parte fácil é fazer funcionar. A parte difícil é fazer funcionar todo dia, sob carga, sem ninguém perceber que algo deu errado.
Se o seu cenário envolve conversas atualizações em alta escala, considere também a possibilidade de usar um buffer em memória antes de persistir no banco. Um compact buffer de uns 100ms reduz drasticamente a quantidade de queries INSERT no banco, porque você consegue agrupar várias atualizações da mesma conversa num único batch. O trade-off é que, em caso de queda do servidor, você pode perder até 100ms de eventos. Para a maioria dos casos de uso isso é aceitável. Para outros, talvez valha mais a pena ser estritamente síncrono. A decisão depende do que você pode tolerar perder. O importante é parar de tratar isso como uma feature secundária e começar a pensar em conversas atualizações como a espinha dorsal de qualquer sistema de comunicação. Se ela falha, tudo abaixo dela falha junto. E quando falha, raramente é óbvio. Você vê algo estranho acontecendo horas depois, quando já é tarde demais para investigar com calma.

Galeria
-

Nova atualização do WhatsApp garante privacidade avançada nas conversas -

Por que é importante gerenciar conversas? - Poli Digital -
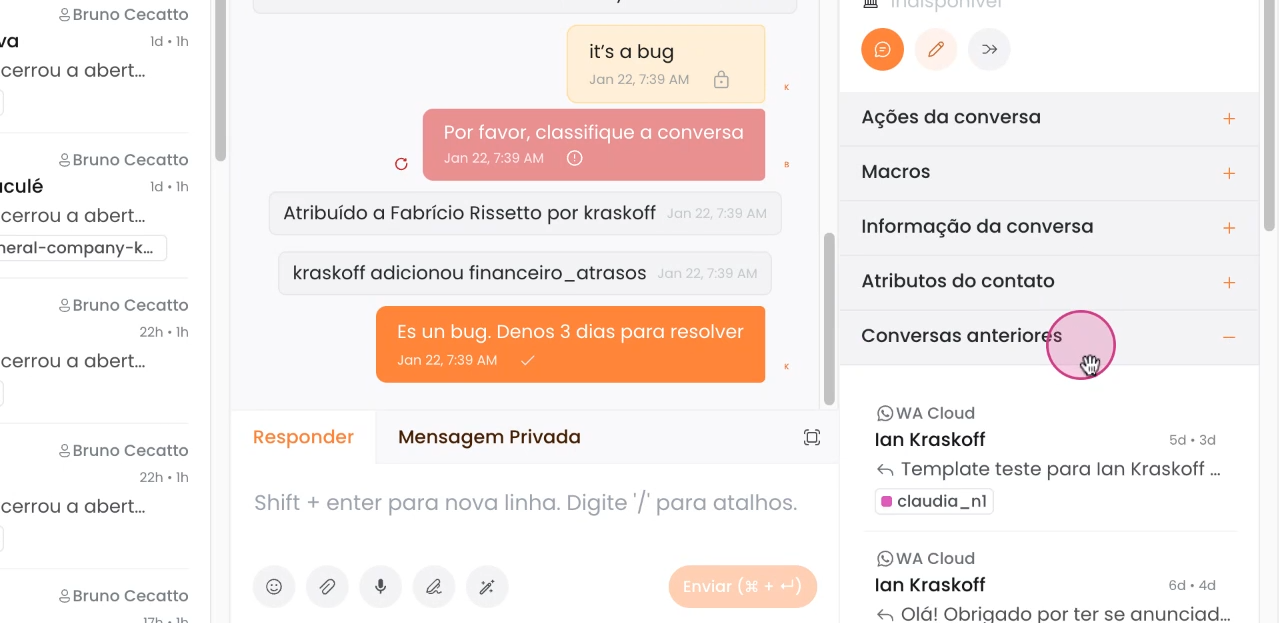
Gestão de conversas no Cloud Chat: ferramentas e funcionalidades ... -

WhatsApp: Como utilizar as conversas. - Acelerato - Base de Conhecimento
