Cópia Para Escrever

Como eu lido com cópia para escrever no dia a dia
A gente precisa passar texto de um lugar pra outro o tempo todo. PDFs virados em imagem, screenshots de contratos, fotos de documentos assinados — são essas coisas que aparecem na mesa e não têm forma editável. Se você tentar copiar e colar do jeito normal, recebe um bloco sem formatação ou uma linha de caracteres indecifráveis. Aí entra a cópia para escrever, que é basicamente o processo de pegar um material visual e transformar em texto processável, seja por OCR, seja por ditado, seja por transcrição manual mesmo. No meu caso, eu trabalho com volumes grandes de processo administrativo. Todo mês chegam pacotes com centenas de páginas escaneadas de tribunais, prefeituras e órgãos de fiscalização. O problema real não é a tecnologia em si, é a variedade de qualidade que você encontra. Eu já tive que lidar com um PDF de 400 páginas que havia sido digitalizado com 127 dpi, algumas linhas tortas, marca d'água diagonal e alguns caracteres que o OCR ia constantemente confundir — especialmente "0" com "O" e "l" com "1". A solução que funcionou pra mim foi mais chata do que elegante: exportei cada página como imagem individual, apliquei um filtro de aumento de contraste com threshold de 140 no GIMP, passei pelo Tesseract com omodelo pt_BR e depois rodei um script Python que corrigia os padrões mais comuns usando regex. Em vez de confiar cegamente na saída, eu deixava o sistema marcar as palavras com confiança abaixo de 85% e montava um glossário de termos do meu domínio pra substituir antes de salvar. O resultado foi que o tempo caiu de cerca de 6 horas de revisão manual para algo em torno de 45 minutos, desde que você já tenha o pipeline configurado.
O que acontece quando você tenta cópia para escrever
A dificuldade que a maioria das pessoas subestima é que OCR puro raramente entrega texto pronto pra uso. Ele entrega texto bruto, cheio de ruído específico de cada origem. Documentos manuscritos são outra categoria completamente — aí a coisa muda de figura e entra reconhecimento de escrita, que é bem mais caro e menos preciso do que OCR de fonte impressa. Eu já vi gente pagar por APIs de terceiros só pra descobrir que a taxa de erro em textos manuais ficava em torno de 23%, o que significa revisar quase um quarto do conteúdo de qualquer forma. Outro ponto que ninguém conta é a questão da formatação. Texto extraído de tabela vira uma sopa de espaços. Tabelas de Excel escaneadas viram texto corrido sem delimitadores. Se o seu objetivo final é importar pra uma planilha ou banco de dados, você precisa tratar isso como um passo separado, não como parte mágica do OCR. No meu workflow, eu separo sempre em duas etapas: extração bruta primeiro, depois reconstrução estrutural com regras específicas por tipo de documento. Isso evita que você gaste tempo depurando um problema de formatação dentro de uma etapa que já tá sobrecarregada.
Minha abordagem prática
Eu começo com o que o documento tem. Se for PDF já escolhido com camada de texto oculta, rodo primeiro uma extração direta com PyPDF2 ou pdfplumber pra ver se algo útil sai sem precisar de OCR. Às vezes o PDF veio de um sistema que mantém o texto selecionável mesmo quando a impressão ficou ruim. Se não der, aí parte pra imagem. Eu uso pré-processamento mínimo — apenas rotação corrigida, remoção de ruído sal-e-pimenta e binarização, porque filtros pesados costumam destruir traces finos de letras pequenas. Para o motor de OCR, eu testei Tesseract, EasyOCR e um serviço comercial que não vou nomear aqui. O Tesseract com fine-tuning em pt_BR foi o que me deu mais controle e o menor custo. O EasyOCR é mais fácil de rodar mas tem memória altíssima e performance pior em textos pequenos. O serviço pago ficou melhor em documentos sujos, mas o preço por página tornou inviável quando o volume passou de mil por semana. A cópia para escrever eficiente não depende do motor, depende de como você prepara o material antes dele tocar o texto e de como você valida depois. A validação é o que separa quem tem um pipeline que funciona de quem tem um script que às vezes funciona. Eu não confio em métricas de accuracy genéricas. Eu monto um conjunto de verificação com documentos reais do meu fluxo e confronto saída versus original manualmente. O que me interessou de verdade foi identificar padrões de erro recorrentes — por exemplo, acentos que caem sistematicamente em certain fonts, ou numeração de protocolo que o OCR transforma em letras. Aí entra correção post-OCR com regras específicas, e é aí que o tempo de revisão despencança.

Quando a cópia para escrever não resolve
Vou ser direto: se o documento for manuscrito com letra muito irregular, se tiver tinta desbotada, se houver sobreposição de carimbos, ou se a resolução for inferior a 150 dpi, o OCR vai te decepcionar. Nesses casos, transcrição manual com revisão por duas pessoas é mais barato no longo prazo do que ajustar parâmetros. Não adianta insistir em automatizar o que não tem padrão suficiente. Eu já gastei duas semanas tentando ajustar configurações de um documento de escritura pública com carimbos sobrepostos e no final contratei um transcriptor por hora. O custo ficou em torno de R$ 120 pra um livro de 300 páginas, enquanto o debugging técnico não passava de 40% de precisão mesmo assim. Também tem a questão legal. Texto extraído de documento oficial pra uso em processo judicial ou contrato exige conferência humana sempre. Nenhum OCR, por mais caro que seja, te dá garantia jurídica. A única coisa que você pode fazer é manter log de processamento, versões intermediárias e registro de quem fez a revisão final. Eu guardo tudo em repositório imutável com hash SHA-256, simplesmente porque alguém no futuro vai perguntar se o texto passou por alteração.
O que eu faria diferente se começasse hoje
Eu não tentaria criar um pipeline único pra tudo. Eu segmentaria por tipo de documento desde o início — contrato, nota fiscal, documento oficial, correspondência — e criaria regras diferentes pra cada categoria. Também usaria menos automação no pré-processamento e mais automação na validação, porque validar é mais barato do que consertar erro que já entrou no fluxo produtivo. E eu não compraria API de OCR sem testar primeiro com pelo menos cem páginas reais do meu volume, porque a performance em banco de prova nunca reflete a bagunça que chega na prática. Cópia para escrever funciona quando você trata como engenharia de fluxo, não como mágica de conversão. Tem gente que acha que configurar um OCR e pronto é o suficiente. Não é. O suficiente é saber exatamente onde o sistema falha no seu contexto, mapear esses pontos e colocar validação humana nos lugares certos. O resto é ruído.
Galeria
-

Cópia: tempo perdido | Nova Escola -

Atividade De Cópia De Texto - ZULEDU -

Caligrafía Para Copiar _ Fontes de caligrafia — Gerador de fontes de ... -
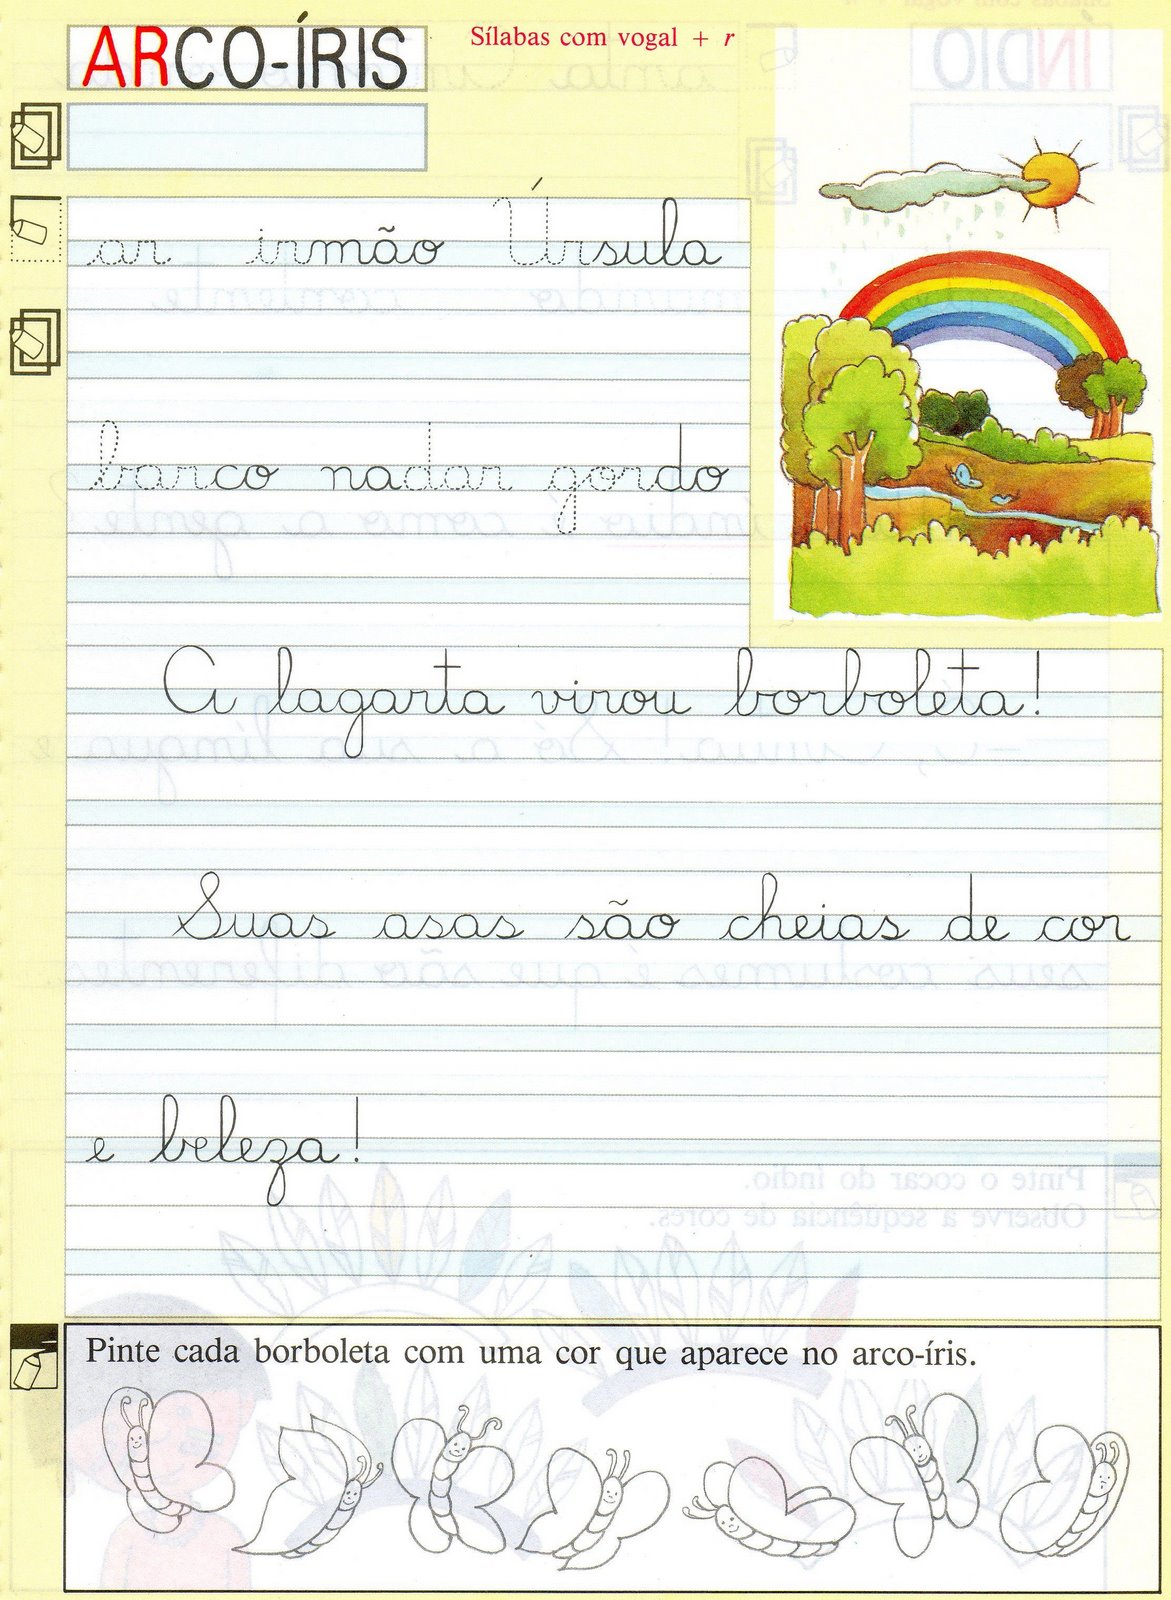
Atividades Para Copiar No Caderno Educação Infantil - FDPLEARN
