Criação De Tabelas Campos E Regras É Classificada Como

O que acontece quando você precisa criar tabelas, campos e regras num projeto real
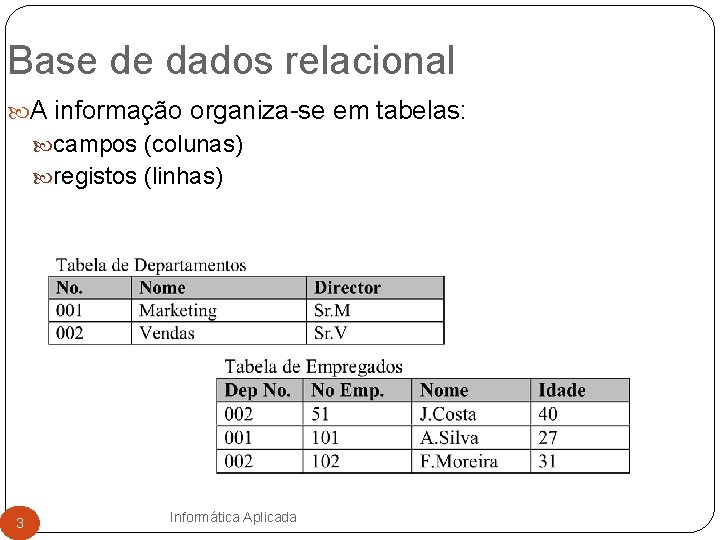
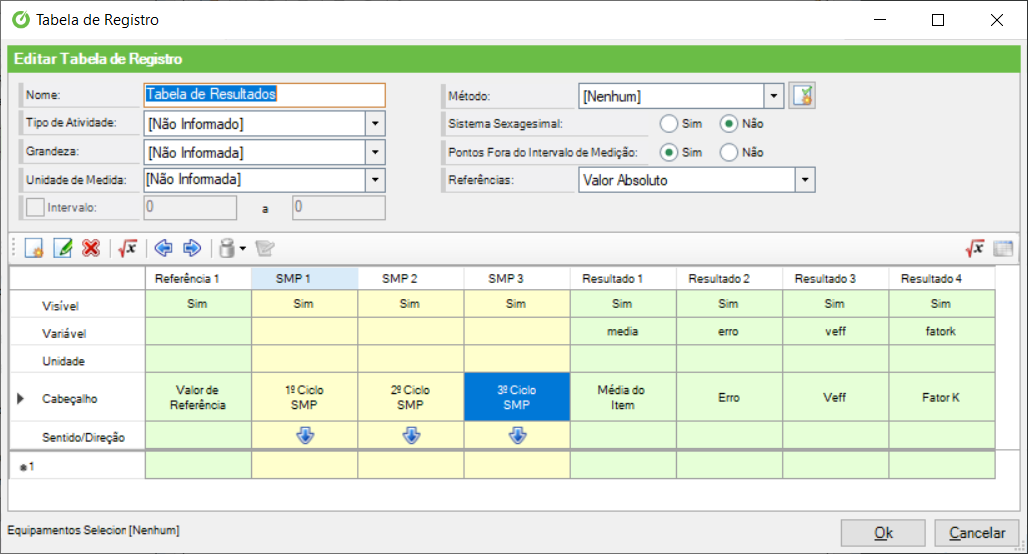
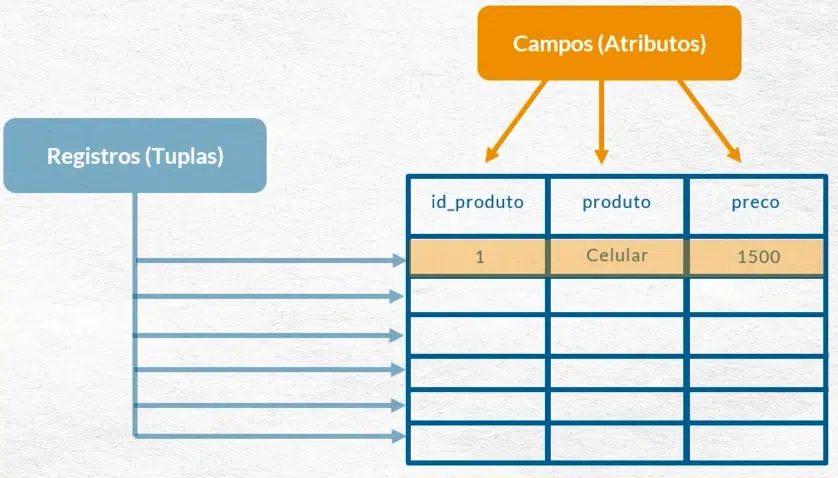
Muita gente trava na hora de saber como categorizar isso. A resposta curta, do jeito que aparece em requisitos, licitações e documentação técnica, é que a criação de tabelas campos e regras é classificada como desenvolvimento de banco de dados ou engenharia de dados, dentro do escopo de modelagem estrutural de informações. Mas quando você abre o projeto no dia a dia, a coisa é mais embaraçada. Na prática empresarial brasileira, especialmente em sistemas corporativos como ERPs e plataformas de gestão, essa atividade cai em uma categoria híbrida que envolve três camadas: estrutura (tabelas e campos) e comportamento (regras). A classificação mais comum em editais e contratos é a de desenvolvimento de software com viés de dados, ou simplesmente desenvolvimento de base de dados. O que significa que quem trabalha nisso precisa dominar tanto SQL quanto a lógica de negócio que vai empacotar. Eu vi muita equipe errar a classificação no início de um projeto porque achava que só criar a estrutura já era suficiente. O campo existe, a tabela existe, mas a regra que valida o dado não existe. Aí na homologação você descobre que o sistema aceita valores impossíveis, duplicatas, datas que não fazem sentido. Só então percebe que a classificação deveria ter contemplado as regras desde o início.
Um detalhe que poucos mencionam em manuais: a criação de regras nunca é apenas técnica. Regra de negócio sobre campo de tabela pode conflitar com regra de outra tabela. Eu tive um caso em que uma validação de data de vencimento numa tabela de financeiro colidia com uma regra de integridade referencial numa tabela de cadastros. O conflito gerava erro silencioso em produção, porque umaTrigger sobrescrevia o valor sem avisar ninguém. A solução foi mapear todas as regras com dependências cruzadas antes de subir qualquer coisa, usando um documento de traceabilidade entre regra, tabela e campo.
Como fazer isso sem perder tempo
O fluxo que funciona, pelo menos no meu contexto, começa com a definição do domínio. Antes de abrir qualquer ferramenta de modelagem, você precisa saber o que aquela tabela representa e quais regras afetam diretamente o usuário final. A maioria das equipes pula esse passo e vai direto para o DDL. Resultado: tabela bonita no diagrama que não serve pra nada porque a regra não foi pensada. Depois do domínio definido, a sequência adequada é mais ou menos essa:

- Lista de entidades e relacionamentos, mesmo que grosseira.
- Definição dos campos com tipos adequados, não tipos genéricos.
- Especificação das regras de validação, cada uma vinculada ao campo e à entidade.
- Revisão de integridade referencial e constraints.
- Implementação em ambiente de desenvolvimento com versionamento.
O passo mais ignorado e que mais gera dor de cabeça é o terceiro. Regra sem vínculo claro com campo e tabela vira um problema não rastreável. Quando o usuário reclama que algo não funciona, você gasta horas caçando qual regra quebrou porque ninguém documentou a ligação. Tipos de campo parecem coisa secundária, mas são a principal fonte de erro em projetos pequenos e médios. Colocar VARCHAR em campo que deve ser numérico resolve rápido mas destrói performance e integridade. Use DECIMAL para valores monetários, DATE ou DATETIME para datas, e evite campos varchar quando um tipo específico resolve. Eu já vi projeto inteiro passar por refatoração só porque o campo de CPF tinha sido criado como texto genérico. A validação de formatação tinha que ser feita via regra customizada, o que era muito mais lento do que usar um tipo adequado com restrição de pattern nativa. Outro ponto que ninguém advertiu antes eu fazer: regra de validação dentro da aplicação versus regra no banco. Regra no banco protege contra inconsistência, mesmo que a aplicação tenha bug. Regra só na aplicação deixa a porta aberta para inserts diretos via scripts, queries manuais ou APIs que ninguém conhece. O ideal é colocar as regras críticas no banco como constraints, e manter a validação na aplicação para dar feedback visual ao usuário. Dupla camada funciona bem, desde que a lógica não se contradiga.
Limitações e cenários onde essa abordagem falha
Modelagem cuidadosa de tabelas, campos e regras não é bala de prata. Em ambientes com alta variabilidade de requisitos, como startups que pivotam rápido, a sobrecarga de documentação e versionamento pode travar o desenvolvimento. Nesses casos, modelos mais flexíveis com esquema flexível ou NoSQL podem ser mais viáveis, ainda que imponham custo posterior de normalização. Também vale lembrar que ferramentas automatizadas de geração de DDL ajudam, mas elas não criam regras de negócio. Ferramenta gera a estrutura com base no diagrama, não a lógica que faz o sistema funcionar corretamente. A parte mais trabalhosa continua sendo humana: pensar, documentar e validar as regras.
Resumo da parte prática
A criação de tabelas campos e regras é classificada como desenvolvimento de banco de dados com foco em modelagem estrutural e regras de negócio. O diferencial entre um projeto que funciona e um que dá problema crônico está na forma como as regras são vinculadas aos campos e como a integridade é tratada desde o início. Documentação de traceabilidade, escolha de tipos adequados e dupla camada de validação resolvem a maior parte dos problemas que vejo aparecerem tarde demais.
Galeria
-
Como elaborar tabelas na Atividade/Método -

PPT - Laboratório de Programação I PowerPoint Presentation, free ... -
Banco de Dados e SQL - Introdução Completa
