Das Palavras A Seguir

Entendendo o processo de extração e seleção de palavras a seguir
Muita gente que trabalha com processamento de texto, transcrição ou análise linguística se depara com a necessidade de isolar das palavras a seguir um determinado marcador, palavra-chave ou padrão dentro de um bloco maior de conteúdo. O conceito em si é simples na teoria, mas a execução prática traz certas finezas que só aparecem depois de sujar as mãos com arquivos reais. Vou explicar como isso funciona no dia a dia, sem circunlóquios. A abordagem mais comum envolve dividir o texto por delimitadores conhecidos, identificar o segmento relevante e extrair apenas os termos que se encaixam nos critérios estabelecidos. Ferramentas nativas de Python com regex, ou até mesmo scripts em bash com grep e awk, resolvem grande parte dos casos. Quando o volume sobe, aí você precisa pensar em performance.
das palavras a seguir: o que realmente importa
O cerne da questão não é a ferramenta em si, mas entender o que você está buscando. Se o objetivo é, por exemplo, extrair termos técnicos das palavras a seguir a uma lista de definições, o padrão de busca precisa ser ajustado para cada contexto. Palavras-chave soltas retornam ruído. Ajustar o contexto com limites de linha, tags HTML ou estruturas JSON muda completamente a precisão. Uma coisa que poucos mencionam: a ordem das palavras importa mais do que você imagina. Em textos técnicos, especialmente manuais e documentação de API, a sequência lógica segue um padrão que pode ser explorado. Se você sabe que certo termo sempre aparece após um campo específico, como "Descrição:" ou "Output:", pode usar isso como âncora no pattern. Isso reduz drasticamente falsos positivos. Aqui vai um exemplo prático que vivenciei recentemente. Tinha um arquivo de log de deployment com mais de 40 mil linhas, e precisava extrair todos os nomes de pacotes que apareciam das palavras a seguir à marcação "[INSTALL]". As tentativas iniciais com grep simples traziam linha inteira, o que gerava um pós-processamento enorme. A solução foi usar uma expressão regex com capture group: \[INSTALL\]\s*(\S+). Isso isola diretamente o pacote, sem texto supérfluo. O script rodou em cerca de 8 segundos num notebook comum, contra os 3 minutos que levaria com abordagem ingênua.
Outro ponto que merece atenção são os casos edge. Texto mal formatado, quebras de linha inesperadas, palavras separadas por hífen ou espaço irregular. Num projeto recente, me deparei com uma lista de términos onde a pontuação vinha colada sem espaço — "erro:conectividade" em vez de "erro: conectividade". O regex que funcionava perfeitamente no teste falhava em produção porque não estava preparado para esse formato. A correção foi simples, mas só apareceu depois de rodar com dados reais: adicionar [:\s]* antes do termo alvo no padrão de busca. Se você está começando agora, evite a armadilha de confiar cegamente em soluções prontas de IA para extração de texto. Modelos generativos são bons para interpretação semântica, mas para extração estrutural baseada em padrões fixos, eles são lentos, caros e frequentemente imprecisos. Um script bem escrito de 30 linhas faz o serviço em milissegundos, sem consumir API key nem exigir conexão com a internet. Para quem precisa de algo mais visual, existem extensões de editor como o VS Code com plugins de regex e o Regex101 para testar padrões em tempo real. Use esses recursos antes de automatizar. Testar no ambiente interativo economiza horas de debugging quando o script começa a falhar com datasets maiores.

O fluxo ideal que recomendo é: primeiro entenda a estrutura dos seus dados, depois construa o pattern gradualmente, teste com amostras representativas e só então escale. Pular etapas é o motivo pelo qual a maioria dos projetos de extração textual dá errado. A paciência no início se paga rapidamente quando o pipeline rodando em produção não quebra toda vez que o formato dos dados muda levemente. Resumindo de forma útil: domine regex básico, conheça seu dados antes de automatizar, e sempre valide com edge cases reais. O resto é questão de tempo e repetição.
Galeria
-

Qual Das Palavras A Seguir é O Mesmo Q Estruir - RETOEDU -

Complete os espaços abaixo com as palavras a seguir - brainly.com.br -
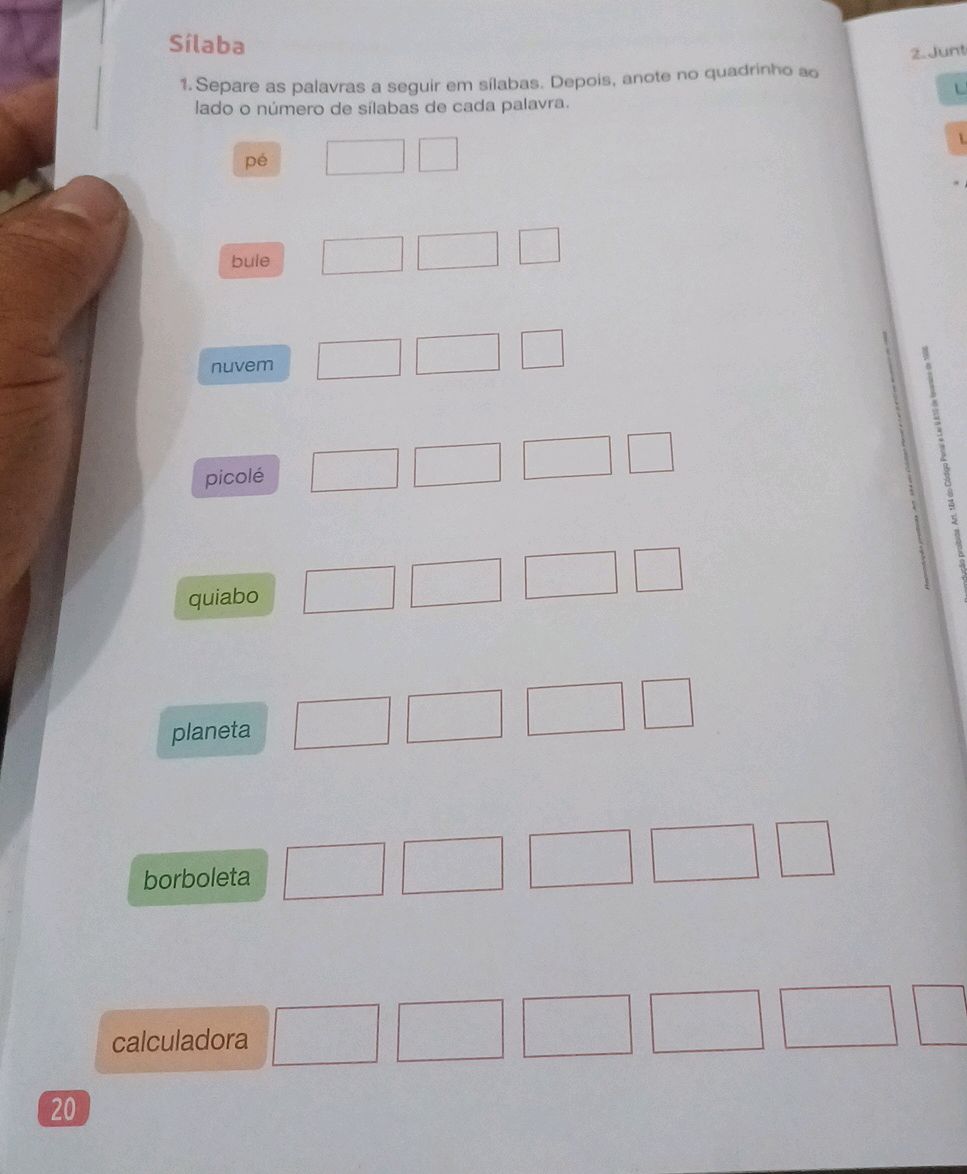
1. Separe as palavras a seguir em sílabas. | StudyX -
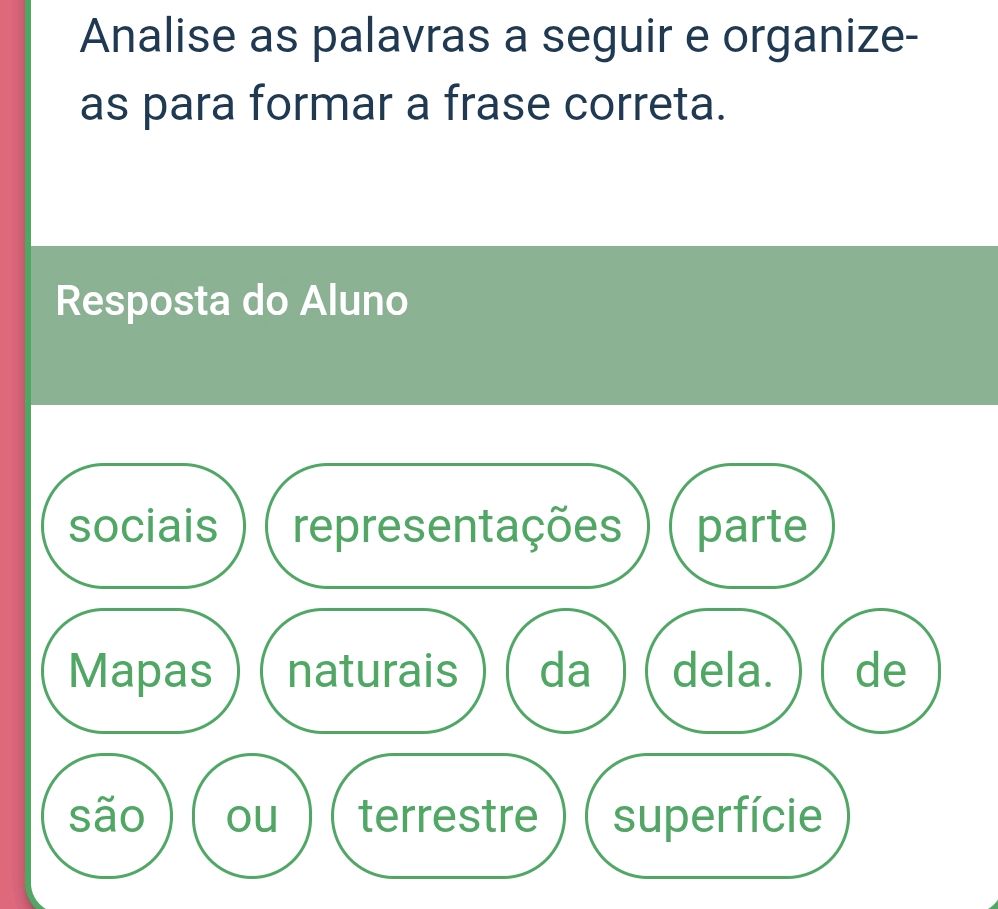
Analise as palavras a seguir e organize-as | StudyX
