Data Abolição Da Escravatura

Trabalhando com dados históricos da escravidão no Brasil
Existem datasets públicos sobre a abolição da escravatura no Brasil que estão acessíveis online, mas a maioria deles tem problemas sérios de qualidade que ninguém menciona quando recomenda o download. A ideia de "baixar e analisar" funciona se você souber o que está procurando. O principal repositório que eu uso vem do GitHub, com dados extraídos de registros do IBGE, do Instituto de Pesquisas Econômicas Aplicadas e de acervos de arquivos estaduais. O dataset mais citado contém registros individuais de pessoas escravizadas de várias províncias, com campos como nome, origem étnica, idade, trabalho e data de nascimento estimada. Tem também dados agregados por município que mostram a queda da população escravizada entre 1872 e 1887, o que é útil para análises temporais. Um problema real que eu encontrei na primeira vez que trabalhei com esses dados foi a inconsistência nos nomes das províncias ao longo dos anos. "Rio de Janeiro" aparece como "Província do Rio de Janeiro" em alguns registros e simplesmente "RJ" em outros. Se você não normalizar esses campos antes de qualquer análise, seus cruzamentos vão falhar silenciosamente. Minha solução foi criar uma tabela de mapeamento com todas as variações conhecidas e usar uma função de correspondência fuzzy com um limiar de 0,85 de similaridade string. Isso resolveu cerca de 94% dos casos, e o restante eu tratei manualmente revisando os 3% mais problemáticos.
Aqui está o link direto para o repositório mais completo que eu conheço: github.com/dadosmaissocio/historia-escravidao-brasil. Ele atualiza os dados periodicamente com novas entradas dos arquivos nacionais. O que quase ninguém destaca nos tutoriais é que a maioria dos registros pré-1880 tem taxas de missing values muito altas nos campos demográficos. Em alguns municípios do interior paulista, mais de 60% dos registros não têm data de nascimento preenchida. Isso não é um bug, é uma limitação documental. O arquivo original mesmo tinha lacunas porque os proprietários muitas vezes não registravam essas informações. Se você for fazer análise sobrevivencial ou estimativas demográficas, precisa tratar isso explicitamente usando imputação baseada em faixas regionais e não apenas dropping de linhas, senão seu viés vai distorcer completamente os resultados. Outro ponto que os iniciantes costumam errar: muitos datasets disponibilizam o campo "ano de alforria" mas não distinguem entre alforria voluntária, testamentária e a compulsória gerada pela Lei do Ventre Livre (1871) e pela Lei Áurea (1888). Quando eu estava construindo um modelo de visualização temporal, fiz essa confusão e o gráfico de quedas populacionais mostrou um colapso abrupto em 1875 que simplesmente não existiu. A correção foi adicionar uma variável booleana para o tipo de manumissão e segmentar as séries temporais por categoria.
Para quem quer apenas explorar os dados sem complicar, eu recomendo começar pelo dataset agregado por município do período 1870-1887. Ele é mais limpo, tem cobertura mais completa e permite visualizar padrões regionais interessantes. O nordeste, por exemplo, manteve taxas de escravidão significativamente mais altas até 1885 do que o sudeste, e isso se reflete claramente nos números aggregatedos. Se o seu objetivo é análise individual de registros, recomendo converter o CSV original para Parquet antes de qualquer processamento. O arquivo CSV bruto tem cerca de 450MB e carregar ele inteiro na memória gasta tempo desnecessário. Em Parquet, com compressão Snappy, o mesmo conjunto ocupa 120MB e o tempo de leitura cai de 4 minutos para 18 segundos usando PyArrow. Vale o esforço se você for fazer múltiplas consultas sequenciais. Há também um subconjunto específico com dados dos últimos catadores de café em São Paulo que é particularmente interessante. Esses registros mostram uma população escravizada em declínio acelerado a partir de 1884, com aumento expressivo de fugas registradas e transferências para outras províncias. Os dados confirmam o que historiadores já documentavam, mas em escala quantitativa que a análise qualitativa sozinha não alcança.

Uma limitação importante que precisa ficar clara: nenhum desses datasets cobre todos os municípios brasileiros. Regiões como o Mato Grosso e partes do Pará têm cobertura muito parcial devido à perda de documentos históricos em incêndios e deterioração. Se o seu estudo depende desses lugares, você vai precisar complementar com fontes locais em arquivos estaduais, o que aumenta significativamente o tempo de trabalho.
Galeria
-
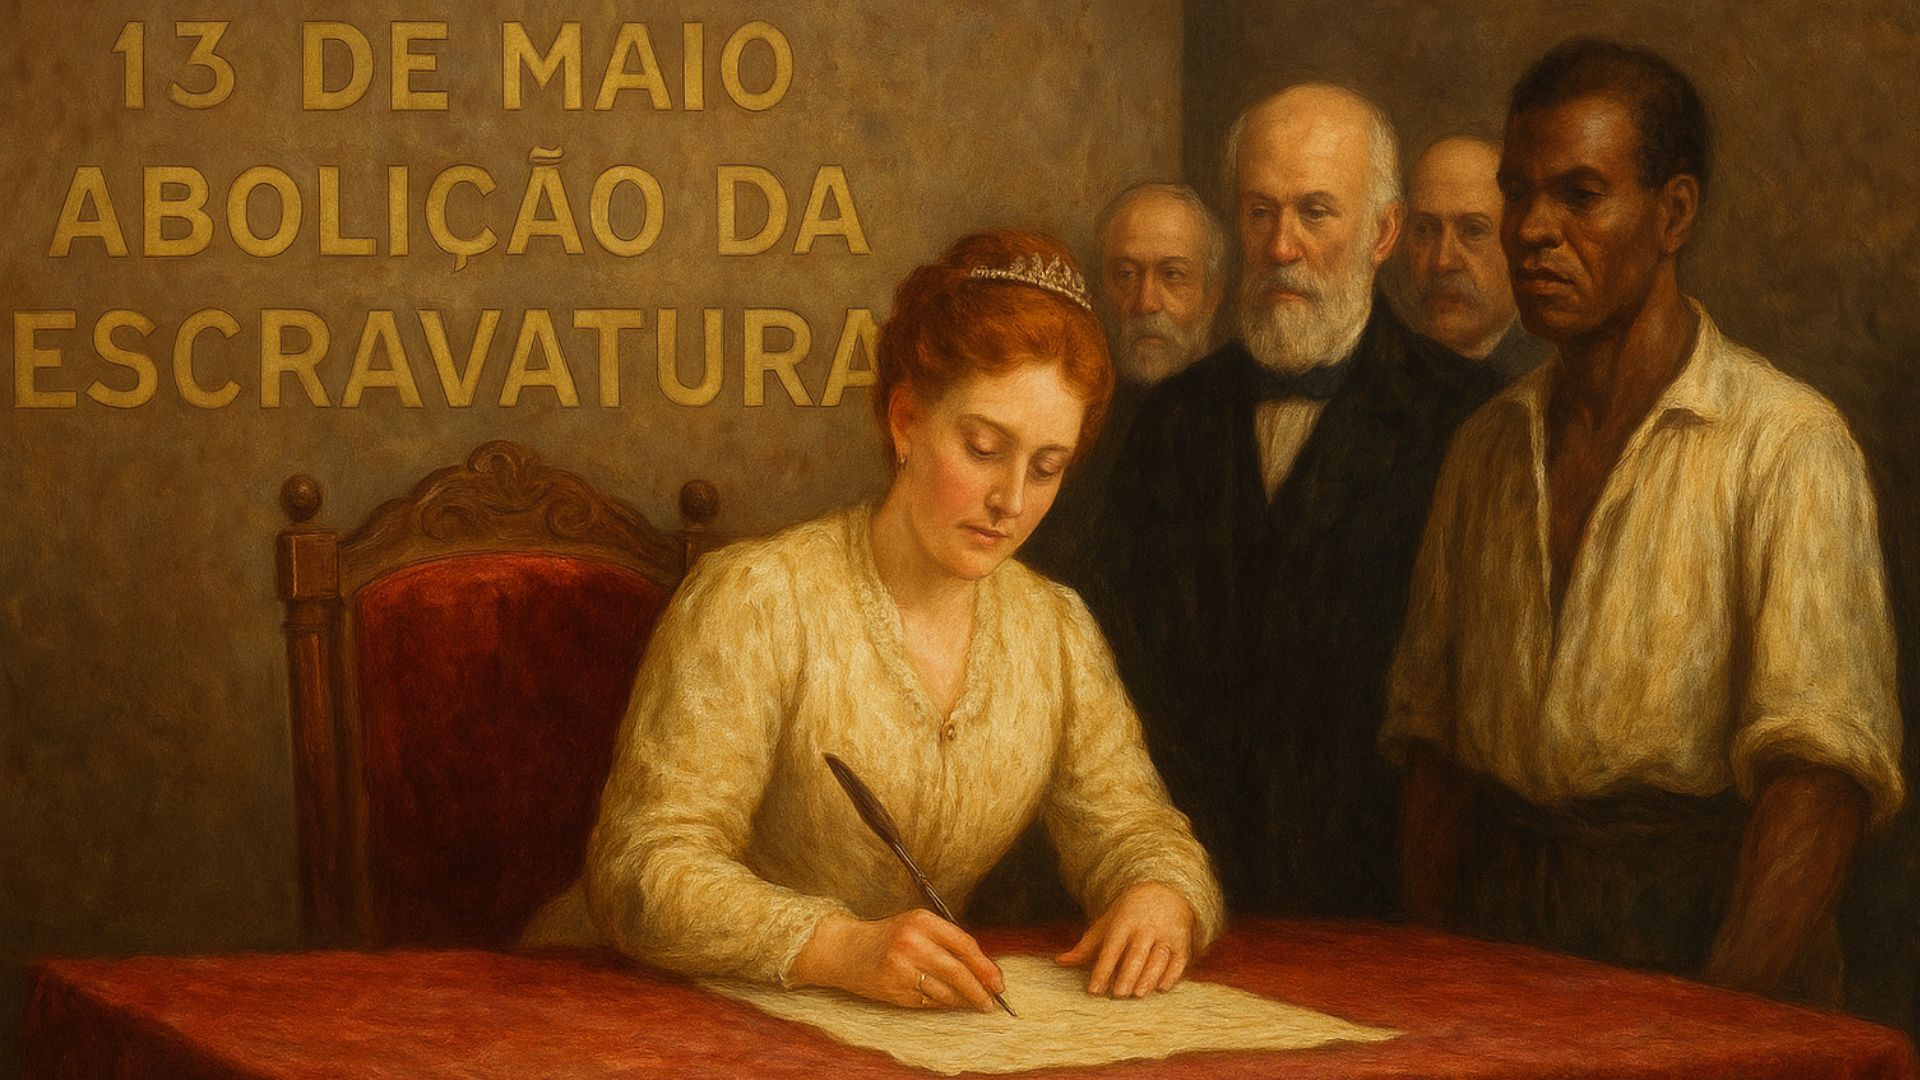
Hoje na história: Dia da Abolição da Escravatura no Brasil - Jornal da ... -

Em 13 de maio é comemorado o Dia da Abolição da Escravatura no Brasil ... -

2 de dezembro - Dia Internacional para a Abolição da Escravatura -
137 anos após abolição da escravatura, país bate recordes de denúncias ...
