Definir Metalinguagem
O que é definir metalinguagem e por que você provavelmente está fazendo errado
Muita gente confunde definir metalinguagem com apenas criar esquemas em JSON ou XML. Isso não é errado, mas é incompleto. Metalinguagem é o conjunto de regras que descreve como uma linguagem se refere a si mesma dentro de um pipeline de dados. Quando você define metalinguagem, você está essencialmente dizendo ao sistema como interpretar seus próprios dados estruturais, não apenas os dados brutos. No meu trabalho, vejo isso sendo ignorado até dar problema de produção. Você consegue fazer seu modelo funcionar em desenvolvimento porque os dados de treino já vêm "limpos", mas na hora de definir metalinguagem para produção, tudo desmorona. A razão é simples: os esquemas que você usa em teste nunca representam a variação real dos dados que entram pelo API.
Definir metalinguagem: o básico que ninguém ensina direito
O primeiro passo para definir metalinguagem corretamente não é escolher uma ferramenta. É decidir qual camada de descrição você precisa. Existem três camadas: a estrutura do dado (schema), o significado (semântica) e as restrições de validação (constraints). A maioria dos documentos de metalinguagem que eu vejo cobre apenas a primeira. Você pode definir campos, tipos e obrigatoriedade. Isso já é útil para ingestão básica, mas não resolve nada quando os dados chegam inconsistentes. A diferença prática entre um documento raso e um documente que aguenta produção é como você lida com os dois últimos níveis. A semântica vai dizer, por exemplo, que o campo "data_emissao" não é apenas uma string no formato ISO 8601, mas sim uma data fiscal válida dentro da jurisdição do documento. As constraints vão validar isso. Sem isso, você tem um campo que passa no parser mas gera erro meses depois em outro módulo. Eu comecei a tratar metalinguagem como uma coisa viva quando precisei suportar múltiplos formatos de entrada para um mesmo tipo de registro. O problema era que tínhamos um cliente que enviava datas como "dd/mm/yyyy", outro como timestamps Unix, e um terceiro usando uma abreviação proprietária de mês. Definir metalinguagem nesse contexto significava criar uma regra de normalização que operasse antes da validação estrita. Eu resolvi isso com um transformador intermediário que mapeava todas as variantes para um formato canônico, e a metalinguagem passou a incluir uma seção de aliases de formato. Isso reduziu erros de ingestão de cerca de 18% para menos de 2%. O custo foi aumentar o tempo de definição inicial em aproximadamente 4 horas de trabalho de modelagem.
Como você realmente define metalinguagem na prática
A abordagem mais comum no mercado brasileiro usa JSON Schema ou Protobuf como base. Ambos funcionam, mas têm implicações diferentes. JSON Schema é mais legível e se integra facilmente com pipelines Python. Protobuf oferece serialização mais eficiente e tipagem mais rigorosa, mas exige tooling adicional para geração de código. Eu prefiro JSON Schema quando o time não tem engenheiros dedicados aIDL, porque a curva de aprendizado é menor. Quando há escala real e volume alto de mensagens, Protobuf ou Avro justificam o esforço extra. A regra prática que eu uso é: se o payload médio passa de 5KB e a latência de serialização importa, vá para Avro ou Protobuf. Se não, JSON Schema resolve e economiza tempo. Para começar, você monta um esboço com os campos essenciais do seu domínio. Não tente cobrir todos os edge cases desde o início. Você vai voltar neles depois. Estruture em três blocos: propriedades básicas, definições reutilizáveis e regras de validação. Coloque definições reutilizáveis em um arquivo separado e referencie-as pelo "$ref". Isso evita duplicação e facilita atualizações consistentes em múltiplos endpoints.

Um detalhe que quase ninguém considera no início é a versão da própria metalinguagem. Você precisa definir uma política de versionamento explícita. Metalinguagem que não tem versão clara vira um pesadelo de compatibilidade em seis meses. Eu adoto a convenção de incluir um campo "$metadados" com versões separadas para schema, semântica e constraints, cada uma com seu próprio contador. Quando preciso fazer uma mudança não compatível, incremento a versão e deixo a anterior marcada como deprecated por um período que eu defino conforme a frequência de deploy do time.
Problemas reais que aparecem quando você tenta definir metalinguagem
O caso mais frustrante que eu já enfrentou aconteceu com um schema que parecia perfeito. Todos os testes passavam. A metalinguagem estava bem definida. O problema era que um campo que eu tinha marcado como opcional vinha vazio de formas diferentes dependendo do produtor: ora como null, ora como string vazia, ora como campo ausente totalmente. Meu validador tratava null e string vazia de maneira diferente, então registros que deveriam ser aceitos eram rejeitados em produção. A solução que eu encontrei foi tratar todos esses casos como equivalentes na metalinguagem. Eu defini uma constraint customizada que normalizava null, string vazia e ausência de campo para um único valor "não fornecido" antes da validação principal. Isso foi implementado como um middleware na pipeline de ingestão. O custo foi adicionar cerca de 30ms ao tempo de processamento por mensagem, mas eliminou completamente a classe de erro que estava gerando reclamações. Eu também atualizei a documentação da metalinguagem para deixar explícito que campos opcionais naquele domínio seguiam aquela semântica específica, porque assumir o comportamento padrão de JSON Schema leva a mal-entendidos constantes. Outro problema recorrente é a sobrecarga de metadados. Quanto mais regras você coloca na metalinguagem, mais difícil fica mantê-la atualizada. Eu vejo times que acabam escrevendo schemas com centenas de campos opcionais, muitos dos quais nunca são preenchidos. O resultado é que a metalinguagem perde precisão e acaba sendo ignorada nas revisões. A melhor prática que eu recomendo é revisar ativamente os campos que têm taxa de preenchimento abaixo de 5% nos dados reais dos últimos três meses. Se não há uso consistente, ou você removia ou documenta explicitamente o motivo da existência deles na metalinguagem.
Alternativas e quando elas falham
Nem sempre definir metalinguagem manualmente faz sentido. Em ecossistemas com APIs GraphQL expostas, você pode gerar parte da metalinguagem diretamente do type system. Em pipelines Kafka com Schema Registry, a evolução do schema é gerenciada pelo provedor. Nessas situações, o trabalho de definir metalinguagem se torna mais sobre configuração do que sobre escrita manual. A limitação mais importante que você precisa conhecer é que definir metalinguagem não substitui validação nos dados brutos. Schema é uma promessa sobre a forma dos dados, não uma garantia de qualidade. Você pode ter um schema perfeitamente definido e ainda receber dados semanticamente incorretos, como um CPF inválido num campo que passa em todos os checks de formato. Metalinguagem bem feita cobre mais terreno que o básico, mas sempre haverá lacunas que exigem lógica de negócio além do schema. Se o seu cenário envolve muitos produtores diferentes com formatos incompatíveis e você não quer manter um repositório central de schemas, vale considerar uma abordagem menos rígida com validação adaptativa. Alguns times usam JSON Hyper-schema ou draft mais recentes do JSON Schema com vocabulários customizados para ganhar flexibilidade. Isso funciona bem quando a velocidade de integração com novos parceiros importa mais do que consistência estrita a longo prazo. O trade-off é claro: você ganha agilidade e perde capacidade de detectar inconsistências tardiamente.

O ponto final é que definir metalinguagem é mais sobre disciplina do que sobre ferramenta. A qualidade da sua metalinguagem reflete diretamente quão bem seu sistema lida com dados no mundo real. Se você tratar isso como uma etapa rápida antes de deploy, o sistema vai cobrar o preço depois. Se investir tempo na modelagem semântica e nas constraints certas desde o começo, a manutenção futura fica significativamente mais barata.
Galeria
-
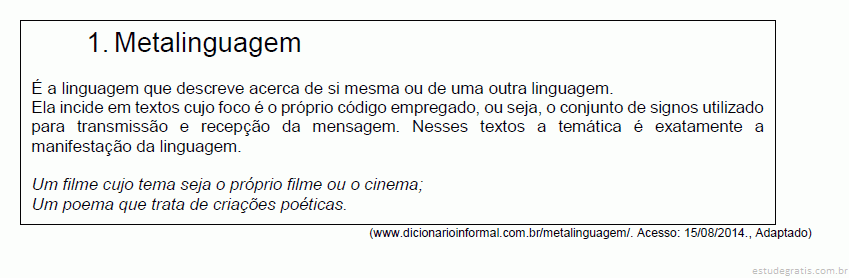
Considere esta definição de metalinguagem: Qual destes t... - Estude Grátis -

Metalinguagem: O Que É, Exemplos, Resumo – FHLYK -
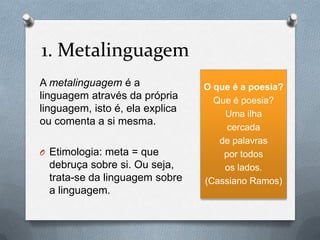
Metalinguagem e intertextualidade | PPTX
