Descreva Alguns Tipos De Dados Que Podem Ser Vinculados

O que você realmente pode conectar numa rede de dados
Vincular dados não é um conceito mágico. É basicamente sobre decidir quais partes da sua informação merecem um identificador permanente e quais ficam como valores soltos. Na prática, a maioria das pessoas erra na hora de escolher o que vira URI e o que vira literal. Já perdi tempo num projeto onde todo campo era string, o que transformou um grafo simples em uma bagunça que ninguém conseguia consultar direito. Existem categorias claras no modelo RDF que definem exatamente o que pode ser vinculado. Não precisa inventar nada. O padrão já resolve isso. URIs (Uniform Resource Identifiers) — São os itens que podem ser vinculados diretamente. Uma URI é qualquer coisa que tem uma identidade própria na web. Exemplo: http://example.org/pessoa/joao-silva. O ideal é que a URI seja persistente e resolvida, ou seja, você possa acessá-la e receber informações sobre aquilo. Se a URI não responde, o vínculo fica órfão e qualquer consulta falha sem aviso. Use URIs para entidades do mundo real: pessoas, lugares, organizações, conceitos de taxonomias.
Literals (Valores literais) — São os dados atômicos que ficam anexados a um nó por meio de uma propriedade. Um literal pode ser uma string, número, data, booleano. Exemplo: "1985-03-12"^^xsd:date. Literais não são vinculáveis por si só — você não cria um outro enlace apontando para um literal. Eles são folha da árvore. A pegadinha aqui é que muitos iniciantes tentam transformar dados relacionais como endereços ou telefones em URIs quando deveria ser literal, e acabam criando grafos inutilizáveis. Blank Nodes (Nós anônimos) — Estruturas que não têm URI própria. Servem para representar algo complexo que precisa existir temporariamente dentro do grafo. Um exemplo comum é um endereço com várias propriedades (rua, cidade, CEP) que você não quer dar URI separada. O problema é que blank nodes não sobrevivem a exportações e importações entre sistemas. Se você precisa compartilhar o dado, use URI. Se é estrutura interna só, blank node funciona. Classes e Propriedades (Vocabulário) — Isso é o que dá significado ao vínculo. RDF permite definir classes como foaf:Person ou schema:Organization, e propriedades como foaf:name ou schema:founder. Vincular usando vocabulários conhecidos é o que faz o dado ser interoperável. O erro mais frequente é criar suas próprias classes e propriedades sem consultar ontologias existentes. Resultado: três projetos com o mesmo conceito, três URIs diferentes, zero interconexão.
Como fazer na prática
Pegue seus dados, separe o que é entidade do que é atributo. Entidade recebe URI. Atributo vira literal ou vínculo para outra URI. Monte triplas simples: sujeito – predicado – objeto. Use RDFLib em Python para validar. Um script rápido de validação com rdflib checa se todas as triplas têm URI válida como sujeito e predicado. Isso evita que gráficos fiquem com nós órfãos. Para dados relacionais existentes, a conversão mais segura é mapear cada tabela com chave primária para uma URI baseada em padrão como http://seusite.com/dados/{tabela}/{id}. Campos textuais viram literais com tipo apropriado. Campos que referenciam outras tabelas viram URIs ligadas a outras entidades. Datas sempre usam xsd:date. Números, xsd:decimal ou xsd:int. Evite deixar tudo como string genérica. Se estiver importando CSVs, leia coluna por coluna e classifique cada uma antes de gerar o RDF. Coluna com nome de pessoa URI + foaf:name. Coluna com valor monetário literal xsd:decimal + propriedade schema:price. Coluna com data de nascimento literal xsd:date + propriedade schema:birthDate. Essa classificação manual na entrada evita retrabalho enorme depois.

Problema real que encontrei
Em um projeto de integração de bases governamentais, os dados de estabelecimentos vinham com CNPJ como string, mas sem padronização. Uns com máscara, outros sem, alguns com zeros à esquerda removidos. O vínculo direto falhava porque duas URIs para o mesmo CNPJ eram tratadas como entidades diferentes. A solução foi criar uma camada intermediária de normalização: remover tudo que não fosse dígito, padronizar para 14 caracteres, e gerar a URI canônica a partir desse valor limpo. Depois disso, os dados de múltiplas fontes começaram a se conectar corretamente no grafo. Sem a normalização, o grafo tinha duplicação massiva e consultas retornavam resultados incompletos. Vincular dados não é solução para tudo. Se seus dados mudam com frequência e não têm identidade estável, forçar URIs gera manutenção excessiva. Dados temporários, logs, métricas em tempo real — nesses casos, banco relacional ou time-series é mais adequado. Vinculação exige que as entidades tenham persistência. Se você precisa de velocidade de escrita alta, o modelo triplas vai sofrer. RDF é otimizado para leitura e integração, não para carga massiva. Outro ponto: a qualidade do vínculo depende da qualidade do vocabulário. Se você usar propriedades mal definidas ou sinônimos não mapeados, os vínculos vão parecer funcionais mas vão falhar em consultas cruzadas. Sempre verifique se a propriedade que está usando já existe em vocabulários consolidados antes de criar uma nova.
Ferramentas úteis
RDFLib para Python é o mais prático para quem está começando. Protégé para modelagem visual de ontologias. Apache Jena com ARQ para consultas SPARQL mais robustas. Para validação de URIs, use a biblioteca pyrobokop ou scripts simples com urllib testando response code nas URIs do grafo. Nada disso substitui o hábito de revisar manualmente as triplas geradas nos primeiros meses. A regra básica continua sendo a mesma desde o início: identifique entidades, dê URI para elas, use literais para valores, e conecte usando predicados de vocabulários conhecidos. O resto é detalhes de implementação.
Galeria
-
Os tipos de dados primitivos | Fernando Araujo | Informática Básica | DIO -
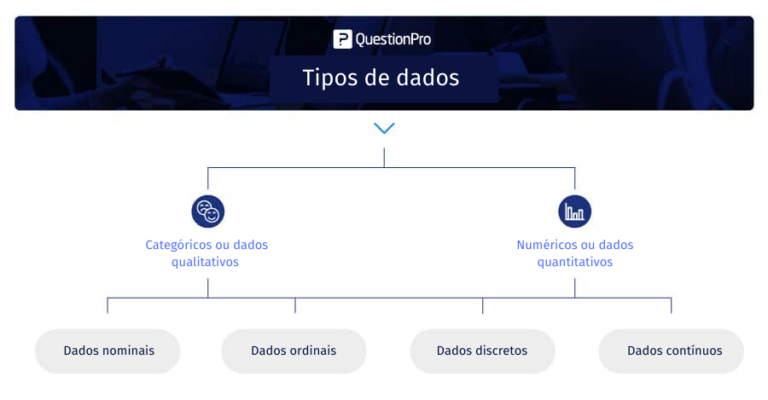
Quais são os tipos de dados estatísticos? -

O que é um tipo de dados e por que ele é importante? - ABAS System -

Variáveis, Tipos de Dados e Operadores – brbots

